


Documentación
Introducción
El baile celestial de los astros en el sistema solar ofrece cada cierto tiempo espectáculos únicos y singulares, como el fenómeno del eclipse total que se pudo contemplar en la península ibérica este año, y que se podrá ver de nuevo en 2027 y 2028. Durante un eclipse total, la Luna se interpone entre la Tierra y el Sol, ocultando al astro rey y proyectando durante unos minutos una sombra sobre una parte de la superficie terrestre.
El eclipse total del 12 de agosto de 2026 tuvo su comienzo hacia las 20h30 horas (GMT+01:00), cubriendo de penumbra desde Galicia hasta las Islas Baleares a lo largo de la hora y media de duración del eclipse.
El Centro Nacional de Información Geográfica (CNIG) ha puesto a disposición del público unos conjuntos de datos que ofrecen un amplio espectro de información astronómica relativa tanto al eclipse del pasado agosto como a los que se van a producir sobre la península ibérica durante los próximos dos años.
Estos conjuntos de datos incluyen información sobre la visibilidad por el propio relieve del terreno a la hora del eclipse, la duración del eclipse en cada punto de la geografía española, el nivel de oscurecimiento o la elevación del Sol en el punto máximo del eclipse, así como la sombra proyectada por la Luna en su trayecto por delante del Sol.
En este ejercicio accederemos a los conjuntos de datos del CNIG y abriremos los ficheros tipo .TIFF y .GPKG con toda la información relativa al eclipse, y en concreto con todo lo relacionado con las zonas de sombra, tanto en lo referente a la visibilidad por efecto del relieve en la península, como en lo que respecta a la zona de sombra en sí debido al eclipse total.
Una vez hayamos accedido a los datos, delimitaremos nuestro análisis a una zona concreta sobre la visibilidad por relieve, recortaremos los datos originales con el perímetro de un municipio, exportaremos el resultado en formato GeoJSON y, haciendo uso de éste, seremos capaces de crear diferentes tipos de mapas con diversas herramientas útiles e intuitivas tales como KeplerGL, GoogleEarth, Leaflet o D3.js.
Datos para el ejercicio
Los datos disponibles para realizar este ejercicio se encuentran accesibles en el Catálogo de datos abiertos de datos.gob.es y constan de tres ficheros con información relevante para describir y caracterizar el eclipse. En concreto encontramos:
- Sombras del terreno: fichero donde se describe la visibilidad por relieve en una malla de puntos que cubre la península ibérica y la parte occidental del norte de África.
- Curvas de nivel: fichero que contiene la duración, el oscurecimiento máximo y las curvas de penumbra proyectadas desde la Luna sobre la Tierra.
- Efemérides: fichero que alberga las efemérides del eclipse, tales como elevación, azimut, salida y puesta de sol, así como inicio y final del eclipse.
En este ejercicio nos centraremos en los dos primeros , ya que contienen información sobre la sombra proyectada tanto por el relieve como por la Luna sobre la península ibérica.
Adicionalmente, recurriremos igualmente al Catálogo de datos para obtener el perímetro en formato SHP de algún municipio que nos permita analizar en detalle la sombra por relieve. De esta forma completaremos el acceso y lectura de tres formatos de datos georreferenciados diferentes:
- TIFF: formato popular para información gráfica de alta resolución que tolera altos grados de compresión sin pérdida de información y que por lo tanto es muy manejable. Las siglas hacen referencia a Tagged Image File Format.
- GPKG: acrónimo de GeoPackage. Este formato se utiliza en sistemas de información geográfica para almacenar datos tanto en modo ráster como modo vectorial.
- SHP: formato de datos vectorial que contiene localizaciones geométricas, muy utilizado también en sistemas de información geográfica. Contiene exclusivamente puntos, líneas o polígonos y se compone de varios ficheros que contienen índices o atributos.
El formato SHP lo necesitaremos para disponer del perímetro de un municipio y así poder limitar nuestro estudio a una zona en concreta de interés. Dentro del Catálogo de datos tenemos perímetros municipales en el País Vasco en este conjunto de datos. Dentro de este fichero SHP podremos elegir uno de esos municipios ya que vienen caracterizados por su nombre.
Proceso de desarrollo
En esta sección veremos las diferentes etapas que hay que cubrir para llegar desde el fichero comprimido original hasta desplegar mapas en diversas plataformas con la información relevante del eclipse total. El código de lectura y tratamiento de datos se ha realizado en Python y se puede consultar en Github, en Google Colab y, el resultado, en Observable. El repositorio en Github se encuentra en el siguiente enlace:
Accede al repositorio del laboratorio de datos en GitHub
En Google Colab tenemos dos notebooks. El primero nos permite extraer y representar las zonas de sombra por el relieve natural a la hora del eclipse, mientras que el segundo nos permite obtener y visualizar las zonas de sombra creadas por el eclipse en sí:
Accede a los notebooks de Google Colab
Por último, en Observable podemos consultar el código que nos permite crear los mapas con la información extraída tanto en Leaflet como en D3.js:
Accede a los notebooks de Observable
1. Visibilidad por relieve
El primer paso de este ejercicio consiste en identificar puntos en los cuales el eclipse fue visible en condiciones ideales sin ningún tipo de nubosidad, circunstancia que no fue completamente ideal el día del eclipse, sobre todo en zonas costeras donde el calor generó brumas y niebla a última hora de la tarde.
Los datos que analizamos hacen referencia a los puntos afectados por el propio relieve y orografía de la península ibérica. Los datos ofrecidos en formato .TIFF detallan aquellos puntos donde la visibilidad fue total, parcial o nula por efecto del relieve asignando cuatro valores:
- Valor 0: el terreno impide ver el eclipse.
- Valor 1: el terreno permite ver la mitad superior del Sol.
- Valor 2: el terreno permite ver la mitad superior y parte de la inferior del Sol.
- Valor 3: el terreno permite ver en Sol en su integridad.
1.1 Lectura del fichero TIFF
Para la lectura del .TIFF utilizaremos la librería Rioxarray de Python, que nos permite volcar el contenido de un TIFF en un xarray, una estructura de datos ampliamente utilizada para trabajar con información georreferenciada. Una vez cargados los datos y formateados como xarray, es posible recurrir a la librería Matplotlib para crear un mapa e inspeccionar el ámbito geográfico que comprende, mostrado a continuación.
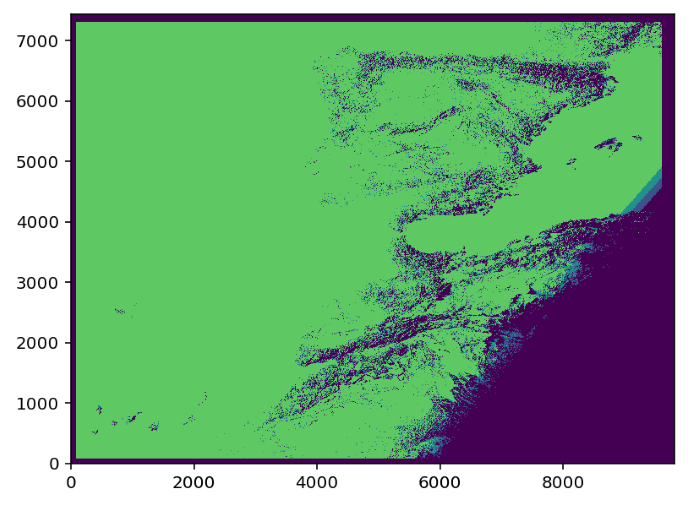
Figura 1: Mapa de visibilidad por relieve del Sol el 12 de agosto de 2026. Fuente: elaboración propia -datos.gob.es.
Los datos, como se mencionaba en la introducción, abarcan toda la península ibérica, parte de Francia y la zona occidental del norte de África, de forma que las Islas Baleares y las Canarias forman parte de un único conjunto de datos. Se puede observar en este punto cómo las zonas de sombra se relacionan de forma intuitiva con la orografía de cordilleras y mesetas, así como con la puesta de sol y la sombra que induce en el levante a la hora del eclipse.
Otra información relevante que podemos observar es la resolución de este conjunto de datos. En los ejes x e y se puede ver el número de puntos aproximado en cada una de las dimensiones, lo que se traduce en una alta resolución orientada a obtener el mayor detalle posible.
Dado que nuestro objetivo es desarrollar mapas y visualizaciones que puedan ser publicadas en la web, así como el tratamiento ágil de datos, nos centraremos en una zona en concreta, tomando como muestra la extensión de un municipio. De este modo, los ficheros de salida son relativamente ligeros y siempre por debajo de los 10Mb, permitiendo que los navegadores actuales sean capaces de procesarlos de forma rápida y eficiente.
1.2 Perímetro de estudio
Utilizando los datos sobre los perímetros municipales en el País Vasco, procedemos a la lectura del fichero SHP y a su estructuración en formato GeoPandas, una librería de Python que permite crear geometrías asociadas a una serie de propiedades y atributos de forma intuitiva.
Para la realización de este ejercicio seleccionamos el municipio de Amurrio, ya que presenta una orografía diversa que nos permite tener todo el espectro posible de visibilidades. En la siguiente imagen podemos observar los límites del municipio utilizando la librería Matplotlib de Python, contextualizados en coordenadas de longitud y latitud.
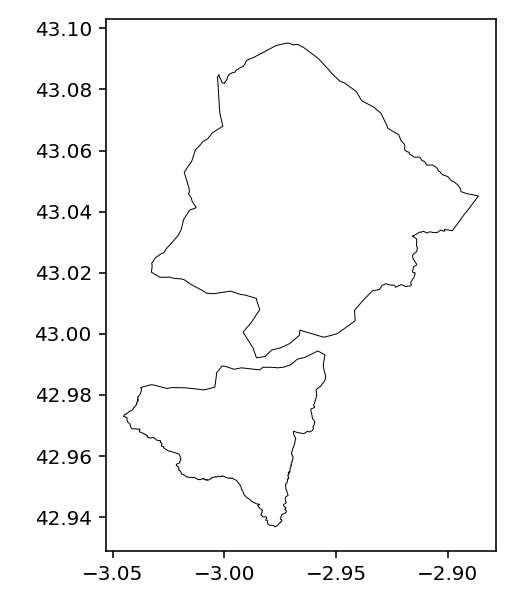
Figura 2: Mapa del perímetro del municipio de Amurrio en el País Vasco a partir del SHP accesible como datos abiertos. Fuente: elaboración propia -datos.gob.es.
1.3 Recorte del perímetro
Gracias a la librería Shapely de Python es posible recortar un xarray con la información municipal contenida en el GeoPandas. Una vez recortado, utilizamos Matplotlib para representar el subconjunto de datos, donde observamos la variedad de valores y, por tanto, la diversidad de lugares con visibilidad total, parcial o nula en una región relativamente pequeña dentro de lo que es la extensión de la península ibérica. A continuación observamos el patrón de una zona dominante de buena visibilidad y de otras de visibilidad más pobre.
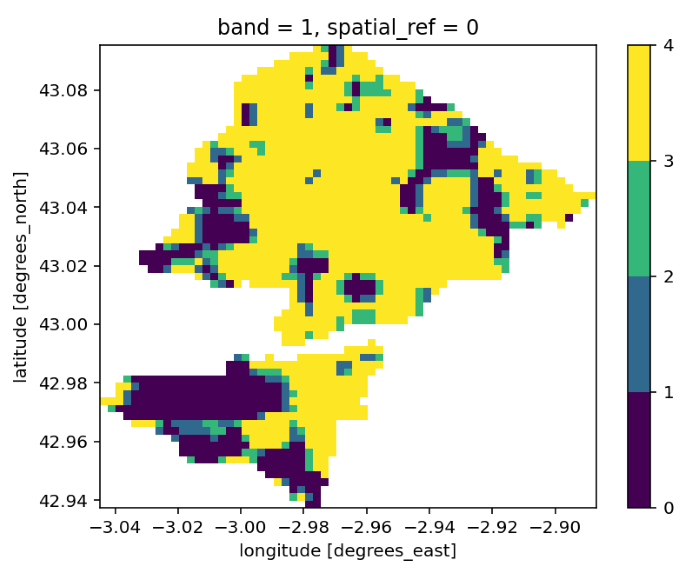
Figura 3: Mapa de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
1.4 Exportar como GeoJSON
Una vez tenemos un conjunto de datos pequeño y manejable, podemos exportar cada uno de los puntos en formato GeoJSON. Este formato es muy versátil a la hora de exportar datos y utilizarlo en un gran número de aplicaciones y herramientas, a diferencia del TIFF original que suele estar restringido a programas específicos de sistemas de información geográfica.
1.5 Visualización en mapas del GeoJSON
El fichero GeoJSON resultante nos permite presentar la información en aplicaciones de visualización geográfica como KeplerGL o GoogleEarth, así como integrarla de forma sencilla en proyectos de visualización utilizando Javascript. Para ello, pueden utilizarse bibliotecas como Leaflet o D3.js, requiriendo únicamente unas pocas líneas de código.
La primera herramienta que utilizaremos para visualizar las zonas de sombra por relieve va a ser la herramienta KeplerGL, que ya introdujimos en un ejercicio anterior sobre de datos geoespaciales. Para ello, basta con arrastrar el fichero al interfaz de carga de archivos, tras lo cual se genera de forma automática una representación por polígonos asociado a cada punto. En la configuración de la visualización, vinculamos el color a la variable shadow y establecemos la escala tipo Quantize para distribuir los valores de forma homogénea a lo largo del intervalo. Finalmente, seleccionamos una capa base de imágenes satelitales para contextualizar la información y facilitar la identificación del relieve subyacente que da lugar a las zonas de mayor y menor visibilidad, tal y como vemos en la siguiente imagen.
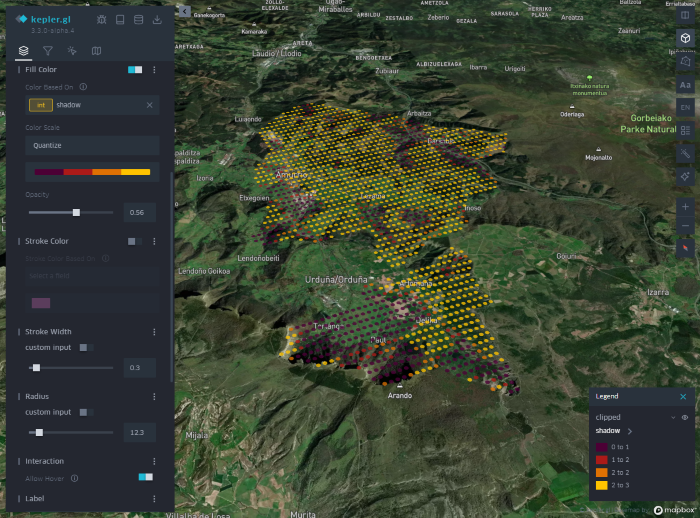
Figura 4: Mapa en KeplerGL de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
La siguiente herramienta en la cual podremos visualizar el resultado de un GeoJSON es Google Earth. En su entorno de desarrollo podemos cargar el fichero GeoJSON, seleccionar la escala de colores y configurar distintos parámetros de visualización mediante el cuadro de diálogo correspondiente. A pesar de ser mucho más limitado en customización que KeplerGL, GoogleEarth cuenta con una precisa distribución tridimensional que permite asociar cada punto a su equivalente en el mapa, pero esta vez incorporando la altitud del punto. El efecto de distribuir puntos en altura dota de más realismo al mapa, tal y como se ilustra a continuación.
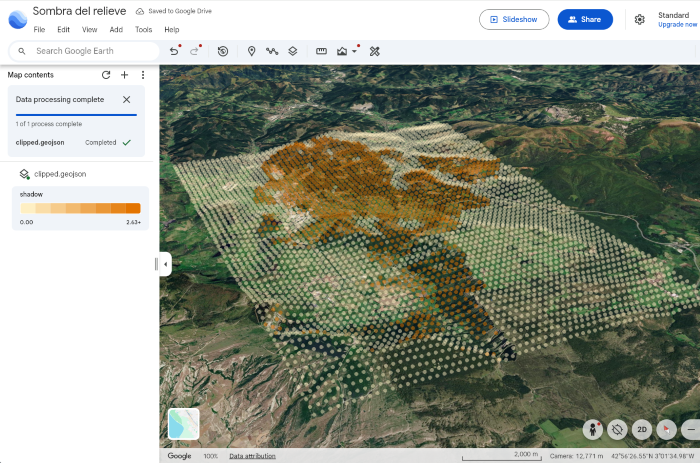
Figura 5: Mapa en GoogleEarth de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
Finalmente, el fichero GeoJSON podemos incorporarlo a un frontal web donde la librería Leaflet permite crear una cartografía en la que poder proyectar los puntos contenidos dentro del archivo de datos. En la siguiente imagen podemos ver el resultado, muy similar a los casos anteriores, donde sobre una imagen satelital tenemos los puntos que hemos extraído del TIFF originalmente. Este tipo de mapas podemos incorporarlos a frontales web con un alto grado de customización, superando las posibilidades ofrecidas por herramientas como KeplerGL o GoogleEarth. El notebook con el código de Javascript para Leaflet se puede consultar en Observable.
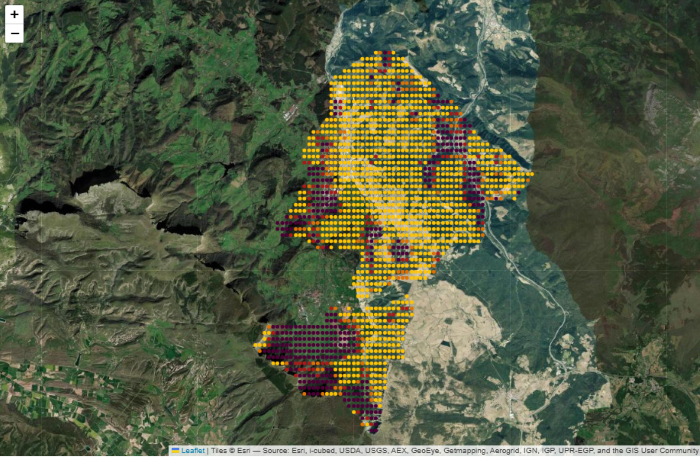
Figura 6: Mapa de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio en Leaflet. Fuente: elaboración propia -datos.gob.es.
2. Zona de sombra proyectada del eclipse
Una vez que hemos identificado los puntos de la geografía ibérica en los cuales es posible ver el eclipse en su plenitud, pasamos a visualizar la trayectoria y extensión de la zona de sombra que proyecta la Luna sobre la superficie terrestre.
Para ello utilizamos el fichero .GPKG del CNIG, que incluye una capa dedicada a la localización y extensión de las zonas de sombra a determinados intervalos de tiempo.
2.1 Lectura de .GPKG
La lectura del archivo .GPKG la realizaremos con la ayuda de la librería GeoPandas de Python. En primer lugar, extraemos los nombres de las diferentes capas contenidas en el geopackage, siendo éstas definidas por las primeras dos palabras: oscurez_standard, moon_shadow y durtot_standard.
La capa que nos interesa es moon_shadow, así que volcamos el contenido de esa capa en un dataframe de GeoPandas. Para tener una perspectiva global de todo el recorrido de la sombra a través de la península, unimos todas las geometrías de cada intervalo temporal en una única forma geométrica.
2.2 Zona de sombra agregada
Con la ayuda de la librería Cartopy podemos crear un sencillo mapa de la extensión de todo el recorrido del eclipse sobre la península. A continuación se muestra el recorrido contextualizado por las coordenadas de latitud y longitud.
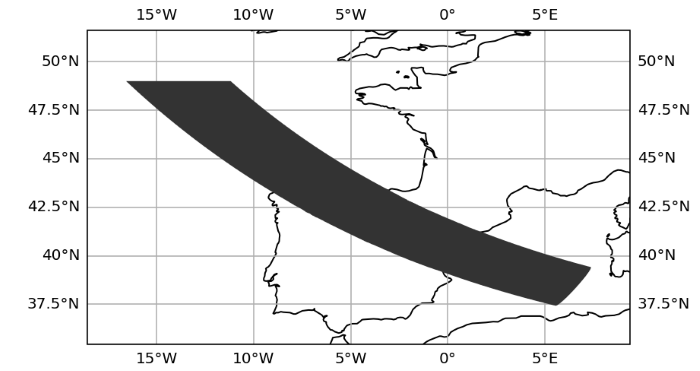
Figura 7: Mapa de la zona de sombra agregada creado por el eclipse desarrollado en Cartopy. Fuente: elaboración propia -datos.gob.es.
Al igual que en el caso de las zonas de sombra por relieve, nos interesa focalizar sobre el detalle, en este caso un intervalo temporal determinado. Para ello elegimos un tiempo concreto de la duración del eclipse y creamos un mapa específico para ese momento, lo cual nos permite ver con gran realismo qué forma puede llegar a tener la zona de sombra sobre la Tierra. En la siguiente imagen se muestra la zona de sombra para t = 200, unos 20 minutos tras el comienzo del eclipse.
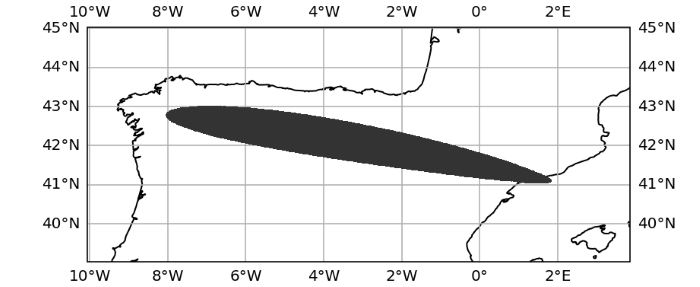
Figura 8: Mapa de la zona de sombra a los 20 minutos del comienzo del eclipse creado en Cartopy. Fuente: elaboración propia -datos.gob.es.
2.3 Exportar como GeoJSON
Una vez tenemos seleccionado un momento y zona de sombra determinados, podemos exportar esa geometría en formato GeoJSON para poder utilizar otras herramientas más sofisticadas o para incorporarla a un entorno web. Para ello, redefinimos el orden de las coordenadas de los puntos que forman la geometría. Este paso, poco intuitivo, nos permite garantizar la correcta definición de la forma de la geometría en Javascript. Hay que tener en cuenta que en una forma geométrica cerrada, el interior puede ser considerado el exterior y viceversa. Forzando el orden de los puntos que se sigue para crear una forma geométrica cerrada garantizamos la definición de lo que es exterior e interior, facilitando así el posterior coloreado de la geometría en Javascript.
2.4 Visualización en mapas del GeoJSON
Al igual que en la sección sobre las zonas de sombra por relieve y orografía, incorporamos el fichero GeoJSON a diferentes herramientas y métodos de cartografía en Javascript para explorar diferentes formas de visualización, sacando partida de las ventajas de cada una de ellas.
En KeplerGL podemos subir el archivo GeoJSON de salida y crear una forma poligonal con todos los puntos contenidos en el fichero. El resultado es la zona de sombra proyectada sobre un mapa que podemos modificar tal y como explicamos en un ejercicio de datos previo. El resultado se muestra a continuación:
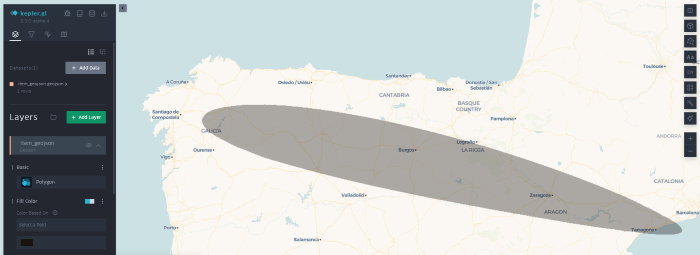
Figura 9: Mapa de las zonas de sombra creadas por el eclipse en KeplerGL. Fuente: elaboración propia -datos.gob.es.
Alternativamente podemos utilizar Google Earth y aprovechar su proyección cartográfica en forma de esfera para resaltar el efecto que produce el eclipse a escala planetaria y donde las formas geométricas curvas y distorsionadas cobran más realismo y sentido. Un eclipse no deja de ser el resultado de la interferencia de la luz entre dos esferas proyectada sobre otra esfera. En este contexto las proyecciones "planas" pierden la coherencia de una proyección esférica. El resultado se puede ver en la siguiente imagen.
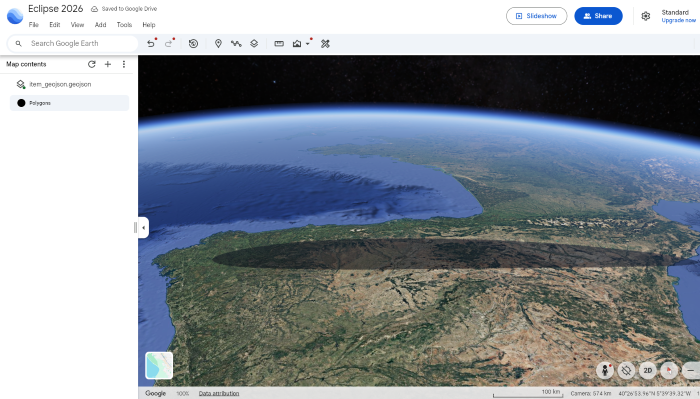
Figura 10: Mapa de las zonas de sombra creadas por el eclipse en Google Earth. Fuente: elaboración propia -datos.gob.es.
A la hora de integrar estas visualizaciones en un entorno web, librerías de Javascript como Leaflet o D3.js son de gran ayuda, ya que con unas pocas líneas de código se puede crear un mapa con los polígonos contenidos en un GeoJSON, y personalizar los estilos de ese polígono de forma fácil e intuitiva. En el caso de Leaflet, muestra a continuación la extensión de la zona de sombra sobre una proyección satelital. El código correspondiente para la creación de este mapa se encuentra en un notebook de Observable:
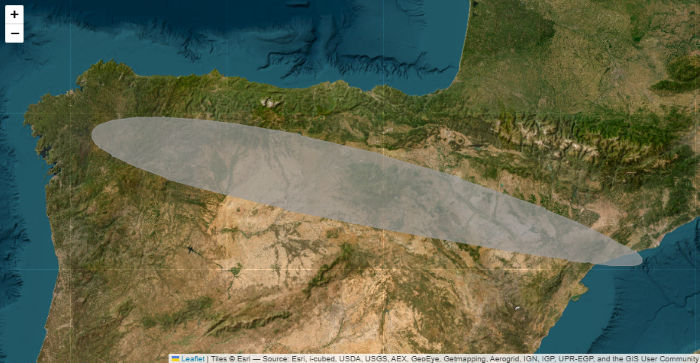
Figura 11: Mapa de las zonas de sombra creadas por el eclipse en Leaflet. Fuente: elaboración propia -datos.gob.es.
En el caso de D3.js, aprovechamos la extensa librería de proyecciones cartográficas para crear un globo terráqueo y, al igual que en el caso de Google Earth, dar esa perspectiva planetaria que resulta, sin duda, más realista para comprender la naturaleza de un eclipse y el efecto combinado de las geometrías esféricas implicadas. En la siguiente imagen se puede ver el trazo de la zona de sombra elegido para este ejercicio. Para replicar este mapa se puede utilizar el código del notebook de Observable:
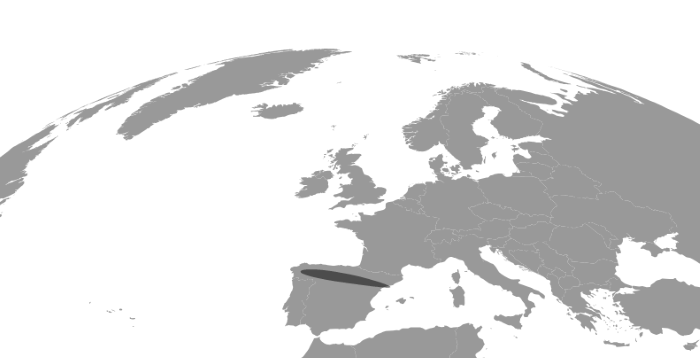
Figura 12: Mapa de las zonas de sombra creadas por el eclipse creado con D3.js. Fuente: elaboración propia -datos.gob.es.
Lecciones aprendidas
En este ejercicio de datos hemos aprendido a leer un fichero .TIFF o .GPKG, extraer la información relevante, volcar los datos sobre estructuras como xarray o GeoPandas, hacer un mapa preliminar sin salir de Python, exportar los datos en formato GeoJSON y, finalmente, explorar diversas herramientas dependiendo del entorno que necesitemos para el proyecto de visualización. De esta manera, hemos conseguido:
- Adquirir familiaridad con diferentes formatos de información geográfica tales como .TIFF, .GPKG o .SHP. Esto nos permite aprovechar la riqueza en formatos disponibles, tener la misma información geográfica representada en diferentes formas y, por lo tanto, habilitar el uso de una plétora de herramientas para representar los datos.
- Leer ficheros .TIFF a través de Python tanto para su representación gráfica como para su transformación a formatos válidos para crear visualizaciones en la web. En este proceso aprendemos, además, a realizar conversión de datos geográficos, pasando de ficheros de entrada .TIFF y .GPKG a ficheros de salida en un formato manejable y adecuado a entornos web como es el formato GeoJSON.
- Delimitar zonas de interés a partir de archivos con una amplia cobertura espacial, para centrarse en poblaciones o regiones precisas y poder transmitir un mensaje concreto a la hora de comunicar información relevante. En concreto, aprendemos a recortar información georreferenciada en formato TIFF sobre un contorno específico como pueden ser los límites de un municipio y a descartar aquellos datos que estén fuera de ese contorno.
- Utilizar las librerías Cartopy o Matplotlib de Python para hacer una visualización preliminar de la información contenida en un fichero TIFF.
- Crear un globo terráqueo donde se pueda visualizar la zona de sombra de un eclipse utilizando Google Earth o D3.js, aportando una visualización con un mayor rigor astronómico.
- Explorar distintas alternativas de visualización gracias a la diversidad de herramientas disponibles. En concreto, hacemos un recorrido por todo el espectro de complejidad de visualizaciones espaciales, desde herramientas intuitivas como GoogleEarth, con la cual el público ya está familiarizado gracias a GoogleMaps, hasta herramientas de código como Python o Javascript a través de D3.js.
Conclusiones
Este ejercicio de datos nos ha permitido pasar de formatos utilizados habitualmente en entornos profesionales de sistemas de información geográfica a otros más manejables para poder crear nuestros propios mapas, bien con la ayuda de aplicaciones populares como KeplerGL o GoogleEarth, bien con librerías de Javascript para su integración en proyectos web.
Asimismo, hemos visto cómo con unas pocas líneas de código podemos manipular los datos de entrada para focalizar sobre regiones de interés, seleccionar intervalos temporales determinados o personalizar mapas a nuestro gusto y elección.
Próximos pasos
Los pasos siguientes que se proponen para profundizar en el análisis son:
- Explorar los formatos NetCDF o KML/KMZ, también georreferenciados, para tener un mayor control y dominio sobre los formatos de datos más populares en cartografía y análisis geoespacial.
- Comparar las características astronómicas del eclipse de 2026 con los de 2027 y 2028, accesibles en el Catálogo de datos de datos.gob.es.
- Representar variables que no se han mostrado en este ejercicio, como las efemérides o parámetros tales como la duración, la elevación o el azimut de los cuerpos celestes implicados en el eclipse.
Ámbitos de aplicación
El resultado de este ejercicio de visualización de datos aplica y apela a los siguientes ámbitos del análisis de datos:
- Periodístico: para la divulgación de la información precisa referente a los eclipses de sol.
- Científico: una vez los datos son accesibles, se pueden explorar todas las variables astronómicas incluidas en el conjunto de datos del CNIG y hacer un retrato del fenómeno astronómico mucho más completo que el descrito en este ejercicio.
- Analítico: el ejercicio se ha ceñido a la visualización más tradicional en base a mapas y cartografías. Explorar otras formas de visualización con un conjunto de datos tan atractivo puede incentivar la creatividad y la innovación a la hora de representar este tipo de eventos.

Documentación
Introducción
En 2018 la compañía Uber creó una herramienta para poder visualizar información geoespacial y poder representar gráficamente miles de puntos de localización, así como trayectorias en un amplio rango temporal. Esta herramienta pasó a ser de dominio público bajo el nombre de KeplerGL y, a día de hoy, está disponible como código abierto para la realización de mapas de forma sencilla.
KeplerGL permite representar información georreferenciada en un interfaz web sin necesidad de utilizar herramientas como ArcGIS o QGIS, o cualquier otro software que necesite de instalación en el ordenador o de complejas actualizaciones.
KeplerGL ofrece una amplia variedad de formas de representación, desde los convencionales puntos o rectángulos a formas de clustering tipo hexagonal binning o mapas de calor, hasta sistemas de mallas más sofisticados como H3.
Toda la gama de elementos gráficos viene con una serie muy completa de opciones de customización, tanto en el tamaño como en el color pasando por los rangos de valores. La propia cartografía de fondo que se utiliza para referenciar la información que queremos visualizar también dispone de todo un catálogo de opciones, entre los que se incluyen fondos claros, oscuros o imágenes satelitales del espectro visible.
En este ejercicio visualizaremos información georreferenciada relacionada con la actividad sísmica de la erupción del volcán de la Palma en torno a septiembre de 2021. Esta información se vio reflejada de formas diversas en varias infografías en medios de comunicación de ámbito estatal, donde se geolocalizaban los epicentros de los terremotos tomando como referencia la isla de La Palma. En la Figura 1 observamos el mismo tipo de mapa, en el cual se superponen círculos a una cartografía de fondo, y donde el radio de los círculos es proporcional a la actividad sísmica. En este ejercicio aprenderemos a hacer mapas similares en contenido y en estilo de forma rápida e intuitiva gracias a KeplerGL.
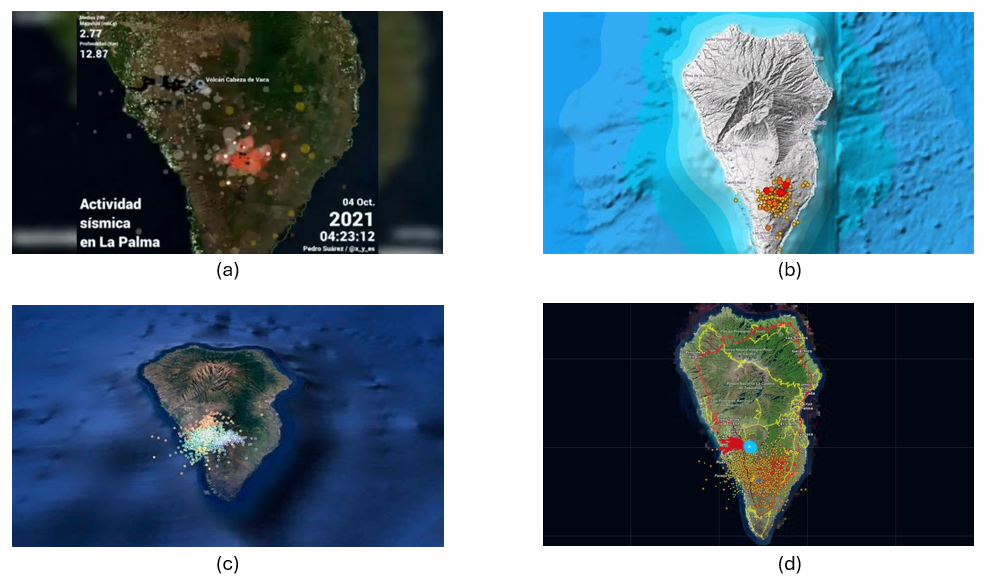
Figura 1: Mapa mostrado en diversos medios de comunicación con los epicentros de la actividad sísmica previa a la erupción del volcán de la Palma. (a) Antena3, (b) Telemadrid, (c) La Vanguardia y (d) ElDiario.es
Para crear el mapa de actividad sísmica tenemos dos alternativas dependiendo del nivel de detalle y de procesamiento que queramos realizar:
- La primera opción es utilizar los datos que nos bajaremos directamente del portal de datos tal y como están. En el apartado de Datos para el ejercicio se indica el enlace a través del cual podemos acceder a un fichero .CSV con todos los datos que necesitamos para crear el mapa y desarrollar todo el ejercicio sin necesidad de programar ni crear código.
- La segunda opción es procesar y filtrar los datos a través de Python por si queremos familiarizarnos con unas líneas sencillas de código y así seleccionar variables o intervalos temporales de nuestro interés. El acceso al repositorio de Github y el notebook de Google Colab para realizar la lectura, selección de variables y criterios de filtrado para obtener un subconjunto de datos se puede realizar a través de los siguientes enlaces:
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Datos para el ejercicio
En este ejercicio vamos a utilizar datos abiertos del Cabildo Insular de La Palma recopilados durante la actividad sísmica anterior y posterior a la erupción volcánica en La Palma en 2021, y que están disponibles aquí:
https://datos.gob.es/es/catalogo/l03380010-terremotos
En este dataset encontramos el registro de cada uno de los puntos en los que se detectó actividad sísmica durante esos días, así como, entre otras, las siguientes métricas que caracterizan sus propiedades geológicas:
| Metrica | Descripción |
|---|---|
| ID | Identificador asociado a cada evento |
| Datetime | Fecha y hora de cada evento |
| ErrTime | Error asociado al tiempo de registro |
| RMS | Root Mean Square del tiempo de propagación |
| Latitude | Coordenada de latitud en grados |
| Longitude | Coordenada de longitud en grados |
| Az | Grado azimutal |
| Depth | Profundidad del evento en kilómetros |
| ErrDepth | Error asociado a la medida de la profundidad |
| Nsta | Número de estaciones empleadas en medir el evento |
| Gap | Mayor diferencia azimutal entre estaciones adyacentes |
| Author | Organismo responsable de la medición |
| Magnitud | Magnitud sísmica del evento |
| IntensMax | Intensidad máxima del evento |
| Localización | Localización |
| TipoMagnit | Tipo de magnitud |
| XUTM | Coordenada de longitud en el sistema UTM |
| YUTM | Coordenada de latitud en el sistema UTM |
| GlobalID | Identificador del evento |
Para la creación del mapa nos centraremos en la variable asociada a la actividad sísmica: magnitud, así como la longitud y latitud de cada punto y la fecha y la hora de cada evento.
Proceso de desarrollo
1. Acceso a la interfaz web
Como mencionábamos en la introducción, KeplerGL no necesita de instalación en el ordenador, sino que se accede a través de internet a su interfaz. Por lo tanto, lo primero que haremos será abrir un navegador y acceder a la web de KeplerGL a través del dominio:
Una vez en la página de inicio haremos click sobre Get Started para poder subir los datos y empezar a crear nuestro mapa.
Como vemos en la Figura 2, KeplerGL incluye otras opciones, como acceder a datos que estén almacenados en una base de datos o consultar directamente el código Github, especialmene útil para desarrolladores o para integrar KeplerGL dentro de otras aplicaciones. No obstante, en este caso nos centraremos en la opción más sencilla: la carga de nuestros datos directamente en la interfaz.
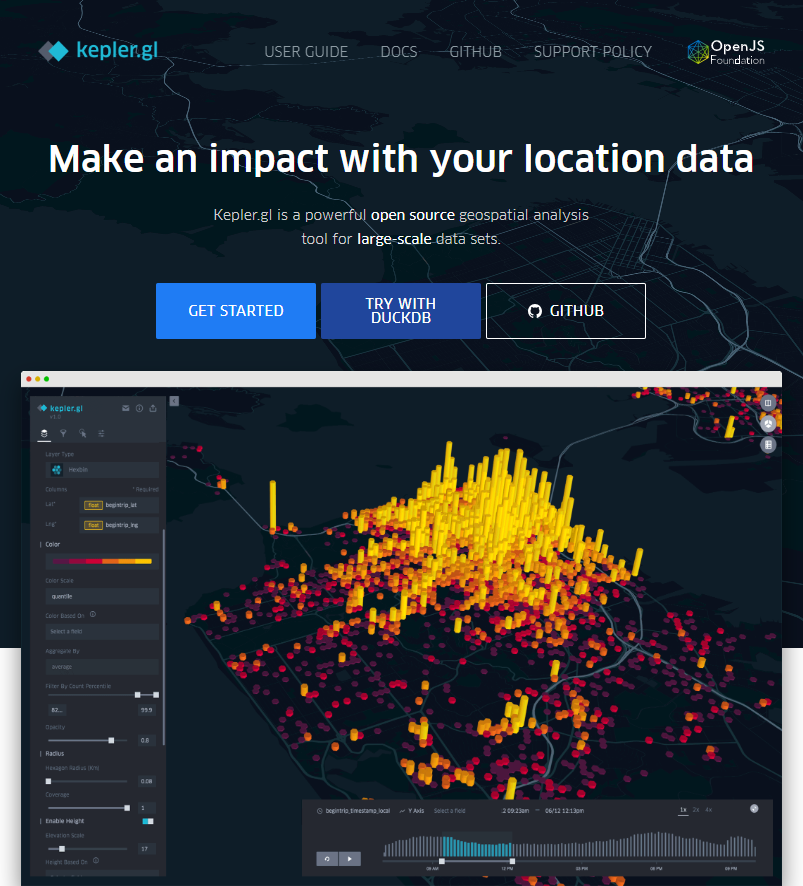
Figura 2: Pantalla principal de KeplerGL donde se nos ofrece un ejemplo de visualización, así como la opción de empezar el proceso de creación de nuestro mapa.
2. Carga de datos en la página
En la página de carga de datos tenemos el habitual cuadro de diálogo para poder subir nuestros datos. Como vemos en la Figura 3, KeplerGL acepta diferentes formatos:
- CSV: el tradicional formato con valores, generalmente separados por comas.
- JSON: alternativa al CSV con entradas estructuradas en formato de listas y objetos
- GeoJSON: formas geométricas estructuradas como un JSON.
- Arrow: datos estructurados en columnas para la aplicación Apache Arrow.
- Parquet: formato en columnas para grandes cantidades de datos.
En este punto subiremos los datos que hemos obtenido directamente del portal o aquellos filtrados que hemos realizado con el código de Python reflejado en el repositorio de Github y el notebook de GoogleColab. Ambas opciones son válidas para crear los mapas.
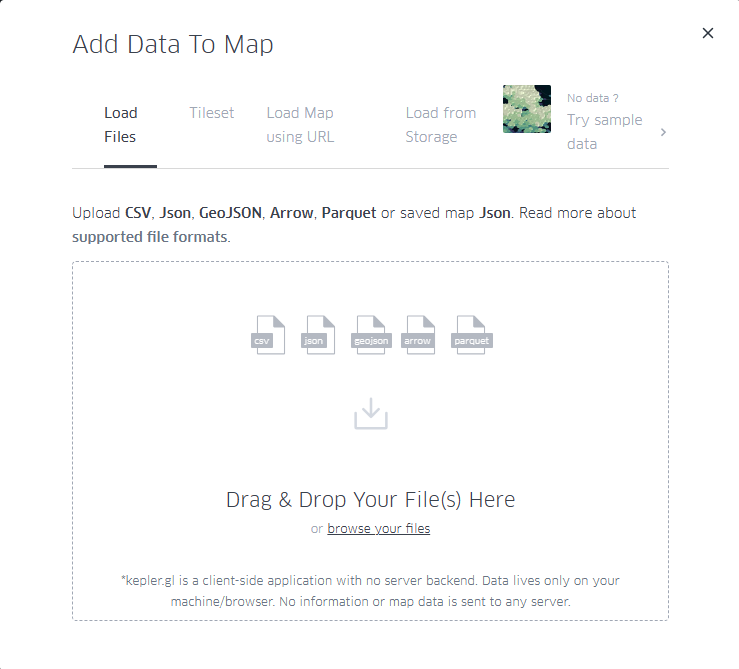
Figura 3: Cuadro de dialogo para la carga de archivos, ya sea mediante la selección desde el ordenador o arrastrándolos directamente al navegador.
3. Visualización
KeplerGL nos permite representar la informacion geografica a través de varios elementos, como puntos, rejillas (grids), distribuciones en hexágonos, mapas de calor, así como proyectar todas estas formas en tres dimensiones. En la Figura 4 se detallan los diferentes tipos de visualización posibles que ofrece la herramienta.
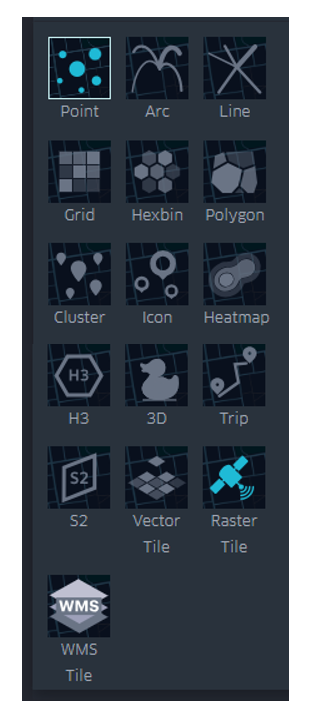
Figura 4: Opciones de visualización de la información georreferenciada, que incluye puntos, trayectorias, líneas, cuadros, hexágonos, polígonos, clusters, iconos, mapas de calor, celdas H3, tridimensional, viajes, celdas S2, vectorial y rasters.
A continuación vemos en detalle las características de las formas de visualización que podemos explorar con este conjunto de datos.
3.1 Puntos
Dentro de los puntos podremos parametrizar las siguientes variables: color del punto, borde del punto, magnitud adicional asociada al radio, dimensiones del radio, etiquetas, tooltip con información, interacción entre superposiciones o transparencia.
En la Figura 5 podemos observar la aplicación directa de la representación por puntos. KeplerGL identifica tanto la latitud como la longitud automáticamente para situar sobre el plano cada uno de los puntos. A partir de ahí dibuja un círculo con un radio determinado y asigna un color dependiendo de la intensidad de la magnitud.
En el panel de control de la izquierda se puede controlar tanto el radio de los círculos como la paleta de colores, y aplicar las opciones que más nos gusten para representar la intensidad. El hecho de poder jugar con ambos parámetros nos permitiría añadir otro eje de información a la visualización. En este caso, por simplicidad, dejamos esta representación tal y como está, explorando únicamente el color.
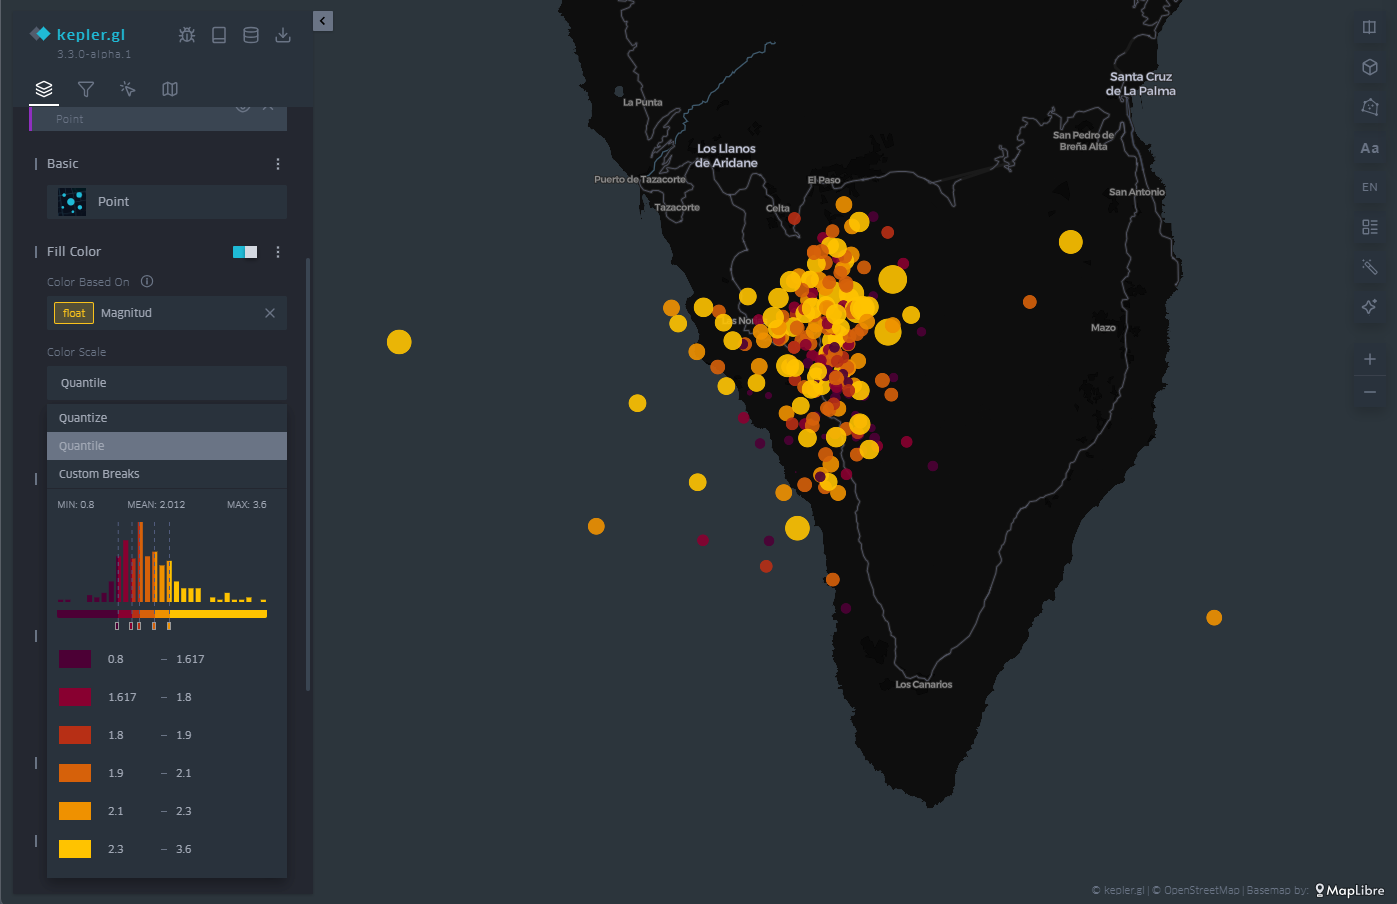
Figura 5: Mapa con los seísmos en la isla de La Palma representados por puntos. El color y el radio es proporcional a la magnitud del seísmo.
3.2 Malla de puntos
De la misma forma que KeplerGL identifica la latitud y la longitud para situar los círculos, también es capaz de promediar los valores de magnitud en celdas. Dichas celdas pueden englobar uno o varios puntos, y KeplerGL asigna en consecuencia un color que representa su valor en base al valor promedio, como vemos en la Figura 6.
Al igual que en el caso de los puntos, el cuadro de diálogo de la izquierda permite cambiar la paleta de colores, aumentar o disminuir el tamaño de las celdas para promediar sobre áreas más extensas o reducidas. Igualmente, la escala de valores sobre la cual se basa la asignación de cada uno de los colores de la escala también está sujeta a su personalización, dependiendo del rango de valores que queramos destacar en la visualización.
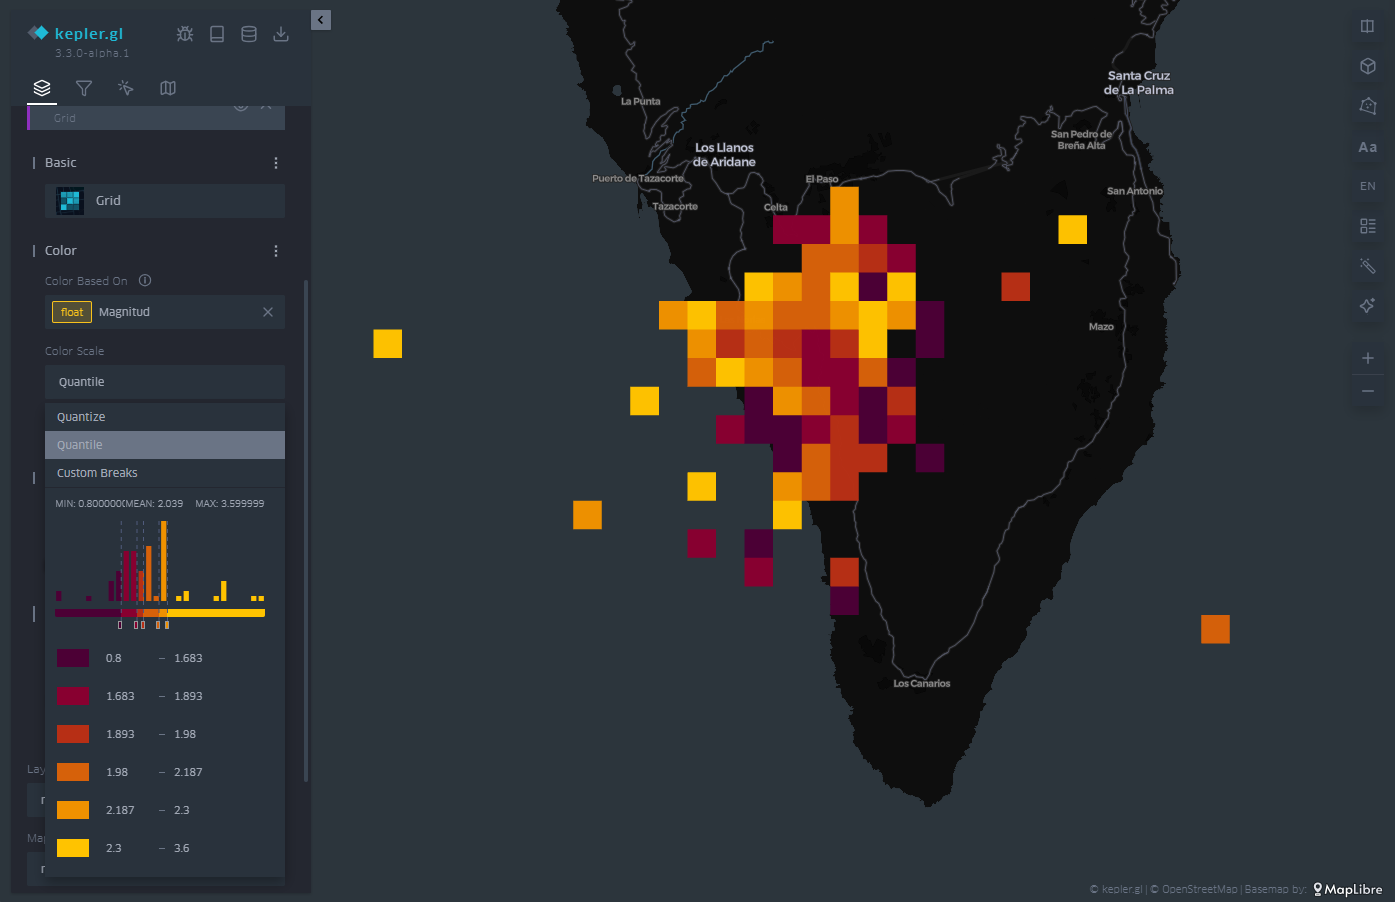
Figura 6: Mapa con los seísmos en la isla de La Palma representados por una malla. El color está asociado a la escala de magnitud del seísmo.
3.3 Hexbin
Similar a la malla de celdas, hexbin es un acrónimo de hexagonal binning, es decir, promediado de valores sobre celdas con forma de hexágono. A diferencia de las celdas rectangulares, el empaquetamiento de celdas con forma de hexágono responde a estructuras más compactas, similares a las que pueden observarse en la organización de partículas o átomos en la formación de estructuras de estado sólido.
El hexbin tiene las mismas propiedades que hemos visto en el caso de la malla de celdas, es decir, podemos cambiar el tamaño de la celda hexagonal para que ocupe una mayor superficie en su promedio, podemos cambiar igualmente la paleta de colores y también el rango de valores sobre el cual actúa cada intervalo de color. Un ejemplo del hexagonal binning se encuentra en la Figura 7.
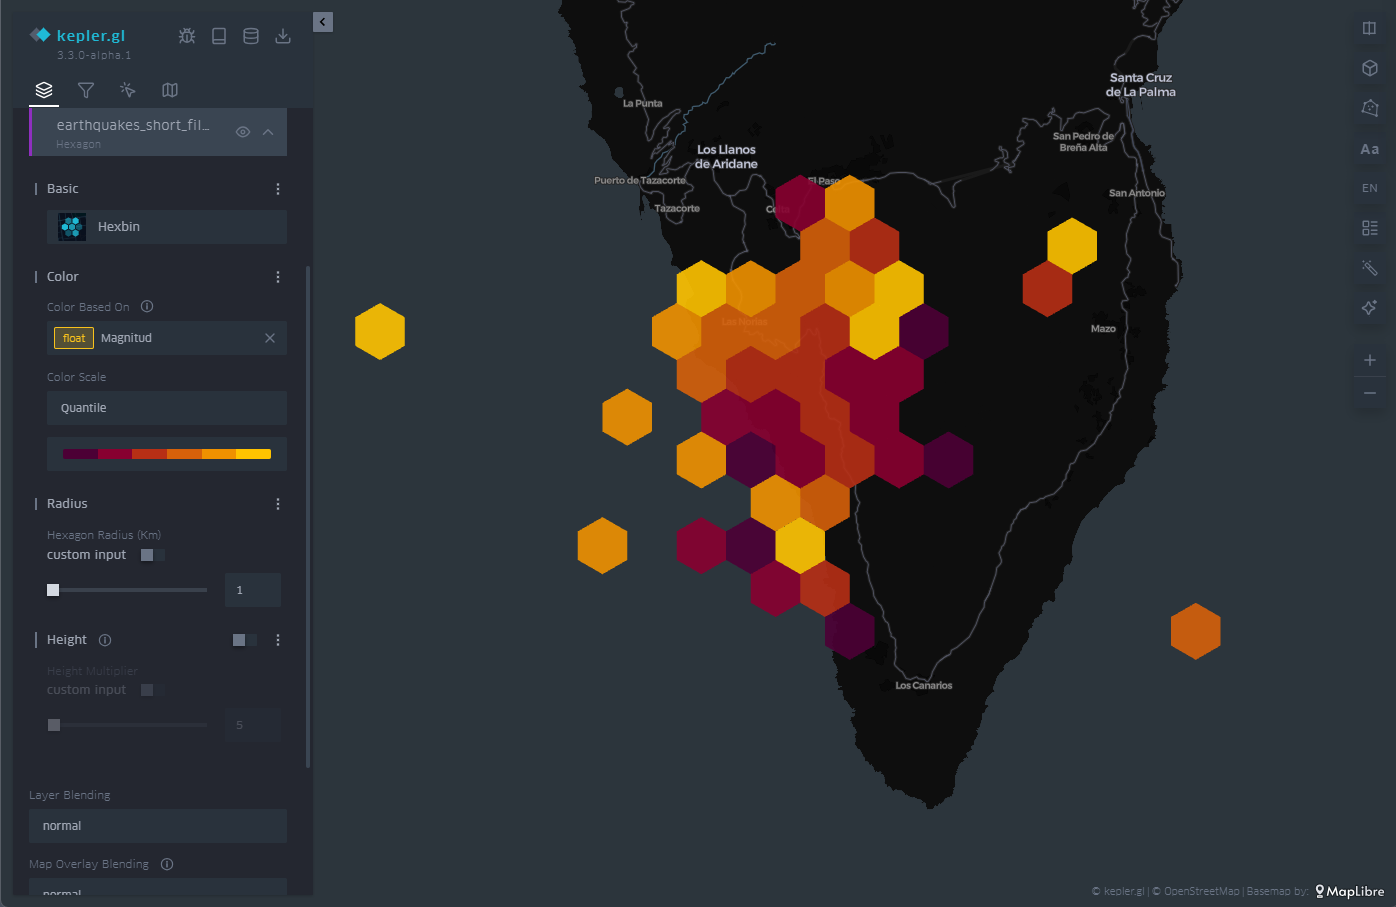
Figura 7: Mapa con los seísmos en la isla de La Palma representados por hexágonos. El color está asociado a la magnitud del seísmo y el hexágono agrega los puntos que cubre su extensión.
3.4 Heatmap
La última de las representaciones que veremos en el plano es el mapa de calor o heatmap, en su concepción en inglés. El heatmap no es más que un diagrama de contorno, donde cada curva de nivel corresponde a un intervalo determinado de valores. En el momento en el que el número de curvas de nivel es muy elevado obtenemos esa sensación de continuo que evoca al mapa de calor.
En este caso, tanto la paleta de color elegida con su número de niveles como el radio sobre el cual se promedian los valores son personalizables a través de las opciones del menú de la izquierda. En la Figura 8 tenemos un ejemplo, donde la densidad de eventos aflora de forma natural con este tipo de representación.
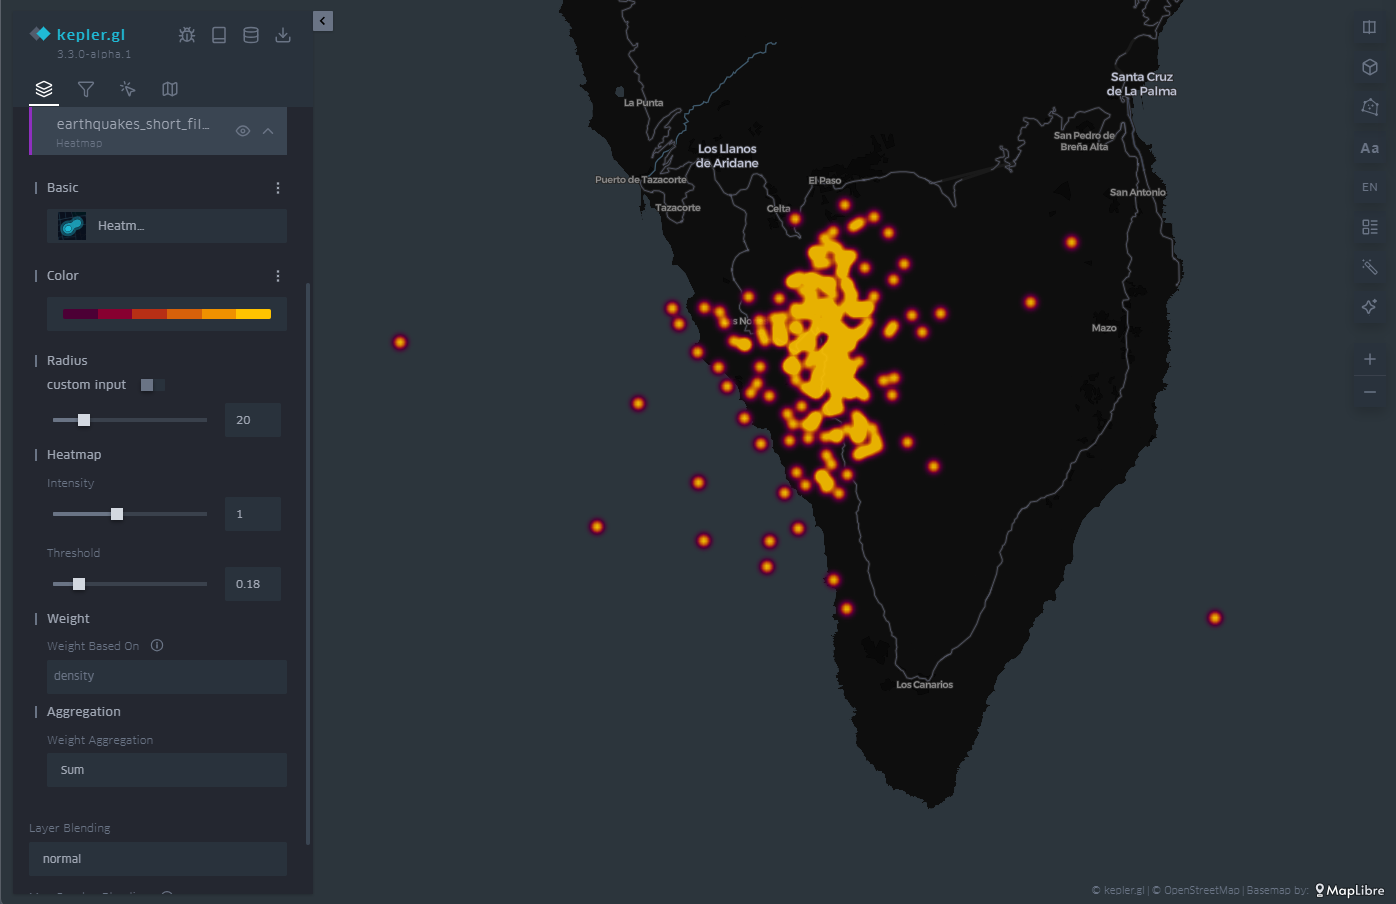
Figura 8: Mapa con los seísmos en la isla de La Palma representados por un mapa de calor. El color está asociado a la densidad de eventos sísmicos.
3.5 Tridimensionalidad
Por último, en la representación geográfica tenemos la posibilidad de utilizar el eje z, o eje vertical, para añadir o redundar información en esa dimensión. Para ello tenemos la opción denominada "Height" dentro del menú de la izquierda. La opción "Height" aplica tanto a círculos como a mallas de celdas, donde afecta al polígono que define cada una de las celdas.
De esta forma, proyectamos en la vertical otra magnitud a nuestra elección, que complementa aquella magnitud ya representada por el color de las celdas o círculos sobre el plano, tal y como ilustra la Figura 9.
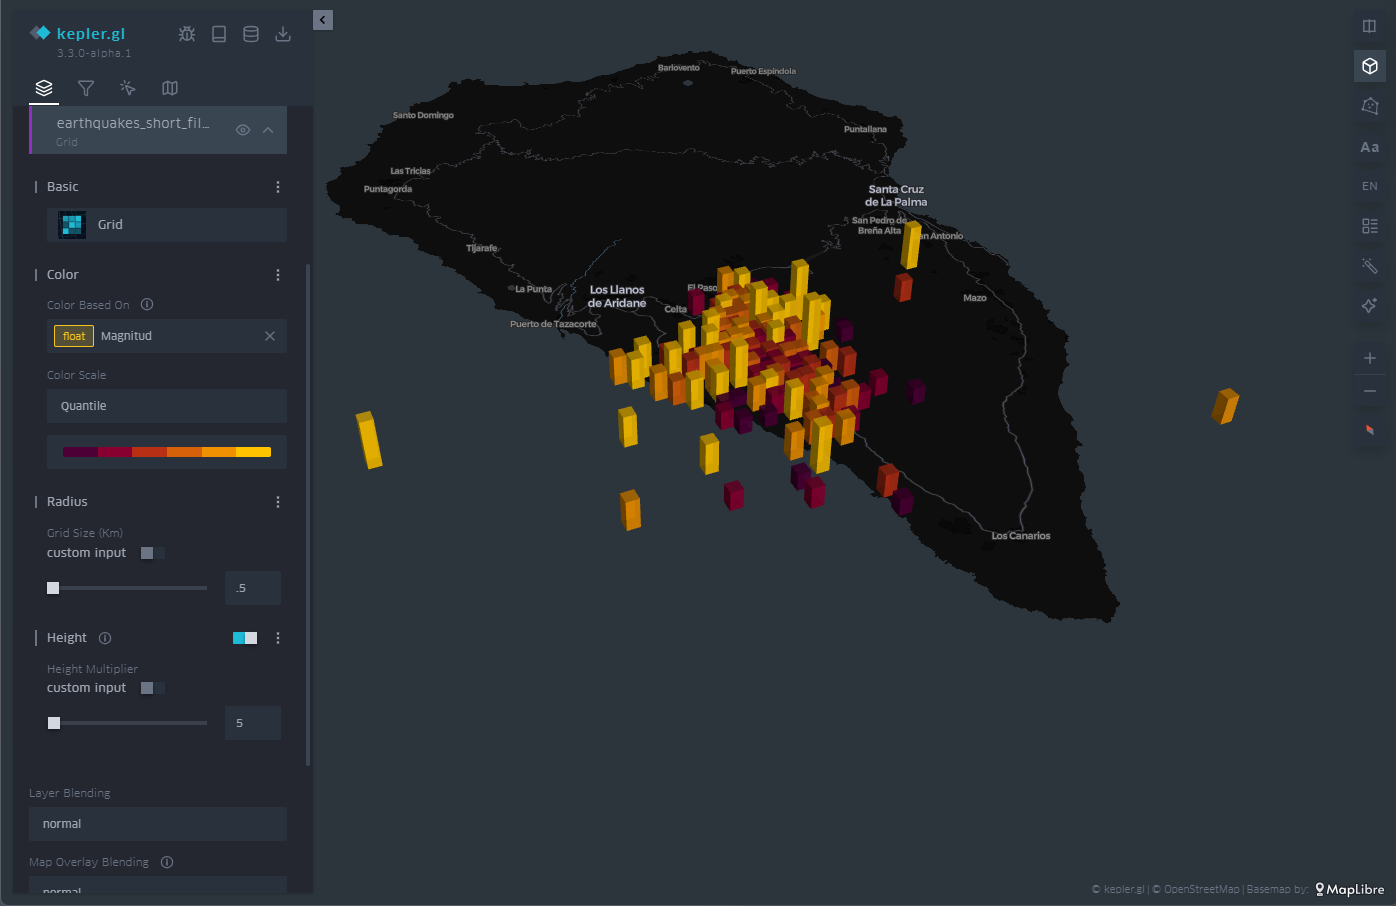
Figura 9: Mapa con los seísmos en la isla de La Palma representados por rectángulos. La altura y el color están asociados a la magnitud del seísmo.
3.6 Filtro Temporal
Como se puede ver en la Figura 10, en el menú superior de la izquierda encontramos una herramienta de gran utilidad como es el filtro de tiempo. Cuando, como en este caso, disponemos de información temporal de los eventos, a través del campo de fecha, podemos utilizar ese eje de información para filtrar la información que queremos representar y focalizar sobre aquellos días u horas de mayor interés para nuestro análisis y proyecto de visualización.
La herramienta de filtro permite elegir la magnitud sobre la cual vamos a realizar la selección filtrada. Una vez elegida, se despliega en la parte inferior un histograma en el cual podemos ver a simple vista la distribución del número de puntos que se corresponden con cada fecha. En la Figura 10 podemos ver el histograma en la parte inferior.
Esta herramienta permite no sólo seleccionar un día sino también un intervalo de tiempo. Deslizando ese intervalo de tiempo a lo largo del histograma nos permite, no sólo ver un determinado periodo de interés, sino también realizar una animación que desplace de forma automática ese intervalo de tiempo a lo largo de toda la serie temporal.
Esta característica hace de este filtro una opción muy atractiva para poder crear en segundos lo que se conoce como storytelling, esto es, una animación fácil y muy intuitiva.
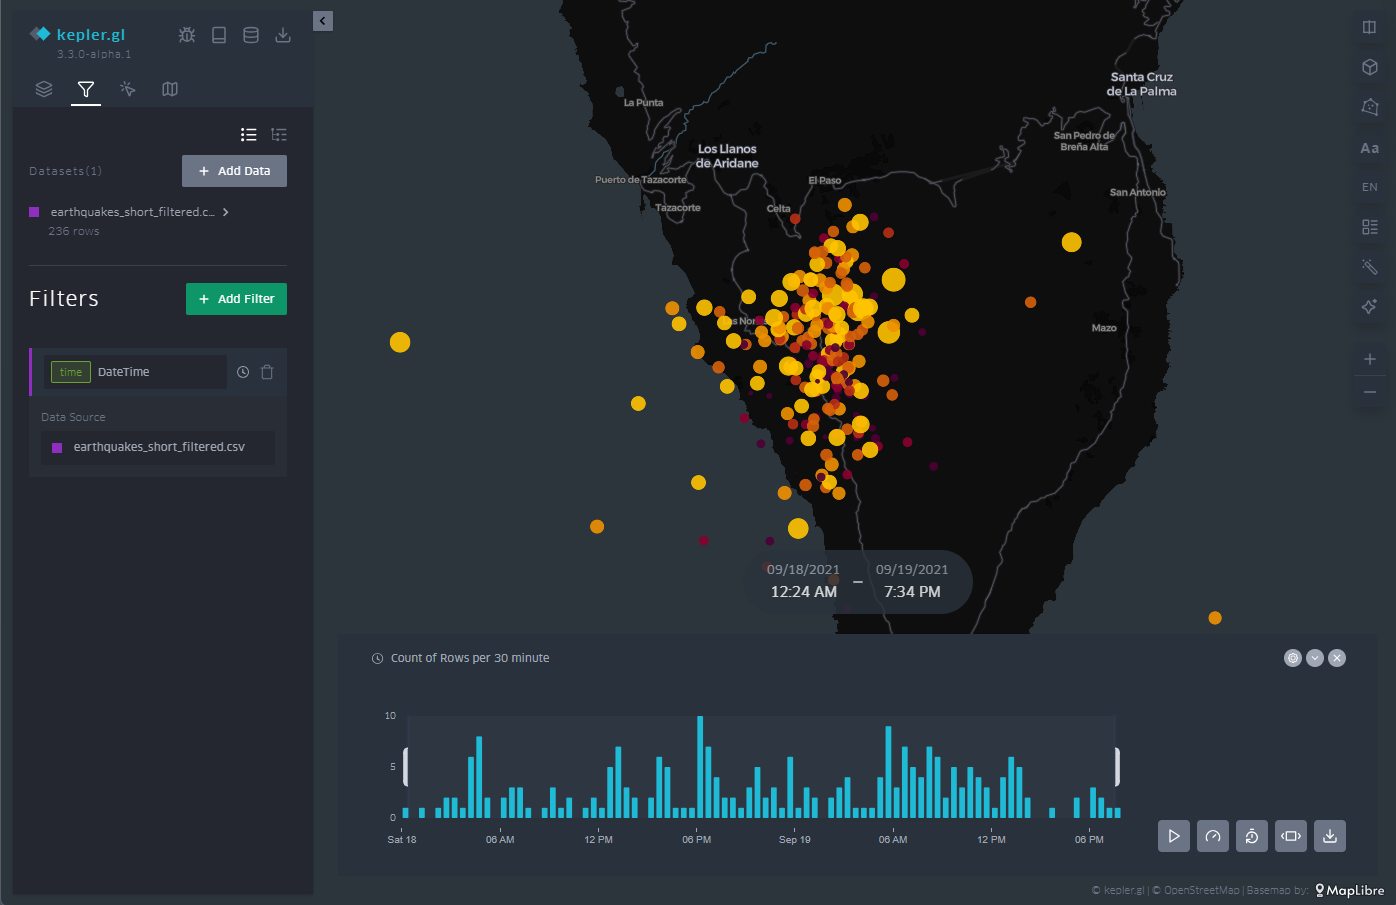
Figura 10: Mapas con los seísmos en la isla de la Palma a través de puntos con un filtro temporal aplicado a toda la secuencia de datos en la parte inferior. El intervalo a media altura en el histograma especifica la longitud temporal.
Como ejemplo de animación podemos ver en la Figura 11 un vídeo donde se muestra la herramienta del filtro y cómo la ventana que definimos va recorriendo el histograma. Esta animación se centra en los días anteriores y posteriores a la erupción del volcán el 19 de septiembre de 2021, así como toda la actividad sísmica que siguió a la erupción del volcán hasta entrado 2022.
El acceso al vídeo se puede realizar tanto a través de la miniatura de Youtube de la Figura 11 como a través de este enlace al canal de vídeos de datos.gob.es:
Accede al vídeo de la actividad sísmica en KeplerGL
Figura 11: Secuencia de la actividad sísmica detectada antes, durante y después de la erupción volcánica en la isla de La Palma alrededor de septiembre de 2021.
3.7 Leyenda
Como se ilustra en la Figura 12, en el menú de la derecha tenemos diferentes opciones, tales como disponer la proyección cartográfica en tres dimensiones o, en la esquina inferior derecha, activar la aparición de una leyenda.
La leyenda aparece asociada a la variable que hemos elegido para representar los puntos, en este caso, la magnitud. Los intervalos vienen predefinidos según los intervalos que hayamos definido cuando creamos los intervalos en la escala de color de los puntos.
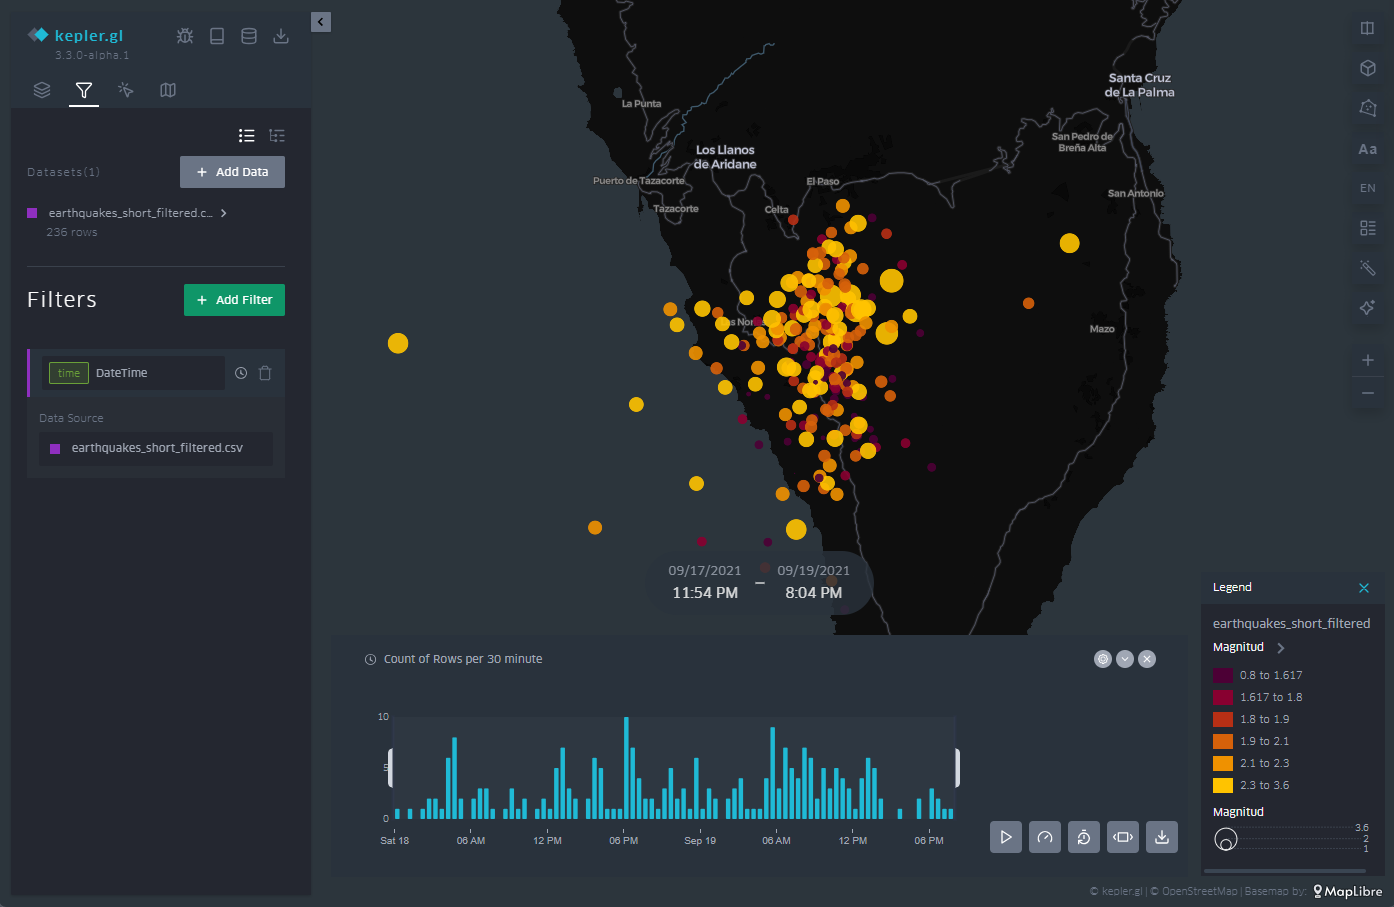
Figura 12: Leyenda del código de colores y valores utilizado para la representación por puntos, en sintonía con nuestras definiciones de intervalos en la configuración de la representación por puntos.
3.8 Cartografía de fondo
Dependiendo del evento que representemos en el mapa, es conveniente utilizar diferentes tipos de cartografías de fondo para una mejor comprensión del mensaje que se intenta transmitir a través de la visualización. Dependiendo de la audiencia y del contexto, la información que ofrece el mapa de fondo puede resultar más o menos útil. Si, como es en este caso, sólo queremos transmitir información geológica, su relevancia es menor. Si, por el contrario, queremos describir también infraestructuras civiles que se puedan ver afectadas por los terremotos, será necesario incorporar una cartografía base.
De esta forma, KeplerGL ofrece también toda una serie de cartografías de fondo, divididas mayormente en dos familias: las de fondo oscuro y las de fondo claro. Aquí conviene recordar que el ojo humano percibe mejor detalles pequeños sobre un fondo oscuro, e interpreta mejor formas grandes sobre fondo claro. En el caso de los terremotos y la escala a la cual los estamos representando, conviene utilizar un fondo oscuro, ya que seremos capaces de discernir con mejor precisión las distancias y los detalles.
Para seleccionar los diferentes mapas de fondo iremos al icono situado en la parte superior del panel de la izquierda, y en el menú desplegable podremos elegir aquel que más nos convenga. En la Figura 13 se muestran los diferentes tipos de mapas.
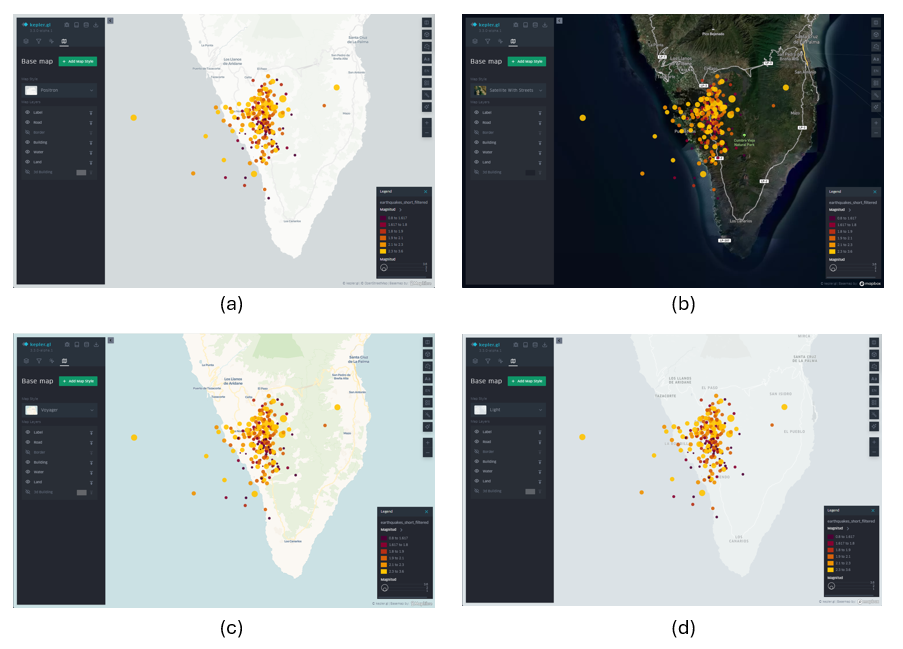
Figura 13: Diferentes cartografías de fondo en KeplerGL para la representación de la actividad sísmica en la isla de La Palma en septiembre de 2021: Positron (a), Satellite (b), Voyager (c) y Light (d).
4. Exporta el mapa
Por último, una vez realizado nuestro mapa, podemos exportar el resultado a través del icono de descarga situado en la parte superior del menú de la izquierda. Una vez seleccionado ese icono podemos guardar el mapa como imagen.
Las opciones que se nos ofrecen son: el tamaño mediante el ratio de la imagen respecto a sus dimensiones horizontales y verticales, la resolución ligada a ese ratio que hayamos seleccionado y la opción de incorporar una leyenda en la imagen de salida, tal y como muestra la Figura 14.
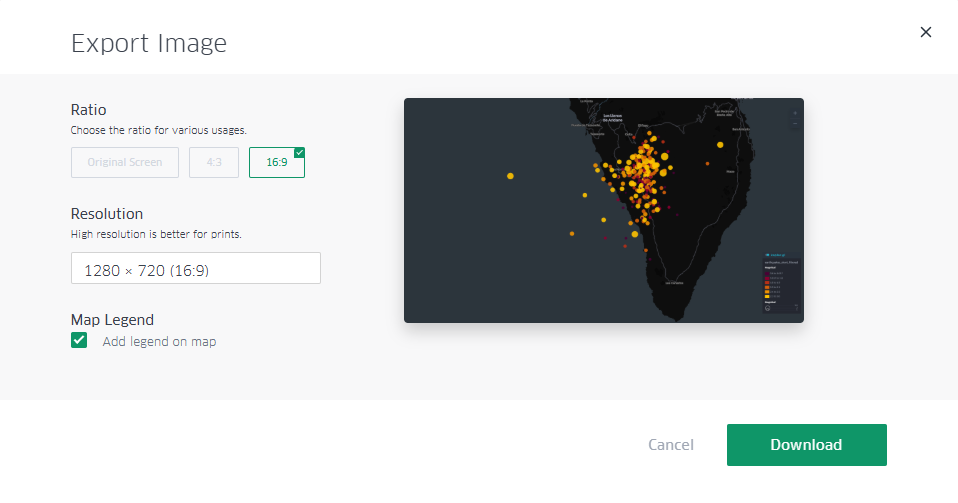
Figura 14: Cuadro de diálogo para exportar el mapa como una imagen. Nótese la selección de la casilla de mostrar la leyenda, así como la selección de un formato panorámico con espacio para incorporar más adelante elementos infográficos en otros contenidos
Adicionalmente existe la posibilidad de compartir el mapa con toda su interactividad a través del registro en Dropbox o en Carto, si la intención es la difusión del mapa a través de otros canales más allá de una imagen estática.
Lecciones aprendidas
En este ejercicio hemos aprendido a crear un mapa de forma sencilla e intuitiva con la ayuda de KeplerGL. En concreto hemos aprendido a:
- Subir un fichero a través del interfaz web de KeplerGL.
- Representar de diferentes maneras información georreferenciada.
- Aprender a utilizar un filtro temporal sobre la serie de datos y crear una animación para su difusión como vídeo.
- Añadir una leyenda y manejar los valores que refleja esa leyenda.
- Customizar cada una de las formas de visualización al detalle.
- Exportar el mapa resultante con un cierto grado de customización.
Conclusiones y próximos pasos
El mundo de la cartografía siempre ha necesitado de conocimientos previos sobre proyecciones, sistemas de referencia, formatos de datos georreferenciados y sobre todo la instalación de software específico para crear mapas. Gracias al desarrollo de productos web uno de estos proyectos nos permite crear mapas de forma muy sencilla y puede suponer una herramienta muy potente a la hora de crear mapas sin necesidad de muchos conocimientos previos y con un alto grado de customización.
A partir de este punto se pueden explorar herramientas más sofisticadas que requieren bien de conocimientos generales, bien de conocimientos de programación para poder realizar mapas con Leaflet o con D3.js, dependiendo de la audiencia y de la aplicación en la cual queremos encuadrar el mapa.
Ámbitos de Aplicación
La creación de mapas sencillos tiene muchos campos de aplicación, ya que la cartografía en general resulta ser una de las formas de visualización más claras y populares gracias a su uso desde el origen de la civilización. Los ámbitos propuestos incluyen:
- Redacciones de periodismo: reaccionar a eventos concretos tales como catástrofes naturales o grandes bases de datos de eventos georreferenciados puede ser más fácil gracias a herramientas como KeplerGL.
- Corporaciones y empresas: localización de volúmenes asociados a puntos concretos de la geografía se puede leer de forma intuitiva con la creación de mapas que pueden resumir grandes cantidades de datos.
- Aplicaciones: Integrar mapas dentro de las aplicaciones suele ayudar tanto en las capas tanto de información como en la de interactividad para explorar el rendimiento y resultado de un producto a diferentes escalas.
Blog
Antes de realizar una visualización de datos es importante entender dos cuestiones. Por un lado, qué es exactamente lo que se tiene entre manos, es decir, el tipo de datos, su formato y otras características relevantes; y, por otro lado, qué es lo que se quiere visualizar, el objetivo de la representación gráfica que se va a realizar.
En el caso concreto de los datos geográficos se abren posibilidades narrativas enormes porque las visualizaciones permiten mostrar distribuciones territoriales, identificar patrones espaciales, comparar regiones o trazar la evolución de un fenómeno en el tiempo y en el espacio. Para sacar partido a esas posibilidades, es importante tener presente que el archivo puede:
- Contener coordenadas en diferentes sistemas de referencia.
- Representar fenómenos que requieren tipos de mapas muy concretos.
Dedicar unos minutos a entender esas características antes de elegir una herramienta es, en realidad, el camino más corto hacia un resultado útil y riguroso. En este post repasamos, paso a paso, cómo se debe trabajar el dato geográfico y qué herramientas existen para representarlo gráficamente.
Antes de trazar cualquier mapa: formato, escala y proyección
El primer escollo a la hora de trabajar con datos geoespaciales suele ser el formato. Los datos georreferenciados llegan en presentaciones muy diversas: desde un simple CSV con columnas de latitud y longitud, hasta formatos más especializados como GeoJSON (ideal para intercambiar geometrías en entornos web), Shapefile (SHP, el estándar histórico de los sistemas de información geográfica), o formatos científicos como NetCDF y GRIB (pensados para datos climáticos y meteorológicos en cuadrículas). Saber en qué formato están los datos y cuál es el más adecuado para cada herramienta ahorra mucho tiempo y evita errores de importación.
El segundo aspecto crítico es el sistema de referencia de coordenadas (CRS). No todas las coordenadas hablan el mismo idioma. El sistema WGS84 es el que usan los GPS y la mayoría de servicios web de mapas; el UTM, en cambio, trabaja en metros y es más preciso para cálculos de distancias o áreas. Mezclar datos en sistemas distintos sin reproyectarlos (es decir, sin convertir las coordenadas de un sistema de referencia a otro) produce desplazamientos y geometrías que no encajan.
El tercer elemento a considerar antes de elegir una herramienta es el tipo de representación que mejor comunica los datos. No es lo mismo mostrar puntos de interés, que trazar trayectorias, elaborar un mapa de coropletas (con áreas coloreadas según un valor estadístico), o construir modelos de elevación digital o visualizaciones en 3D. Cada tipo de dato y cada pregunta analítica tiene su representación cartográfica más apropiada.
Con esos tres factores claros (formato, proyección y tipo de mapa) llega el momento de elegir la herramienta.
Herramientas básicas: exploración sin instalación
Para quienes se acercan por primera vez a la visualización de datos geográficos, o para quienes necesitan explorar un conjunto de datos de forma rápida sin entrar en configuraciones complejas, existen opciones accesibles que funcionan directamente desde el navegador o con instalación mínima. Son ideales para una primera toma de contacto con los datos y para comunicar resultados a audiencias no técnicas.
Kepler.gl es probablemente la mejor opción para quienes quieren obtener mapas interactivos de calidad sin escribir una sola línea de código. Es una herramienta web gratuita y de código abierto que permite arrastrar y soltar archivos en formatos como CSV, GeoJSON o Shapefile y obtener visualizaciones de forma inmediata.
- Para qué se usa: exploración visual de grandes volúmenes de datos de movilidad, distribución espacial y patrones geográficos.
- Formatos compatibles: CSV, GeoJSON, Shapefile y JSON.
- Punto fuerte: ofrece múltiples tipos de capas —puntos, arcos, hexbinning, contornos— con una interfaz visual intuitiva y resultados visualmente muy cuidados, sin necesidad de instalar nada.
Google Earth es otra opción accesible para la exploración inicial. Es gratuita pero no es de código abierto, y los datos cargados pueden ser procesados por Google. Su versión web permite importar archivos KML/KMZ y es útil para contextualizar información sobre imágenes satelitales.
- Para qué se usa: contextualización de datos sobre imágenes satelitales y exploración geográfica visual.
- Formatos compatibles: KML y KMZ.
- Punto fuerte: la calidad y actualización de su base de imágenes satelitales la convierte en una herramienta de referencia para situar datos en su contexto territorial real. Para análisis rigurosos o publicación institucional, conviene valorar alternativas más abiertas.
Nivel intermedio: librerías Python para análisis y publicación
Cuando la exploración inicial da paso al análisis y a la necesidad de reproducir, automatizar o integrar los mapas en flujos de trabajo más amplios, existen librerías de Python que pueden ser una buena opción. Su uso requiere conocimientos básicos de programación, pero a cambio permiten un control mucho mayor sobre cada aspecto de la visualización y facilitan la integración con otras herramientas de análisis de datos.
Cartopyes una librería que se integra con Matplotlib y está orientada a la representación de datos científicos y climáticos. Su gran fortaleza es el manejo de proyecciones cartográficas, con soporte para decenas de sistemas de referencia.
- Para qué se usa: generación de mapas de publicación con datos científicos, especialmente climáticos y atmosféricos en formato de cuadrícula.
- Formatos compatibles: NetCDF, GRIB y cualquier fuente compatible con Matplotlib.
- Punto fuerte: control fino sobre proyecciones y elementos cartográficos, ideal cuando la deformación introducida por la proyección tiene impacto directo en la interpretación de los datos.
Folium ocupa un nicho diferente: genera mapas web interactivos basados en Leaflet.js directamente desde código Python, sin necesidad de conocer JavaScript. Es especialmente cómoda para producir visualizaciones que se integran en notebooks de Jupyter o en páginas web.
- Para qué se usa: creación de mapas interactivos para publicación web o presentación en notebooks, con marcadores, capas y pop-ups.
- Formatos compatibles: GeoJSON, CSV y fuentes de datos de pandas y GeoPandas.
- Punto fuerte: combina la comodidad de Python con la interactividad de Leaflet.js, permitiendo generar visualizaciones web completas con muy pocas líneas de código. Su principal limitación es el rendimiento con conjuntos de datos muy grandes.
Nivel avanzado: mapas web con control total
Si el objetivo es construir aplicaciones cartográficas integradas en entornos web propios, con capacidad para manejar grandes volúmenes de datos y ofrecer una experiencia de usuario fluida, es necesario dar un paso más. Las herramientas de este nivel requieren conocimientos de desarrollo web, pero ofrecen a cambio un control prácticamente ilimitado sobre el comportamiento y el aspecto del mapa.
OpenStreetMap (OSM) no es exactamente una herramienta de visualización, sino la base de datos geográfica colaborativa más grande del mundo, con licencia abierta (ODbL). Su ecosistema incluye herramientas como Overpass Turbo para consultar y extraer datos, y sus teselas cartográficas son la base sobre la que se construyen muchos mapas web.
- Para qué se usa: obtención de datos geográficos abiertos y uso como mapa base en proyectos web.
- Formatos compatibles: OSM XML, PBF y GeoJSON mediante exportación.
- Punto fuerte: es la fuente de datos geográficos abiertos más completa y actualizada del mundo. Para proyectos comprometidos con la apertura de datos, usar OSM como base es la opción más coherente con esos principios.
MapLibre GL JS es una librería JavaScript de código abierto que permite construir mapas web interactivos de alto rendimiento mediante teselas vectoriales.
- Para qué se usa: desarrollo de aplicaciones cartográficas web con personalización completa del estilo, capas de datos dinámicas y filtros interactivos.
- Formatos compatibles: teselas vectoriales (MVT), GeoJSON y fuentes de teselas raster.
- Punto fuerte: rendimiento muy superior al de las librerías basadas en SVG o canvas clásico, con capacidad para manejar grandes geometrías de forma fluida y una personalización visual casi ilimitada.
Nivel profesional: sistemas de información geográfica
Cuando el análisis espacial va más allá de la visualización y requiere operaciones complejas sobre los datos como reproyecciones, análisis de redes, interpolaciones, edición de geometrías o producción cartográfica de precisión, la herramienta adecuada es un sistema de información geográfica (SIG) de escritorio. Este tipo de software está diseñado específicamente para el trabajo riguroso con datos geoespaciales y ofrece capacidades que ninguna solución web puede igualar.
QGIS es el SIG de escritorio de referencia en el mundo del código abierto. Gratuito, multiplataforma y con una comunidad muy activa, cubre prácticamente cualquier necesidad de análisis y producción cartográfica.
- Para qué se usa: análisis espacial complejo, edición de capas, reproyecciones, generación de mapas de calidad para impresión o publicación digital y automatización de flujos de trabajo geoespaciales.
- Formatos compatibles: Shapefile, GeoJSON, GeoTIFF, PostGIS, WMS, WFS y decenas más.
- Punto fuerte: la combinación de potencia analítica, flexibilidad y coste cero de licencia lo convierte en la opción de referencia para organismos que trabajan regularmente con datos geoespaciales. La curva de aprendizaje es real, pero la inversión se amortiza con rapidez.
ArcGIS, desarrollado por Esri, es la plataforma SIG comercial más utilizada en entornos profesionales e institucionales. Ofrece capacidades avanzadas de análisis, edición y publicación de mapas, y su ecosistema en la nube facilita la colaboración y la gestión de portales de datos geográficos.
- Para qué se usa: análisis espacial avanzado, gestión de infraestructuras de datos geoespaciales y publicación de portales cartográficos institucionales.
- Formatos compatibles: todos los estándares del sector, con integración nativa con servicios de Esri.
- Punto fuerte: ecosistema muy maduro con soporte técnico profesional y amplia implantación en el sector público. Su modelo de licencias tiene un coste elevado que lo pone fuera del alcance de muchos equipos. Se menciona aquí por su relevancia en el sector, siendo QGIS la alternativa abierta que cubre la mayoría de necesidades sin coste de licencia.
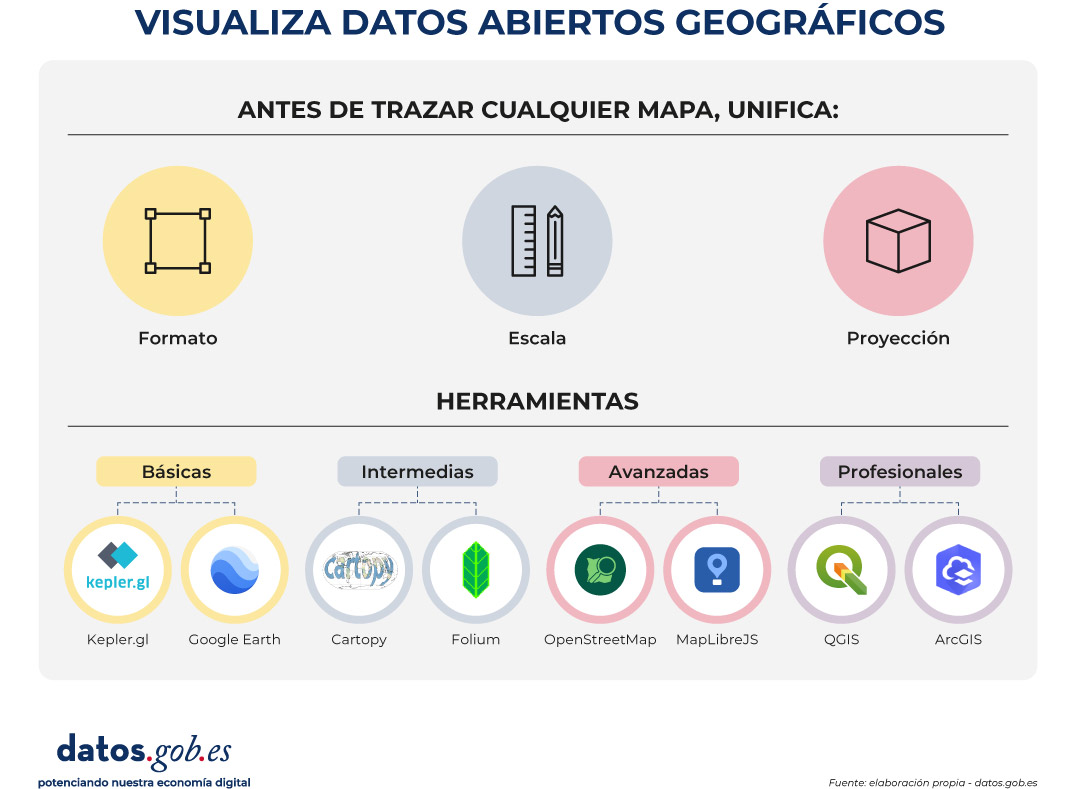
Figura 1. Visualiza datos abiertos geográficos. Fuente: elaboración propia - datos.gob.es
Ninguna de estas herramientas es mejor que las demás en términos absolutos: cada una responde bien a un tipo de tarea, un perfil de usuario y un contexto de uso. No obstante, en este post seleccionamos algunas de las más utilizadas según el nivel de conocimiento técnico de cada perfil profesional:
- Para exploración rápida y comunicación de datos: Kepler.gl
- Para visualización geográfica accesible y exploración 3D del territorio: Google Earth
- Para análisis científico reproducible en Python: Cartopy y Folium
- Para desarrollo web con cartografía avanzada: MapLibre GL JS
- Para cartografía base abierta y proyectos que requieren datos libres y editables: OpenStreetMap
- Y para análisis espacial y producción cartográfica: QGIS
En todos los casos, el punto de partida es siempre el mismo: conocer los datos, entender su estructura y asegurarse de que el mapa que se va a construir es el que mejor comunica lo que esos datos tienen que decir. La herramienta, al final, es solo el último paso de un proceso que empieza mucho antes.
Evento
Solo unos meses después del éxito de su primera entrega, el Ayuntamiento de Madrid ha abierto la convocatoria de la segunda edición de los Premios a la Reutilización de Datos Abiertos. Se trata de una iniciativa que busca reconocer y promover proyectos innovadores que utilicen los conjuntos de datos publicados en el portal datos.madrid.es. Con una dotación total de 15.000 euros, estos premios consolidan el compromiso municipal con la cultura del dato, la transparencia y la creación de valor social y económico a partir de la información pública.
En este artículo te contamos algunas de las claves que debes tener en cuenta para participar.
Dos categorías de premios a considerar
La convocatoria establece dos categorías, cada una con varios premios:
1) Servicios web, aplicaciones y visualizaciones: premia proyectos que generen servicios, visualizaciones o aplicaciones web o para dispositivos móviles.
- Primer premio: 4.000 €
- Segundo premio: 3.000 €
- Tercer premio: 1.500 €
- Premio para estudiante: 1.500 €
2) Estudios, investigaciones e ideas: se centra en proyectos de investigación, análisis o descripción de ideas para crear servicios, estudios, visualizaciones, aplicaciones web o móviles. En esta categoría también pueden participar trabajos universitarios de fin de grado y de fin de máster (TFG-TFM).
- Primer premio: 2.500 €
- Segundo premio: 1.500 €
- Tercer premio: 1.000 €
En ambas categorías es necesario que se utilice al menos un conjunto de datos del portal municipal, pudiendo combinarse con fuentes públicas o privadas de cualquier ámbito territorial. Los proyectos pueden ser recientes o haber finalizado en los dos años previos al cierre de la convocatoria.
Los premios pueden declararse desiertos si no se alcanza la calidad mínima. En ese caso, los importes sobrantes se redistribuirán proporcionalmente entre el resto de premiados.
Requisitos para participar
La convocatoria está abierta a personas físicas y jurídicas autoras de los proyectos o iniciativas. El objetivo es que cualquier persona o entidad con interés en la reutilización de datos pueda presentar su propuesta, independientemente de su nivel técnico. Por ello, pueden participar tanto profesionales y empresas, personas investigadoras, periodistas y desarrolladores, como aficionados y amateurs interesados en el análisis y visualización de datos.
En el caso del premio para estudiante, solo podrán participar aquellas personas físicas matriculadas en cursos oficiales 2023/24, 2024/25 o 2025/26.
Por el contrario, quedan excluidos de todas las categorías:
- Proyectos ya premiados, subvencionados o contratados por el Ayuntamiento de Madrid.
- Proyectos que no utilicen ningún conjunto de datos del portal municipal.
Fases del proceso
En el portal municipal se detallan las fases de la convocatoria, que incluyen:
- Publicación de la convocatoria. El pasado 3 de marzo se publicaron las bases reguladoras en el Boletín Oficial del Ayuntamiento de Madrid.
- Presentación de candidaturas. El plazo para presentar las solicitudes abarca del 4 de marzo al 4 de mayo (ambos incluidos). Se pueden presentar online o presencialmente, como se explica más adelante.
-
Análisis y subsanación. Hasta el 3 de junio, se llevará a cabo la revisión de la documentación presentada. En caso necesario, se contactará con los solicitantes para la subsanación de errores.
-
Valoración y deliberación. Un jurado evaluará todos los proyectos admitidos, según los criterios establecidos en las bases de la convocatoria. Se tendrá en cuenta su utilidad, valor económico, valor social y contribución a la transparencia; su grado de innovación y creatividad; la variedad de conjuntos de datos utilizados del Portal de Datos Abiertos de Madrid; y su calidad técnica. Esta fase se extenderá hasta el 15 septiembre.
-
Resolución. En los meses de septiembre y octubre se llevará a cabo la propuesta de concesión y publicación oficial de la resolución.
-
Entrega de premios. Los galardones se entregarán en un acto público, estimado para el mes de noviembre.
La página oficial irá actualizando fechas y documentación a medida que avance el proceso.
Cómo se presentan las candidaturas
Como se mencionó anteriormente, las candidaturas se pueden presentar de manera telemática o presencial:
- En línea, a través de la sede electrónica del Ayuntamiento de Madrid. Para ello se requiere identificación y firma electrónica.
- Presencialmente, en las oficinas de asistencia en materia de registro del Ayuntamiento de Madrid, así como en los registros de otras administraciones públicas.
Las personas físicas podrán presentar la solicitud de ambas formas, mientras que las personas jurídicas solo podrán presentar la solicitud de forma telemática.
En ambos casos, las candidaturas deben incluir:
- Formulario oficial de solicitud, a descargar en la sede electrónica del Ayuntamiento de Madrid.
- Memoria del proyecto, en base a un modelo a descargar en la citada sede electrónica. Este documento incluirá el título, la autoría y una descripción detallada, así como la relación de conjuntos de datos utilizados, los objetivos, el público beneficiario, el impacto previsto, el grado de innovación y la tecnología empleada.
- Declaración responsable.
- Acuerdo de colaboración, en caso de presentarse como agrupación.
Inspírate con los proyectos ganadores de la primera edición
La segunda edición de los Premios a la Reutilización de Datos Abiertos llega precedida por el éxito de la convocatoria anterior. En 2025, el Ayuntamiento de Madrid celebró la primera edición de estos galardones, que reunió 65 candidaturas de gran calidad y diversidad. Entre ellas destacaron propuestas impulsadas por estudiantes universitarios, startups, equipos multidisciplinares y ciudadanía comprometida con el uso inteligente de los datos públicos.
Los proyectos premiados demostraron que los datos abiertos pueden convertirse en herramientas reales para mejorar la vida urbana, impulsar la transparencia y generar conocimiento útil para la ciudad. En este artículo te resumimos en qué consistían estos proyectos.
En resumen, los II Premios a la Reutilización de Datos Abiertos 2026 son una oportunidad para demostrar cómo los datos públicos pueden convertirse en innovación real. Una invitación a desarrollar proyectos que impulsen un Madrid más inteligente, transparente y participativo.
Blog
La visualización de datos no es una disciplina reciente. Desde hace siglos, las personas han utilizado gráficos, mapas y esquemas para representar información compleja. Ejemplos clásicos como los mapas estadísticos del siglo XIX o los gráficos utilizados en la prensa muestran que la necesidad de “ver” los datos para entenderlos ha existido siempre.
Durante mucho tiempo, la creación de visualizaciones requería conocimientos especializados y acceso a herramientas profesionales, lo que limitaba su producción a perfiles muy concretos. Sin embargo, la revolución digital y tecnológica ha transformado profundamente este panorama. En la actualidad, cualquier persona con acceso a un ordenador y a datos puede crear visualizaciones. Las herramientas se han democratizado, muchas de ellas son gratuitas o de código abierto, y el trabajo de visualización se ha extendido más allá del diseño para integrarse en ámbitos como la estadística, la ciencia de datos, la investigación académica, la administración pública o la educación.
Hoy en día, la visualización de datos es una competencia transversal que permite a la ciudadanía explorar información pública, a las instituciones comunicar mejor sus políticas y a los reutilizadores generar nuevos servicios y conocimientos a partir de los datos abiertos. En este post presentamos algunas de las opciones más accesibles y utilizadas en visualización de datos.
Un ecosistema amplio y diverso de herramientas
El ecosistema de herramientas de visualización de datos es amplio y diverso, tanto en funcionalidades como en niveles de complejidad. Existen opciones pensadas para una primera exploración de los datos, otras orientadas al análisis en profundidad y algunas diseñadas para crear visualizaciones interactivas o narrativas digitales complejas.
Esta variedad permite adaptar la visualización a distintos contextos y objetivos: desde comprender un conjunto de datos de forma preliminar hasta publicar gráficos interactivos, paneles de control o mapas en la web.
La encuesta anual de la Data Visualization Society refleja esta diversidad y muestra cómo el uso de determinadas herramientas evoluciona con el tiempo, consolidando algunas opciones ampliamente conocidas y dando paso a nuevas soluciones que responden a necesidades emergentes. Estas son algunas de las herramientas que se mencionan en la encuesta, ordenadas según perfiles de uso.
Para la elaboración de este listado se ha tenido en cuenta los siguientes criterios:
- Grado de uso y madurez de la herramienta.
- Acceso libre, gratuito o con versiones abiertas.
- Utilidad para proyectos relacionados con datos públicos.
- Prioridad a herramientas abiertas o con versiones gratuitas.
Herramientas sencillas para empezar
Estas herramientas se caracterizan por contar con interfaces visuales, una curva de aprendizaje baja y la posibilidad de crear gráficos básicos de forma rápida. Son especialmente útiles para comenzar a explorar conjuntos de datos abiertos o para actividades de divulgación.
- Excel: es una de las herramientas más extendidas y conocidas. Permite realizar gráficos básicos y primeras exploraciones de datos de forma sencilla. Aunque no está diseñada específicamente para la visualización avanzada, sigue siendo una puerta de entrada habitual al trabajo con datos y su representación gráfica.
- Google Sheets: funciona como una alternativa gratuita y colaborativa a Excel. Su principal ventaja es la posibilidad de trabajar de forma compartida y publicar gráficos sencillos en línea, lo que facilita la difusión de visualizaciones básicas.
- Datawrapper: muy utilizada en comunicación pública y periodismo de datos. Permite crear gráficos claros, mapas y tablas interactivas sin necesidad de conocimientos técnicos. Es especialmente adecuada para explicar datos de forma comprensible a un público amplio.
- RAWGraphs: herramienta de software libre orientada a la exploración visual. Permite experimentar con tipos de gráficos menos habituales y descubrir nuevas formas de representar datos. Resulta especialmente útil en fases exploratorias.
- Canva: aunque su enfoque es más divulgativo que analítico, puede ser útil para crear piezas visuales sencillas que integren gráficos básicos con elementos de diseño. Es adecuada para la comunicación visual de resultados, no tanto para el análisis de datos.
Herramientas de análisis y exploración de datos
Este grupo de herramientas está orientado a perfiles que desean ir más allá de los gráficos básicos y realizar análisis más estructurados. Muchas de ellas son abiertas y están ampliamente consolidadas en el ámbito del análisis de datos.
- R: lenguaje de programación libre muy utilizado en estadística y análisis de datos. Dispone de un amplio ecosistema de paquetes que permiten trabajar con datos públicos de forma reproducible y transparente.
- Ggplot2: librería de visualización del lenguaje R. Es una de las herramientas más potentes para crear gráficos rigurosos y bien estructurados, tanto para análisis como para comunicación de resultados.
- Python (Matplotlib y Plotly): Python es uno de los lenguajes más utilizados en análisis de datos. Matplotlib permite crear gráficos estáticos personalizables, mientras que Plotly facilita la creación de visualizaciones interactivas. Juntas ofrecen un buen equilibrio entre potencia y flexibilidad.
- Apache Superset: plataforma de código abierto para análisis de datos y creación de paneles de control. Tiene un enfoque más institucional y escalable, lo que la hace adecuada para organizaciones que trabajan con grandes volúmenes de datos públicos.
Este bloque resulta especialmente relevante para reutilizadores de datos abiertos y perfiles técnicos intermedios que buscan combinar análisis y visualización de forma sistemática.
Herramientas para visualización interactiva y web
Estas herramientas permiten crear visualizaciones avanzadas para su publicación en entornos web. Aunque requieren mayores conocimientos técnicos, ofrecen una gran flexibilidad y posibilidades expresivas.
- D3.js: es uno de los referentes en visualización web. Se basa en estándares abiertos y permite un control total sobre la representación visual de los datos. Su flexibilidad es muy alta, aunque también lo es su complejidad.
En este ejercicio práctico puedes ver cómo se utiliza esta librería
- Vega y Vega-Lite: lenguajes declarativos para visualización que simplifican el uso de D3. Permiten definir gráficos de forma estructurada y reproducible, ofreciendo un buen equilibrio entre potencia y simplicidad.
- Observable: entorno interactivo muy ligado a D3 y Vega. Es especialmente útil para crear ejemplos educativos, prototipos y visualizaciones exploratorias que combinan código, texto y gráficos.
- Three.js y WebGL: tecnologías orientadas a visualizaciones avanzadas y en tres dimensiones. Su uso es más experimental y suele estar vinculado a proyectos de divulgación o investigación visual.
En este apartado conviene destacar que, aunque las barreras técnicas son mayores, estas herramientas permiten crear experiencias interactivas ricas que pueden resultar muy eficaces para comunicar datos públicos complejos.
Herramientas de cartografía y datos geoespaciales
La visualización geográfica es especialmente relevante en el ámbito de los datos abiertos, ya que una gran parte de la información pública tiene una dimensión territorial. En este campo, el software libre tiene un peso destacado y está muy alineado con el uso en administraciones públicas.
- QGIS: referente en software libre para sistemas de información geográfica (GIS). Es ampliamente utilizado en administraciones públicas y permite analizar y visualizar datos espaciales con gran detalle.
- ArcGIS: muy extendido en el ámbito institucional. Aunque no es software libre, su uso está muy consolidado y forma parte del ecosistema habitual de muchas organizaciones públicas.
- Mapbox: plataforma orientada a la creación de mapas web interactivos. Es muy utilizada en proyectos de visualización online y permite integrar datos geográficos en aplicaciones web.
- Leaflet: librería de código abierto muy popular para crear mapas interactivos en la web. Es ligera, flexible y ampliamente utilizada en proyectos de reutilización de datos abiertos geográficos.
Este conjunto de herramientas facilita la representación territorial de los datos y su reutilización en contextos locales, regionales o nacionales.
En conclusión, la elección de una herramienta de visualización depende en gran medida del objetivo que se persiga. No es lo mismo aprender y experimentar que analizar datos en profundidad o comunicar resultados a un público amplio. Por ello, resulta útil reflexionar previamente sobre el tipo de datos disponibles, el público al que se dirige la visualización y el mensaje que se quiere transmitir.
Apostar por herramientas accesibles y abiertas permite que más personas puedan explorar, interpretar y comunicar datos públicos. En este sentido, visualizar datos es también una forma de acercar la información a la ciudadanía y fomentar su reutilización.
Blog
Las visualizaciones de datos actúan como puentes entre la información compleja y la comprensión humana. Un gráfico bien diseñado puede comunicar en segundos datos que llevaría minutos o incluso horas descifrar en formato tabular. Más aún, las visualizaciones interactivas permiten a cada usuario explorar los datos desde su propia perspectiva, filtrando, comparando y descubriendo insights personalizados.
Para alcanzar estos fines existen múltiples herramientas, algunas de las cuales hemos abordado en ocasiones anteriores. Hoy nos acercamos a un nuevo ejemplo: la librería gratuita D3.js. En este post te explicamos cómo permite generar visualizaciones de datos útiles y atractivas junto con la herramienta de código abierto Observable.
¿Qué es D3?
D3.js (Data-Driven Documents) es una biblioteca de JavaScript que permite crear visualizaciones de datos personalizadas en navegadores web. A diferencia de herramientas que ofrecen gráficos predefinidos, D3.js proporciona los elementos fundamentales para construir prácticamente cualquier tipo de visualización imaginable.
La biblioteca es completamente gratuita y de código abierto, publicada bajo licencia BSD, lo que significa que cualquier persona u organización puede utilizarla, modificarla y distribuirla sin restricciones. Esta característica ha contribuido a su adopción generalizada: medios de comunicación internacionales como The New York Times, The Guardian, Financial Times y locales como El País o el ABC utilizan D3.js para crear visualizaciones periodísticas que ayudan a contar historias con datos.
D3.js funciona manipulando el DOM (Document Object Model) del navegador. En términos prácticos, esto significa que toma información (por ejemplo, un archivo CSV con datos de población) y la transforma en elementos visuales (círculos, barras, líneas) que el navegador puede mostrar. La potencia de D3.js reside en su flexibilidad: no impone una forma específica de visualizar datos, sino que proporciona las herramientas para crear exactamente lo que se necesita.
¿Qué es Observable?
Observable es una plataforma web para crear y compartir código, especialmente diseñada para trabajar con datos y visualizaciones. Aunque ofrece un servicio freemium con algunas funcionalidades gratuitas y otras de pago, mantiene una filosofía de código abierto que resulta particularmente relevante para el trabajo con datos públicos.
La característica distintiva de Observable es su formato de "cuadernos computacionales" (notebooks). Similar a herramientas como Jupyter Notebooks en Python, un cuaderno de Observable combina código, visualizaciones y texto explicativo en un mismo documento interactivo. Cada celda del cuaderno puede contener código JavaScript que se ejecuta inmediatamente, mostrando resultados al instante. Esto crea un entorno de experimentación ideal para explorar datos.
Puedes verlo en la práctica en este ejercicio de ciencia de datos que hemos publicado en datos.gob.es
Observable se integra naturalmente con D3.js y otras bibliotecas de visualización. De hecho, el creador de D3.js, es también uno de los fundadores de Observable, por lo que ambas herramientas trabajan conjuntamente de manera fluida. Los cuadernos de Observable pueden compartirse públicamente, permitiendo que otros usuarios vean tanto el código como los resultados, los bifurquen (fork) para crear sus propias versiones, o los integren en sus propios proyectos.
Ventajas de la herramienta para trabajar con todo tipo de datos
Tanto D3.js como Observable presentan características que pueden resultar útiles para trabajar con datos, entre ellos, con datos abiertos:
- Transparencia y reproducibilidad: al publicar una visualización creada con estas herramientas es posible compartir tanto el resultado final como todo el proceso de transformación de datos. Cualquier persona puede inspeccionar el código, verificar los cálculos y reproducir los resultados. Esta transparencia resulta fundamental cuando se trabaja con información pública, donde la confianza y la verificabilidad son esenciales.
- Sin costes de licencia: tanto D3.js como la versión gratuita de Observable permiten crear y publicar visualizaciones sin necesidad de adquirir licencias de software. Esto elimina barreras económicas para organizaciones, periodistas, investigadores o ciudadanos que desean trabajar con datos abiertos.
- Formatos web estándar: las visualizaciones creadas funcionan directamente en navegadores web sin necesidad de plugins o software adicional. Esto facilita su integración en sitios web institucionales, artículos periodísticos o informes digitales, haciéndolas accesibles desde cualquier dispositivo.
- Comunidad y recursos: existe una amplia comunidad de usuarios que comparten ejemplos, tutoriales y soluciones a problemas comunes. Observable, en particular, alberga miles de cuadernos públicos que sirven como ejemplos y plantillas reutilizables.
- Flexibilidad técnica: a diferencia de herramientas con opciones predefinidas, estas bibliotecas permiten crear visualizaciones completamente personalizadas que se adapten exactamente a las necesidades específicas de cada conjunto de datos o historia que se quiera contar.
Es importante señalar que estas herramientas requieren conocimientos de programación, específicamente de JavaScript. Para personas sin experiencia en programación, existe una curva de aprendizaje que puede resultar pronunciada inicialmente. Otras herramientas como hojas de cálculo o software de visualización con interfaces gráficas pueden ser más apropiadas para usuarios que buscan resultados rápidos sin necesidad de escribir código.
Para quienes buscan alternativas open source con una curva de aprendizaje suave, existen herramientas basadas en interfaz visual que no requieren programar. Por ejemplo, RawGraphs permite crear visualizaciones complejas simplemente arrastrando y soltando archivos, mientras que Datawrapper es una opción excelente y muy intuitiva para generar gráficos y mapas listos para publicar.
Además, existen numerosas alternativas tanto de código abierto como comerciales para visualizar datos: Python con bibliotecas como Matplotlib o Plotly, R con ggplot2, Tableau Public, Power BI, entre muchas otras. En la sección didáctica de ejercicios de visualización y ciencia de datos de datos.gob.es puedes encontrar ejemplos prácticos de uso de algunas de ellas.
En resumen, la elección de herramientas debe basarse siempre en una evaluación de requisitos específicos, recursos disponibles y objetivos del proyecto. Lo importante es que los datos abiertos se transformen en conocimiento accesible, y existen múltiples caminos para lograr este objetivo. D3.js y Observable ofrecen uno de estos caminos, particularmente adecuado para quienes buscan combinar flexibilidad técnica con principios de apertura y transparencia. Si conoces alguna otra herramienta o te gustaría que profundizáramos en otra temática, háznosla llegar a través de nuestras redes sociales o en el formulario de contacto.
Documentación
Introducción
Cada año se producen en España decenas de miles de accidentes, en los que miles de personas resultan heridas de diversa consideración, y que ocurren en circunstancias muy diversas, tanto de tipo de vía, como por el tipo de accidente.
Muchas de las estadísticas relacionadas con estos parámetros están recogidas en las bases de datos de la Dirección General de Tráfico (DGT) y algunas de ellas en el catálogo albergado en datos.gob.es.
En este ejercicio examinaremos el contenido de la base de datos de siniestralidad de la DGT para el año 2024 con el fin de realizar una serie de visualizaciones básicas que nos permitan ver de forma rápida e intuitiva cuáles son los hechos a destacar respecto a la incidencia de accidentes y sus consecuencias en ese año.
Para ello vamos a desarrollar código en Python que nos permita la lectura y cálculo de métricas básicas respecto al número total de víctimas, las particularidades de las infraestructuras así como las diferentes casuísticas de los accidentes. Y una vez tengamos disponibles esos datos, los visualizaremos utilizando la librería de Javascript D3.js, que nos permite tanto la representación de datos en su forma más tradicional como en diseños más contemporáneos, habituales en la prensa, favoreciendo así una narrativa fluída en estilo y coherente en contenido.
En el entorno de Python utilizaremos librerías de uso común y frecuente como son Numpy, para el cálculo básico - sumas, máximos y mínimos-, y Pandas, para estructurar los datos de forma intuitiva, facilitando tanto su organización como su transformación. Igualmente trabajaremos con Datetime, tanto para el formateo de los datos de entrada en tipos de fecha estándares dentro del mundo de la programación en Python, como para agregar los datos de forma fácil e intuitiva. De esta forma aprenderemos a abrir cualquier tipo de fichero de datos en formato .CSV, a estructurarlo de forma ordenada y a realizar transformaciones y operaciones básicas de forma sencilla.
En el entorno de Javascript desarrollaremos notebooks en D3.js gracias al uso de Observable, una iniciativa abierta y gratuita, para poder ejecutar código de Javascript directamente en un interfaz web, y sin tener que recurrir a servidores locales o complejas instalaciones. En diferentes notebooks crearemos visualizaciones clásicas -como las series temporales en ejes cartesianos o mapas- junto con otras propuestas tales como distribuciones de burbujas o elementos apilados por categorías.
En la Figura 1 se pueden ver las principales etapas de este ejercicio, desde la lectura de los datos dentro del fichero de la DGT, hasta las operaciones y las variables de salida en formato JSON, que nos servirán a su vez en un entorno Javascript para poder desarrollar las visualizaciones en D3.js.
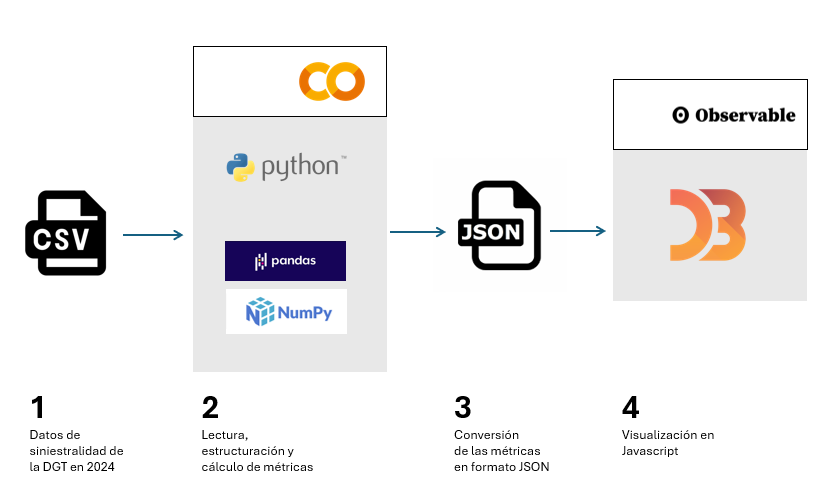
Figura 1. Pasos en los cuales se estructura este ejercicio, con punto de partida en la base de datos de la DGT, el procesado y manipulación de esos datos en Python, la creación de ficheros de salida en formato JSON y su uso en Javascript para visualizar los resultados.
El acceso al repositorio de Github, el notebook de Google Colab y los notebooks de Observable se pueden realizar a través de los siguientes enlaces:
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Accede a los notebooks de Observable
Proceso de Desarrollo
1. Lectura del fichero de datos
El primer paso será leer el fichero de la DGT que contiene todos los registros de accidentes del año 2024. Este paso nos permitirá identificar los campos de interés y sobre todo en qué formato se encuentran. Podremos identificar si se precisa de alguna transformación sobre todo en la información de la fecha, tal y como está estructurada en el fichero de origen.
Igualmente veremos cómo traducir los códigos de muchas de las categorías que nos ofrece la DGT, de modo que podamos hacer una interpretación real más allá de los números de categorías como tipo de accidente, tipo de vía o titularidad de la vía.
Una vez entendemos la estructura y contenido de los datos podemos empezar a operar con ellos.
2. Cálculo de métricas
La librería Pandas de Python nos permite operar con las diferentes columnas de datos y realizar cálculos básicos que serán suficientemente representativos para entender mínimamente la casuística de los accidentes en las carreteras españolas.
En este apartado se realizarán tres tipos de cálculos.
- El primero de ellos será el cálculo del número total de víctimas por hora del día para cada uno de los días de la semana. La base de datos de la DGT viene estructurada por día de la semana, de forma que utilizaremos también esa escala temporal para representar los datos en una serie. Cabe hacer notar que por víctima se considera toda aquella persona que ha fallecido o que sea diagnosticada como herida grave o leve.
- El segundo cálculo será la suma total de accidentes para diferentes categorías, tales como la titularidad de la vía, el tipo de accidente o el tipo de vía. Esto nos permitirá ver cuáles son las condiciones en las cuales los accidentes son más frecuentes.
- El tercer cálculo será el de número de accidentes por municipio. En este caso realizaremos el cálculo restringido a la provincia de Valencia como ejemplo, y que sería aplicable a cualquier provincia o municipio de nuestro interés. En este caso observaremos las diferencias entre los núcleos urbanos y no urbanos, así como aquellos municipios por los que pasan las principales vías de comunicación.
3. Diseño de las visualizaciones
Una vez hemos calculado las métricas de interés, desarrollaremos cinco ejercicios de visualización en D3.js. Para ello exportaremos en formato JSON el resultado de las métricas y crearemos notebooks en Observable. En concreto realizamos las siguientes visualizaciones:
- Serie temporal con el número total de víctimas en cada hora y día de la semana, con un menú desplegable interactivo para seleccionar el día de la semana de interés. A mayores de la curva que describe el número de víctimas dibujaremos sobre el fondo de la gráfica la incertidumbre de todos los días de la semana, de forma que la serie temporal diaria queda enmarcada en el contexto de toda la semana como referencia.
- Mapa de la provincia de Valencia con el número total de accidentes por municipio.
- Diagrama de burbujas, con las diferentes magnitudes de los diferentes tipos de accidentes con el número total de accidentes en cada caso escrita de forma detallada.
- Diagrama de puntos apilados, donde acumulamos círculos o cualquier otra forma geométrica para las diferentes titularidades de la vía y su número total de accidentes dentro del marco de cada titularidad.
- Diagrama de sierra, con la altura de cada montaña correspondiente al número de accidentes en cada tipo de vía en escala logarítmica.
Visualización de las métricas
El resultado de este ejercicio se podrá ver de forma gráfica y explícita en forma de visualizaciones realizadas para el formato web y accesibles desde una interfaz también web, tanto para su desarrollo como para su posterior publicación. Todo el conjunto de visualizaciones se encuentra en el repositorio de Datos.gob.es en Observable:
Accede a los notebooks de Observable
En la Figura 2 tenemos el resultado de la serie temporal del total de víctimas respecto a la hora del día para diferentes días de la semana. La serie temporal está enmarcada dentro de la incertidumbre del total de días de la semana, para dar una idea del margen de variabilidad que podemos tener dependiendo de la hora del día.
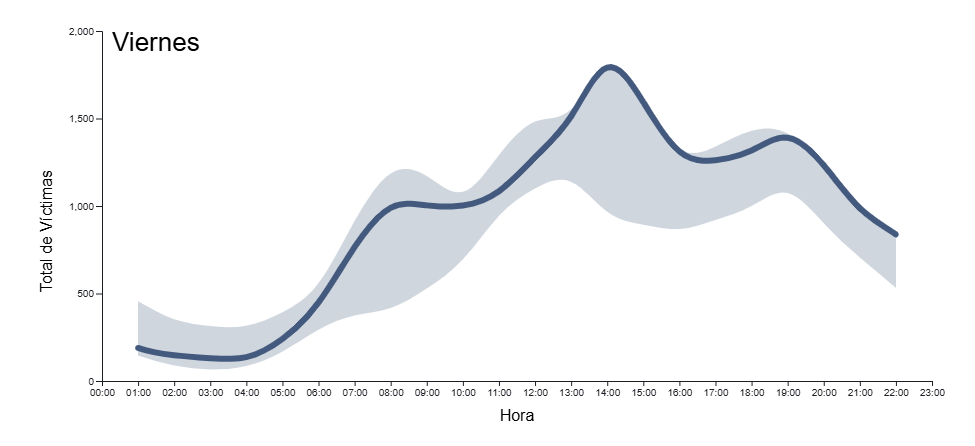
Figura 2. Serie temporal del total de víctimas en accidentes por hora del día para todos los días de la semana en 2024. En el fondo en color azul claro se indica la incertidumbre asociada a todos los días de la semana como contexto, con menú desplegable para seleccionar el día de la semana.
En la Figura 3 podemos observar el mapa de la provincia de Valencia con una intensidad de color proporcional al número de accidentes en cada municipio. Aquellos municipios en los cuales no se han registrado accidentes aparecen en color blanco. De forma intuitiva se puede adivinar el trazado de las principales carreteras que atraviesan la provincia, tanto la carretera hacia el este de la ciudad de Valencia en dirección Madrid como la carretera del interior hacia el sur de la ciudad en dirección a Alicante.
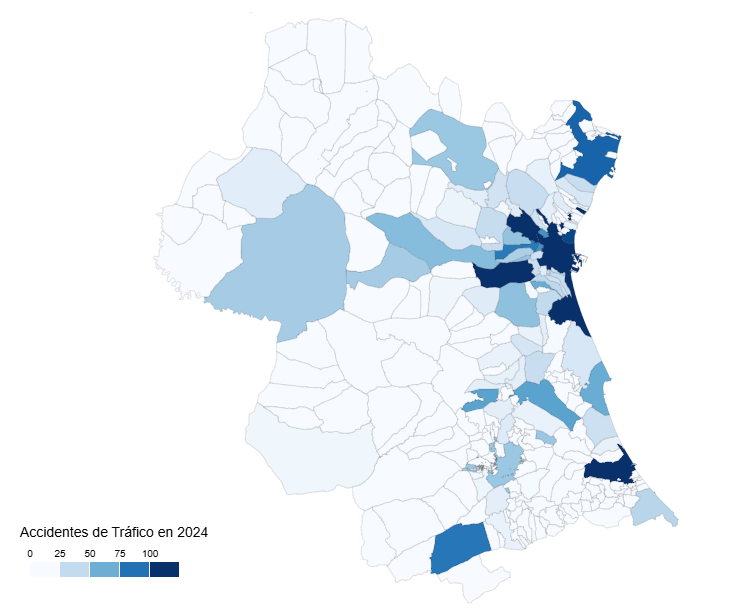
Figura 3. Mapa del número de accidentes por municipio en la provincia de Valencia en 2024.
En la Figura 4 vemos una forma geométrica, el círculo, asociada a los tipos de accidente, con el detalle del número de accidentes asociada a cada categoría. En este tipo de visualización emerge de forma natural aquellos accidentes más frecuentes en torno al centro del diagrama, mientras que aquellos minoritarios o residuales ocupan el perímetro del diagrama para dar igualmente una forma redonda al conjunto de formas.
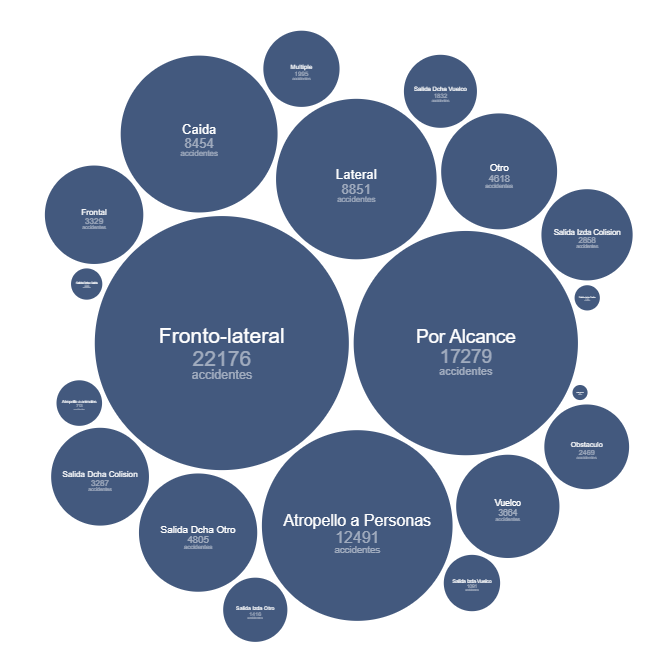
Figura 4. Diagrama de burbujas del número de accidentes por tipo de accidente en 2024.
En la Figura 5 se puede contemplar el tradicional diagrama de barras pero esta vez descompuesto en unidades más pequeñas, para afinar la cantidad de accidentes asociada a la titularidad de la vía donde han sucedido. Este tipo de diagramas permite discernir pequeñas diferencias entre magnitudes parecidas, preservando el mensaje general que obtenemos de un cálculo de estas características.
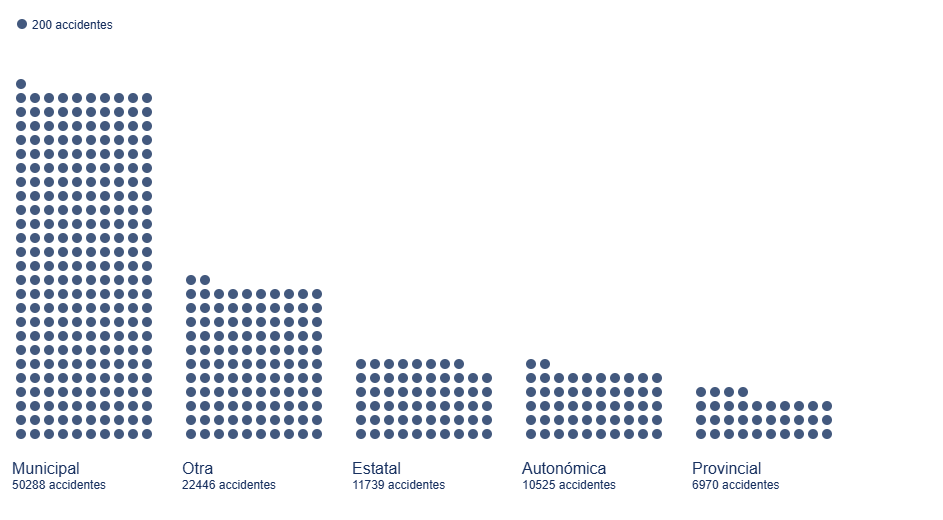
Figura 5. Diagrama de barras con discretización de puntos para el número de accidentes por titularidad de la vía en el 2024.
En la Figura 6 creamos una serie de formas geométricas que replican una cordillera o sierra donde los diferentes picos apuntan a la diferencia de número de accidentes por tipo de vía. Dada la diferencia en órdenes de magnitud establecemos una escala logarítmica, que permita comparar en el mismo diagrama diferentes casuísticas.
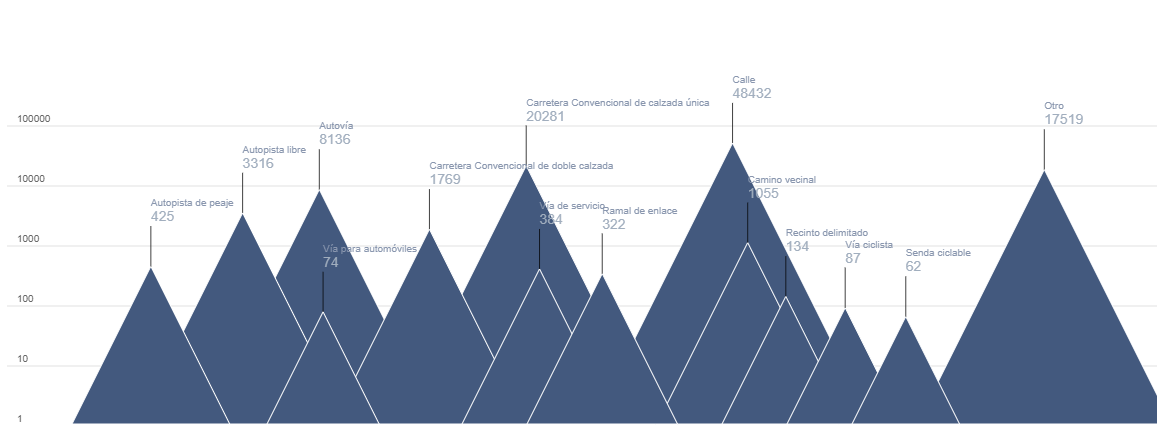
Figura 6. Diagrama en cordillera para los diferentes órdenes de magnitud del número de accidentes por tipo de vía en el 2024.
Lecciones aprendidas
A través de estos pasos aprenderemos toda una serie de habilidades transversales que nos permiten trabajar con aquellos conjunto de datos que se nos presentan en formato CSV en columnas, un formato muy popular para el cual podremos realizar tanto su análisis como su visualización. Estas lecciones son en concreto:
- Universalidad de lectura y estructuración de datos: el uso de herramientas como Python, con sus librerías Numpy y Pandas, permiten acceder a los datos en detalle y estructurarlos de forma ordenada e intuitiva con pocas líneas de código.
- Cálculos sencillos en Pandas: la propia librería de Python permite cálculos sencillos pero esenciales para la interpretación preliminar de resultados.
- Formato Datetime: a través de esta librería de Python podemos familiarizarnos con el estándar del formato de fecha, y así realizar todo tipo de transformaciones, filtros y selecciones que más nos interesen en cualquier intervalo temporal.
- Formato JSON: una vez que decidimos dar espacio a nuestras visualizaciones en la web, aprender la estructura y uso del formato JSON es de gran utilidad dado su amplio uso en todo tipo de aplicaciones y arquitecturas web.
- Espectro de posibilidades de D3.js: esta librería de Javascript nos permite explorar de lo más tradicional y conservador a lo más creativo gracias a sus principios basados en las formas más básicas, sin plantillas, templates o diagramas predefinidos.
Conclusiones y próximos pasos
Hemos aprendido a leer y a estructurar datos según los estándares de los formatos más utilizados en el mundo del análisis y visualización. Este ejercicio también sirve como módulo introductorio al mundo de D3.js, una herramienta muy versátil, vigente y popular dentro del mundo del storytelling y la visualización de datos a todos los niveles.
Para poder avanzar en este ejercicio se recomienda:
- Para los analistas y desarrolladores, se puede prescindir de la librería Pandas y estructurar los datos con objetos más elementales de Python como arrays y matrices, buscando qué funciones y qué operadores permiten realizar las mismas tareas que hace Pandas pero de una forma más fundamental, sobre todo si pensamos en entornos de producción para los cuales necesitamos el menor número de librerías posibles para aligerar la aplicación.
- Para los creadores de visualizaciones, la información sobre los municipios puede proyectarse igualmente sobre bases cartográficas ya existentes como OpenStreetMap y de esta forma vincular la incidencia de accidentes a características orográficas o infraestructuras ya reflejadas en esas bases cartográficas. Para las magnitudes de los números de accidentes se pueden explorar diagramas de tipo Treemap o diagramas de Voronoi y ver si transmiten el mismo mensaje que los que presentamos en este ejercicio.
Ámbitos de aplicación
Los pasos descritos en este ejercicio pueden pasar a formar parte de cualquier caja de herramientas de uso habitual para los siguientes perfiles:
- Analistas de datos: aquí se encuentran los pasos básicos para la descripción de un fichero de datos en formato CSV y los cálculos básicos a realizar tanto en el campo de la fecha como de operaciones entre variables de diferentes columnas. Estas herramientas pueden servir para introducirse en el mundo del análisis de datos y ayuda en esos primeros pasos a la hora de enfrentarse a un dataset.
- Científicos y personal investigador: la universalidad de las herramientas aquí descritas aplican a una gran variedad de origen de datos, como el que se experimenta en las ciencias experimentales y de observaciones o medidas de todo tipo. Estas herramientas permiten un análisis rápido a la vez que riguroso sin importar el campo de conocimiento en el que se trabaje.
- Desarrolladores web: la exportación de datos en formato JSON así como el código en Javascript que se ofrece en los notebooks de Observable son fácilmente integrables en todo tipo de entornos (Svelte, React, Angular, Vue) y permite la creación de visualizaciones en una web de forma sencilla e intuitiva.
- Periodistas: abarcar todo el proceso de vida de un fichero de datos, desde su lectura a su visualización, otorga al periodista o investigador independencia a la hora de evaluar e interpretar los datos por sí mismo sin depender de recursos técnicos ajenos. La creación del mapa por municipios abre la puerta a utilizar cualquier otro dato similar, como por ejemplo procesos electorales, con el mismo formato de salida para mostrar variabilidad geográfica respecto a cualquier tipo de magnitud.
- Diseñadores Gráficos: el manejo de herramientas de visualización con un amplio grado de libertad permite a los diseñadores cultivar toda su creatividad dentro del rigor y la exactitud que los datos necesitan.
Aplicación
Esta visualización de datos interactiva busca poder consultar y comparar en detalle las partidas presupuestarias de 2025 por habitante y su desglose para las entidades locales de España, es decir los Ayuntamientos.
Son datos de presupuestos, las liquidaciones de la ejecución de los mismos se publicarán a finales de 2026.
Blog
La visualización de datos es una práctica fundamental para democratizar el acceso a la información pública. Sin embargo, crear gráficos efectivos va mucho más allá de elegir colores atractivos o utilizar las últimas herramientas tecnológicas. Como señala Alberto Cairo, experto en visualización de datos y docente de la academia del portal europeo de datos abiertos (data.europa.eu), “cada decisión de diseño debe ser deliberada: inevitablemente subjetiva, pero nunca arbitraria”. A través de una serie de tres webinar que puedes volver a ver aquí, el experto ofreció consejos innovadores para estar a la vanguardia de la visualización de datos.
Cuando trabajamos con visualización de datos, especialmente en el contexto de la información pública, es crucial desmontar algunos mitos arraigados en nuestra cultura profesional. Frases como "los datos hablan por sí mismos", "una imagen vale más que mil palabras" o "muestra, no cuentes" suenan bien, pero esconden una verdad incómoda: los gráficos no siempre comunican automáticamente.
La realidad es más compleja. Un/a profesional del diseño puede querer comunicar algo específico, pero los lectores pueden interpretar algo completamente diferente. ¿Cómo se puede superar la brecha entre intención y percepción en visualización de datos? En este post, ofrecemos algunas claves de la serie formativa.
Un marco estructurado para diseñar con propósito
En lugar de seguir "reglas" rígidas o aplicar plantillas predefinidas, en el curso se propone un marco de pensamiento basado en cinco componentes interrelacionados:
- Contenido: la naturaleza, origen y limitaciones de los datos
- Personas: la audiencia a la que nos dirigimos
- Intención: los propósitos que definimos
- Restricciones: las limitaciones que enfrentamos
- Resultados: cómo es recibido el gráfico
Este enfoque holístico nos obliga a preguntarnos constantemente: ¿qué necesitan realmente saber nuestros lectores? Por ejemplo, cuando comunicamos información sobre riesgos de huracanes o emergencias sanitarias, ¿es más importante mostrar trayectorias exactas o comunicar impactos potenciales? La respuesta correcta depende del contexto y, sobre todo, de las necesidades informativas de la ciudadanía.
El peligro de la agregación excesiva
Aún sin perder de vista el propósito es importante no caer en añadir demasiada información o presentar solo promedios. Imaginemos, por ejemplo, un conjunto de datos sobre seguridad ciudadana a nivel nacional: un promedio puede esconder que la mayoría de las localidades son muy seguras, mientras unas pocas con tasas extremadamente altas distorsionan el indicador nacional.
Como explica Claus O. Wilke en su libro "Fundamentals of Data Visualization", esta práctica puede ocultar patrones cruciales, valores atípicos y paradojas que son precisamente los más relevantes para la toma de decisiones. Para evitar este riesgo, en la formación se propone visualizar una gráfica como un sistema de capas que debemos construir cuidadosamente desde la base:
1. Codificación (Encoding)
- Es la base de todo: cómo traducimos datos en atributos visuales. Las investigaciones en percepción visual nos muestran que no todos los "canales visuales" son igual de efectivos. La jerarquía sería:
- Más efectivos: posición, longitud y altura
- Medianamente efectivos: ángulo, área y pendiente
- Menos efectivos: color, saturación y forma
¿Cómo ponemos esto en práctica? Pues, por ejemplo, para realizar comparaciones precisas, un gráfico de barras será casi siempre mejor opción que un gráfico circular. Sin embargo, como se matiza en los materiales formativos, "efectivo" no siempre significa "apropiado". Un gráfico circular puede ser perfecto cuando queremos expresar la idea de un "todo y sus partes", aunque las comparaciones precisas sean más difíciles.
2. Disposición (Arrangement)
El posicionamiento, orden y agrupación de los elementos afecta profundamente a la percepción. ¿Queremos que el lector compare entre categorías dentro de un grupo, o entre grupos? La respuesta determinará si organizamos nuestra visualización con barras agrupadas o apiladas, con paneles múltiples o en una única vista integrada.
3. Andamiaje (Scaffolding)
Los títulos, introducciones, anotaciones, escalas y leyendas son fundamentales. En datos.gob.es hemos visto cómo las visualizaciones interactivas pueden condensar información compleja, pero sin un andamiaje adecuado, la interactividad puede confundir más que aclarar.
El valor de una correcta escala
Uno de los aspectos técnicos más delicados —y a menudo más manipulables— de una visualización es la elección de la escala. Una simple modificación en el eje Y puede cambiar por completo la interpretación del lector: una tendencia suave puede parecer una crisis repentina, o un crecimiento sostenido puede pasar desapercibido.
Como se menciona en el segundo webinar de la serie, las escalas no son un detalle menor: son un componente narrativo. Decidir dónde empieza un eje, qué intervalos se usan o cómo se representan los periodos de tiempo implica hacer elecciones que afectan directamente la percepción de la realidad. Por ejemplo, si una gráfica de empleo comienza el eje Y en 90 % en lugar de 0 %, el descenso puede parecer dramático, aunque, en realidad, sea mínimo.
Por eso, las escalas deben ser honestas con los datos. Ser “honesto” no significa renunciar a decisiones de diseño, sino mostrar claramente qué decisiones se tomaron y por qué. Si existe una razón válida para empezar el eje Y en un valor distinto de cero, debe explicarse explícitamente en la gráfica o en su pie de texto. La transparencia debe prevalecer sobre el dramatismo.
La integridad visual no solo protege al lector de interpretaciones engañosas, sino que refuerza la credibilidad de quien comunica. En el ámbito de los datos públicos, esa honestidad no es opcional: es un compromiso ético con la verdad y con la confianza ciudadana.
Accesibilidad: visualizar para todos
Por otro lado, uno de los aspectos frecuentemente olvidado es la accesibilidad. Aproximadamente el 8 % de los hombres y el 0,5 % de las mujeres tienen algún tipo de daltonismo. Herramientas como Color Oracle permiten simular cómo se ven nuestras visualizaciones para personas con diferentes tipos de deficiencias en la percepción del color.
Además, en el webinar se mencionó el proyecto Chartability, una metodología para evaluar la accesibilidad de las visualizaciones de datos. En el sector público español, donde la accesibilidad web es un requisito legal, esto no es opcional: es una obligación democrática. Bajo esta premisa publicó la Federación Española de Municipios y Provincias publicó una Guía de Visualización de Datos para Entidades Locales.
Narrativa visual: cuando los datos cuentan historias
Una vez resueltas las cuestiones técnicas, podemos abordar el aspecto narrativo que cada día es más importante para comunicar correctamente. En este sentido, el curso plantea un método sencillo pero poderoso:
- Escribe una frase larga que resuma los puntos que quieres comunicar.
- Divide esa frase en componentes, aprovechando las pausas naturales.
- Transforma esos componentes en secciones de tu infografía.
Este enfoque narrativo es especialmente efectivo para proyectos como los que encontramos en data.europa.eu, donde se combinan visualizaciones con explicaciones contextuales para comunicar el valor de los conjuntos de datos de alto valor o en los ejercicios de visualización y ciencia de datos de datos de datos.gob.es.
El futuro de la visualización de datos también incluye aproximaciones más creativas y centradas en el usuario. Proyectos que incorporan elementos personalizados, que permiten a los lectores situarse en el centro de la información, o que utilizan técnicas narrativas para generar empatía, están redefiniendo lo que entendemos por "comunicación de datos".
Incluso emergen formas alternativas de "sensificación de datos": la fisicalización (crear objetos tridimensionales con datos) y la sonificación (traducir datos a sonido) abren nuevas posibilidades para hacer la información más tangible y accesible. La empresa española Tangible Data, de la que nos hacemos eco en datos.gob.es porque reutiliza conjuntos de datos abiertos, es prueba de ello.
Figura 1. Ejemplos de sensificación de datos. Fuente: https://data.europa.eu/sites/default/files/course/webinar-data-visualisation-episode-3-slides.pdf
A modo de conclusión, podemos resaltar que la integridad en el diseño no es un lujo: es un requisito ético. Cada gráfico que publicamos en plataformas oficiales influye en cómo los ciudadanos perciben la realidad y toman decisiones. Por eso, dominar herramientas técnicas como las bibliotecas y API de visualización, que se analizan en otros artículos del portal, es tan relevante.
La próxima vez que crees una visualización con datos abiertos, no te preguntes solo "¿qué herramienta uso?" o "¿qué gráfico se ve mejor?". Pregúntate: ¿qué necesita realmente saber mi audiencia? ¿Esta visualización respeta la integridad de los datos? ¿Es accesible para todos? Las respuestas a estas preguntas son las que transforman un gráfico bonito en una herramienta de comunicación verdaderamente efectiva.
Blog
Imagina que quieres saber cuántas terrazas hay en tu barrio, cómo evolucionan los niveles de polen del aire que respiras cada día o si el reciclaje en tu ciudad está funcionando bien. Toda esa información existe en las bases de datos de tu ayuntamiento, pero se encuentra entre hojas de cálculo y documentos técnicos que solo los expertos sabían interpretar.
Aquí es donde entran en juego las iniciativas de visualización de datos abiertos: transforman esos números aparentemente fríos en historias que cualquier persona puede entender de un vistazo. Un gráfico colorido que muestra la evolución del tráfico en tu calle, un mapa interactivo con las zonas verdes de tu ciudad, o una infografía que explica en qué se gasta el presupuesto municipal. Estas herramientas convierten la información pública en algo cercano, útil y, además, comprensible para toda la ciudadanía.
Además, las ventajas de este tipo de soluciones no son solo para la ciudadanía, sino que también benefician a la Administración que realiza el ejercicio, porque permite:
- Detectar y corregir errores en los datos.
- Incorporar nuevos conjuntos al portal.
- Disminuir el número de preguntas del ciudadano.
- Generar más confianza por parte de la sociedad.
Por tanto, visualizar datos abiertos permite acercar la Administración a la ciudadanía, facilita la toma de decisiones informadas, ayuda a las Administraciones Públicas a mejorar su oferta de datos abiertos y permite crear una sociedad más participativa donde todos podemos entender mejor cómo funciona el sector público. En este post, te presentamos algunos ejemplos de iniciativas de visualización de open data en portales de datos abiertos autonómicos y municipales.
Visualiza Madrid: acercando los datos a la ciudadanía
El portal de datos abiertos del Ayuntamiento de Madrid ha desarrollado la iniciativa "Visualiza Madrid", un proyecto que nace con el objetivo específico de hacer que los datos abiertos y su potencial lleguen a la ciudadanía en general, trascendiendo los perfiles técnicos especializados. Tal y como explicó Ascensión Hidalgo Bellota, Subdirectora general de Transparencia del Ayuntamiento de Madrid, durante el IV Encuentro Nacional de Datos Abiertos, “esta iniciativa responde a la necesidad de democratizar el acceso a la información pública”.
Actualmente, Visualiza Madrid cuenta con 29 visualizaciones que abarcan diferentes temáticas de interés ciudadano, desde información sobre terrazas de hostelería hasta gestión de residuos y análisis del tráfico urbano. Esta diversidad temática demuestra la versatilidad de las visualizaciones como herramienta para comunicar información de sectores muy diversos de la administración pública.
Además, la iniciativa ha recibido este año un reconocimiento externo a través de los premios Audaz 2025, una iniciativa del capítulo español de la Red Académica de Gobierno Abierto (RAGA España).
Castilla y León: análisis integral de datos regionales
La Junta de Castilla y León también ha desarrollado un portal especializado en análisis y visualizaciones que destaca por su enfoque integral hacia la presentación de datos autonómicos. Su plataforma de visualizaciones ofrece una aproximación sistemática al análisis de información regional, permitiendo a los usuarios explorar diferentes dimensiones de la realidad de Castilla y León a través de herramientas interactivas y dinámicas.
Esta iniciativa permite presentar información compleja de manera estructurada y comprensible, facilitando tanto el análisis académico como el uso ciudadano de los datos. La plataforma integra diferentes fuentes de información autonómica, creando un ecosistema coherente de visualizaciones que permite obtener una visión panorámica de diversos aspectos de la gestión regional. Entre las temáticas que ofrece podemos mencionar datos de turismo, del mercado laboral o de la ejecución de los presupuestos. Todas las visualizaciones están realizadas con conjuntos de datos abiertos del portal autonómico de Castilla y León.
El enfoque de Castilla y León demuestra cómo las visualizaciones pueden servir como herramienta de análisis territorial, proporcionando insights valiosos sobre dinámicas económicas, sociales y demográficas que resultan fundamentales para la planificación y evaluación de políticas públicas regionales.
Canarias: integración tecnológica con widgets interactivos
Por otro lado, el Gobierno de Canarias ha apostado por una estrategia innovadora mediante la implementación de widgets que permiten la integración de visualizaciones de datos abiertos del Instituto Canario de Estadística (ISTAC) en diferentes plataformas y contextos. Esta aproximación tecnológica representa un salto cualitativo en la distribución y reutilización de visualizaciones de datos públicos.
Los widgets desarrollados por Canarias facilitan que terceros puedan incorporar visualizaciones oficiales en sus propias aplicaciones, sitios web o análisis, ampliando exponencialmente el alcance y la utilidad de los datos abiertos canarios. Esta estrategia no solo multiplica los puntos de acceso a la información pública, sino que también fomenta la creación de un ecosistema colaborativo donde diferentes actores pueden beneficiarse y contribuir al valor de los datos abiertos.
La iniciativa canaria ilustra cómo la tecnología puede ser utilizada para crear soluciones escalables y flexibles que maximicen el impacto de las inversiones en visualización de datos abiertos, estableciendo un modelo replicable para otras administraciones que busquen amplificar el alcance de sus iniciativas de transparencia.
Lecciones aprendidas y mejores prácticas
A modo de ejemplo, los casos analizados revelan patrones comunes que pueden servir como guía para futuras iniciativas. La orientación hacia la ciudadanía general, más allá de usuarios técnicos especializados, emerge como un factor de oportunidad para el éxito de estas plataformas. Para mantener el interés y la relevancia de las visualizaciones es importante ofrecer diversidad temática y actualizar los datos regularmente.
La integración tecnológica y la interoperabilidad, como demuestra el caso de Canarias, abren nuevas posibilidades para maximizar el impacto de las inversiones públicas en visualización de datos. Asimismo, el reconocimiento externo y la participación en redes profesionales, como evidencia el caso de Madrid, contribuyen a la mejora continua y al intercambio de mejores prácticas entre administraciones.
En términos generales, las iniciativas de visualización de datos abiertos representan una oportunidad muy valiosa en la estrategia de transparencia y gobierno abierto de las administraciones públicas españolas. Los casos de Madrid, Castilla y León, así como de Canarias, son ejemplo de que existe un potencial enorme para transformar datos públicos en herramientas de empoderamiento ciudadano y mejora de la gestión pública.
El éxito de estas iniciativas radica en su capacidad para conectar la información gubernamental con las necesidades reales de la ciudadanía, creando puentes de comprensión que fortalecen la relación entre administración y sociedad. A medida que estas experiencias maduren y se consoliden, será fundamental mantener el foco en la usabilidad, la accesibilidad y la relevancia de las visualizaciones, asegurando que los datos abiertos cumplan verdaderamente su promesa de contribuir a una sociedad más informada, participativa y democrática.
La visualización de datos abiertos no es solo una cuestión técnica, sino una oportunidad estratégica para redefinir la comunicación pública y fortalecer los cimientos de una Administración verdaderamente abierta y transparente.