Deporte
A dispoñibilidade de datos relacionados con este campo, como pode ser información sobre instalacións deportivas, federacións ou competicións, ten un impacto positivo na promoción da saúde e o benestar.


Descubre os conxuntos de datos máis notables
Imagen Media

Instalaciones deportivas - Balonmano
Descripción
Previsualización disponible en la siguiente URL de Geoportal https://callejero.ma
Imagen Media

Máquinas en zonas de musculación
Descripción
Estos ficheros contienen la localización de las zonas de musculación, dando a conocer, de forma sencilla y detallada, su correcto uso.
Imagen Media

Carril Bici
Descripción
Trazado de Carril Bici
Imagen Media

Registro de Entidades Deportivas
Descripción
El Registre d'Entitats Esportives de la Generalitat de Catalunya té com a finalitat la inscripció d’entitats esportives que tinguin la seu a Catalu
Imagen Media

Centros y Pabellones Deportivos
Descripción
Directorio de Centros y Pabellones Deportivos, públicos y privados, de la Ciudad de Zaragoza.
Imagen Media

Mostrar más…
Descripción
Búsqueda en el catálogo de datos.gob.es por la categoría Deporte
Temas de actualidade destacados
Actualidade
Proyectos ganadores de los concursos de datos de Euskadi y Castilla y León
Impulsar la cultura del dato es un objetivo clave a nivel nacional que también comparten las administraciones autonómicas. Uno de los caminos para llevar a cabo este propósito es premiar aquellas soluciones que han sido desarrolladas con conjuntos de datos abiertos, una iniciativa que potencia su reutilización e impacto en la sociedad.
En esta misión, la Junta de Castilla y León y el Gobierno Vasco llevan años organizando concursos de datos abiertos, temática de la que hablamos en nuestro primer episodio del pódcast de datos.gob.es que puedes escuchar aquí.
En este post, repasamos cuáles han sido los proyectos premiados en las últimas ediciones de los concursos de datos abiertos de Euskadi y Castilla y León.
Premiados en el VIII Concurso de Datos Abiertos de Castilla y León
En la octava edición de esta competición anual, que suele abrir su plazo a finales de verano, se presentaron 35 candidaturas, de las cuales se han escogido 8 ganadores divididos en diferentes categorías.
Categoría Ideas: los participantes tenían que describir una idea para crear estudios, servicios, sitios web o aplicaciones para dispositivos móviles. Se repartían un primer premio de 1.500€ y un segundo premio de 500€.
Primer premio: Guardianes Verdes de Castilla y León presentado por Sergio José Ruiz Sainz. Se trata de una propuesta para desarrollar una aplicación móvil que oriente a los visitantes de los parques naturales de Castilla y León. Los usuarios pueden acceder a información (como mapas interactivos con puntos de interés) a la vez que pueden contribuir con datos útiles de su visita, que enriquecen la aplicación.
Segundo premio: ParkNature: sistema inteligente de gestión de aparcamientos en espacios naturales presentado por Víctor Manuel Gutiérrez Martín. Consiste en una idea para la crear una aplicación que optimice la experiencia de los visitantes de los espacios naturales de Castilla y León, mediante la integración en tiempo real de datos sobre aparcamientos y la conexión con eventos culturales y turísticos cercanos.
Categoría Productos y Servicios: premiaba estudios, servicios, sitios web o aplicaciones para dispositivos móviles, los cuales deben estar accesibles para toda la ciudadanía vía web mediante una URL. En esta categoría se repartieron un primer, segundo y tercer premio de 2.500€, 1.500€ y 500€, respectivamente, además de un premio específico de 1.500€ para estudiantes.
Primer premio: AquaCyL de Pablo Varela Vázquez. Es una aplicación que ofrece información sobre las zonas de baño en la comunidad autónoma.
Segundo premio: ConquistaCyL presentado por Markel Juaristi Mendarozketa y Maite del Corte Sanz. Es un juego interactivo pensado para hacer turismo en Castilla y León y aprender a través de un proceso gamificado.
Tercer premio: Todo el deporte de Castilla y León presentado por Laura Folgado Galache. Es una app que presenta toda la información de interés asociada a un deporte según la provincia.
Premio estudiantes: Otto Wunderlich en Segovia por Jorge Martín Arévalo. Es un repositorio fotográfico ordenado según tipo de monumentos y localización de las fotografías de Otto Wunderlich.
Categoría Recurso Didáctico: consistía en la creación de recursos didácticos abiertos nuevos e innovadores, que sirvieran de apoyo a la enseñanza en el aula. Estos recursos debían ser publicados con licencias Creative Commons. En esta categoría se otorgaba un único primer premio de 1.500€.
Primer premio: StartUp CyL: Creación de empresas a través de la Inteligencia Artificial y Datos Abiertos presentado por José María Pérez Ramos. Es un chatbot que utiliza la API de ChatGPT para asistir en la creación de una empresa utilizando datos abiertos.
Categoría Periodismo de Datos: premiaba piezas periodísticas publicadas o actualizadas (de forma relevante), tanto en soporte escrito como audiovisual, y ofrecía un premio de 1.500€.
Primer premio: Codorniz, perdiz y paloma torcaz son las especies más cazadas en Burgos, presentado por Sara Sendino Cantera, que analiza datos sobre la caza en Burgos.
Premiados de la 5ª edición del Concurso de Datos Abiertos de Open Data Euskadi
Como ya venía sucediendo en ediciones anteriores, el portal de datos abiertos de Euskadi abrió dos modalidades de premios: un concurso de ideas y otro de aplicaciones, cada uno de los cuales estaba dividido en varias categorías. En esta ocasión, se presentaron 41 candidaturas en el concurso de ideas y 30 para el de aplicaciones
Concurso de ideas: en esta modalidad se han repartido dos premios por categoría, el primero de 3.000€ y el segundo de 1.500€.
Categoría Sanitaria y Social
Primer premio: Desarrollo de un Modelo de Predicción de Volumen de Pacientes que acudirán al Servicio de urgencias de Osakidetza de Miren Bacete Martínez. Propone el desarrollo de un modelo predictivo usando series temporales capaz de anticipar tanto el volumen de personas que acudirán a urgencias, como el nivel de gravedad de los casos.
Segundo premio: Euskoeduca de Sandra García Arias. Es una propuesta de solución digital diseñada para brindar orientación académica y profesional personalizada a estudiantes, padres y tutores.
Categoría Medio ambiente y Sostenibilidad
Primer premio: Baratzapp de Leire Zubizarreta Barrenetxea. La idea consiste en el desarrollo de un software que facilita y asiste en la planificación de un huerto mediante algoritmos que buscan potenciar el conocimiento relacionado con la huerta de autoconsumo, a la vez que integra, entre otras, la información climatológica, medioambiental y parcelaria de una manera personalizada para el usuario.
Segundo premio: Euskal Advice de Javier Carpintero Ordoñez. El objetivo de esta propuesta es definir un recomendador turístico basado en inteligencia artificial.
Categoría General
Primer premio: Lanbila de Hodei Gonçalves Barkaiztegi. Es una propuesta de app que utiliza IA generativa y datos abiertos para emparejar curriculum vitae con ofertas de empleo de forma semántica. Proporciona recomendaciones personalizadas, alertas proactivas de empleo y formación, y permite decisiones informadas a través de indicadores laborales y territoriales.
Segundo premio: Desarrollo de un LLM para la consulta interactiva de Datos Abiertos del Gobierno Vasco de Ibai Alberdi Martín. La propuesta consiste en el desarrollo de un Modelo de Lenguaje a Gran Escala (LLM) similar a ChatGPT, entrenado específicamente con datos abiertos, enfocado en proporcionar una interfaz conversacional y gráfica que permita a los usuarios obtener respuestas precisas y visualizaciones dinámicas.
Concurso de aplicaciones: esta modalidad ha seleccionado un proyecto en la categoría de servicios web, premiado con 8.000€, y dos más en la Categoría General que han recibido un primer premio de 8.000€ y 5.000€ como segundo premio.
Categoría Servicios web
Primer premio: Bizidata: Plataforma de visualización del uso de bicicletas en Vitoria-Gasteiz de Igor Díaz de Guereñu de los Ríos. Es una plataforma que visualiza, analiza y permite descargar datos del uso de bicicletas en Vitoria-Gasteiz, y explorar cómo factores externos, como la climatología y el tráfico, influyen en el uso de la bicicleta.
Categoría General
Primer premio: Garbiñe AI de Beatriz Arenal Redondo. Es un asistente inteligente que combina la inteligencia artificial (IA) con datos abiertos de Open Data Euskadi para promover la economía circular y mejorar los ratios de reciclaje en Euskadi.
Segundo premio: Vitoria-Gasteiz Businessmap de Zaira Gil Ozaeta. Es una herramienta de visualización interactiva basada en datos abiertos, diseñada para mejorar las decisiones estratégicas en el ámbito del emprendimiento y la actividad económica en Vitoria-Gasteiz.
Todas estas soluciones premiadas reutilizan conjuntos de datos abiertos del portal autonómico de Castilla y León o Euskadi, según el caso. Te animamos a que eches un vistazo a las propuestas que pueden inspirarte de cara a participar en la próxima edición de estos concursos. ¡Síguenos en redes sociales para no perderte las convocatorias de este año!
 14/01/2025

Outros recursos
Análisis de redes sobre viajes en BICIMAD
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar de manera sencilla y efectiva la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas, como los gráficos de líneas, de barras o de sectores, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos de visualizaciones de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis que resulten pertinentes para, finalmente, posibilitar la creación de visualizaciones interactivas que nos permitan obtener unas conclusiones finales a modo de resumen de dicha información. En cada uno de estos ejercicios prácticos, se utilizan sencillos desarrollos de código convenientemente documentados, así como herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio Laboratorio de datos de GitHub.
A continuación, y como complemento a la explicación que encontrarás seguidamente, puedes acceder al código que utilizaremos en el ejercicio y que iremos explicando y desarrollando en los siguientes apartados de este post.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
2. Objetivo
El objetivo principal de este ejercicio es mostrar cómo realizar un análisis de redes o de grafos partiendo de datos abiertos sobre viajes en bicicleta de alquiler en la ciudad de Madrid. Para ello, realizaremos un preprocesamiento de los datos con la finalidad de obtener las tablas que utilizaremos a continuación en la herramienta generadora de la visualización, con la que crearemos las visualizaciones del grafo.
Los análisis de redes son métodos y herramientas para el estudio y la interpretación de las relaciones y conexiones entre entidades o nodos interconectados de una red, pudiendo ser estas entidades personas, sitios, productos, u organizaciones, entre otros. Los análisis de redes buscan descubrir patrones, identificar comunidades, analizar la influencia y determinar la importancia de los nodos dentro de la red. Esto se logra mediante el uso de algoritmos y técnicas específicas para extraer información significativa de los datos de red.
Una vez analizados los datos mediante esta visualización, podremos contestar a preguntas como las que se plantean a continuación:
¿Cuál es la estación de la red con mayor tráfico de entrada y de salida?
¿Cuáles son las rutas entre estaciones más frecuentes?
¿Cuál es el número medio de conexiones entre estaciones para cada una de ellas?
¿Cuáles son las estaciones más interconectadas dentro de la red?
Volver al inicio
3. Recursos
3.1. Conjuntos de datos
Los conjuntos de datos abiertos utilizados contienen información sobre los viajes en bicicleta de préstamo realizados en la ciudad de Madrid. La información que aportan se trata de la estación de origen y de destino, el tiempo del trayecto, la hora del trayecto, el identificador de la bicicleta, …
Estos conjuntos de datos abiertos son publicados por el Ayuntamiento de Madrid, mediante ficheros que recogen los registros de forma mensual.
Series mensuales datos estáticos BICIMAD
Estos conjuntos de datos también se encuentran disponibles para su descarga en el siguiente repositorio de GitHub.
Volver al inicio
3.2. Herramientas
Para la realización de las tareas de preprocesado de los datos se ha utilizado el lenguaje de programación Python escrito sobre un Notebook de Jupyter alojado en el servicio en la nube de Google Colab.
"Google Colab" o, también llamado Google Colaboratory, es un servicio en la nube de Google Research que permite programar, ejecutar y compartir código escrito en Python o R sobre un Jupyter Notebook desde tu navegador, por lo que no requiere configuración. Este servicio es gratuito.
Para la creación de la visualización interactiva se ha usado la herramienta Gephi
"Gephi" es una herramienta de visualización y análisis de redes. Permite representar y explorar relaciones entre elementos, como nodos y enlaces, con el fin de entender la estructura y patrones de la red. El programa precisa descarga y es gratuito.
Si quieres conocer más sobre herramientas que puedan ayudarte en el tratamiento y la visualización de datos, puedes recurrir al informe "Herramientas de procesado y visualización de datos".
Volver al inicio
4. Tratamiento o preparación de datos
Los procesos que te describimos a continuación los encontrarás comentados en el Notebook que también podrás ejecutar desde Google Colab.
Debido al alto volumen de viajes registrados en los conjuntos de datos, definimos los siguientes puntos de partida a la hora de analizarlos:
Analizaremos la hora del día con mayor tráfico de viajes
Analizaremos las estaciones con un mayor volumen de viajes
Antes de lanzarnos a analizar y construir una visualización efectiva, debemos realizar un tratamiento previo de los datos, prestando especial atención a su obtención y a la validación de su contenido, asegurándonos que se encuentran en el formato adecuado y consistente para su procesamiento y que no contienen errores.
Como primer paso del proceso, es necesario realizar un análisis exploratorio de los datos (EDA), con el fin de interpretar adecuadamente los datos de partida, detectar anomalías, datos ausentes o errores que pudieran afectar a la calidad de los procesos posteriores y resultados. Si quieres conocer más sobre este proceso puedes recurrir a la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
El siguiente paso es generar la tabla de datos preprocesada que usaremos para alimentar la herramienta de análisis de redes (Gephi) que de forma visual nos ayudará a comprender la información. Para ello modificaremos, filtraremos y uniremos los datos según nuestras necesidades.
Los pasos que se siguen en este preprocesamiento de los datos, explicados en este Notebook de Google Colab, son los siguientes:
Instalación de librerías y carga de los conjuntos de datos
Análisis exploratorio de los datos (EDA)
Generación de tablas preprocesadas
Podrás reproducir este análisis con el código fuente que está disponible en nuestra cuenta de GitHub. La forma de proporcionar el código es a través de un documento realizado sobre un Jupyter Notebook que, una vez cargado en el entorno de desarrollo, podrás ejecutar o modificar de manera sencilla.
Debido al carácter divulgativo de este post y para favorecer el entendimiento de los lectores no especializados, el código no pretende ser el más eficiente sino facilitar su comprensión, por lo que posiblemente se te ocurrirán muchas formas de optimizar el código propuesto para lograr fines similares. ¡Te animamos a que lo hagas!
Volver al inicio
5. Análisis de la red
5.1. Definición de la red
La red analizada se encuentra formada por los viajes entre distintas estaciones de bicicletas en la ciudad de Madrid, teniendo como principal información de cada uno de los viajes registrados la estación de origen (denominada como “source”) y la estación de destino (denominada como “target”).
La red está formada por 253 nodos (estaciones) y 3012 aristas (interacciones entre las estaciones). Se trata de un grafo dirigido, debido a que las interacciones son bidireccionales y ponderado, debido a que cada arista entre los nodos tiene asociado un valor numérico denominado "peso" que en este caso corresponde al número de viajes realizados entre ambas estaciones.
5.2. Carga de la tabla preprocesada en Gephi
Mediante la opción “importar hoja de cálculo” de la pestaña archivo, importamos en formato CSV la tabla de datos previamente preprocesada. Gephi detectará que tipo de datos se están cargando, por lo que utilizaremos los parámetros predefinidos por defecto.
Figura 1. Carga de datos en Gephi
5.3. Opciones de visualización de la red
5.3.1 Ventana de distribución
En primer lugar, aplicamos en la ventana de distribución, el algoritmo Force Atlas 2. Este algoritmo utiliza la técnica de repulsión de nodos en función del grado de conexión de tal forma que los nodos escasamente conectados se separan respecto a los que tiene una mayor fuerza de atracción entre sí.
Para evitar que los componentes conexos queden fuera de la vista principal, fijamos el valor del parámetro "Gravedad en Puesta a punto" a un valor de 10 y para evitar que los nodos queden amontonados, marcamos la opción “Disuadir Hubs” y “Evitar el solapamiento”.
Figura 2. Ventana distribución - algoritmo Force Atlas 2
Dentro de la ventana de distribución, también aplicamos el algoritmo de Expansión con la finalidad de que los nodos no se encuentren tan juntos entre sí mismos.
Figura 3. Ventana distribución - algoritmo de Expansión
5.3.2 Ventana de apariencia
A continuación, en la ventana de apariencia, modificamos los nodos y sus etiquetas para que su tamaño no sea igualitario, sino que dependa del valor del grado de cada nodo (nodos con un mayor grado, mayor tamaño visual). También modificaremos el color de los nodos para que los de mayor tamaño sean de un color más llamativo que los de menor tamaño. En la misma ventana de apariencia modificamos las aristas, en este caso hemos optado por un color unitario para todas ellas, ya que por defecto el tamaño va acorde al peso de cada una de ellas.
Un mayor grado en uno de los nodos implica un mayor número de estaciones conectadas con dicho nodo, mientras que un mayor peso de las aristas implica un mayor número de viajes para cada conexión.
Figura 4. Ventana apariencia
5.3.3 Ventana de grafo
Por último, en la zona inferior de la interfaz de la ventana de grafo, tenemos diversas opciones como activar/desactivar el botón para mostrar las etiquetas de los distintos nodos, adecuar el tamaño de las aristas con la finalizad de hacer más limpia la visualización, modificar el tipo de letra de las etiquetas, …
Figura 5. Opciones ventana de grafo
A continuación, podemos ver la visualización del grafo que representa la red una vez aplicadas las opciones de visualización mencionadas en los puntos anteriores.
Figura 6. Visualización del grafo
Activando la opción de visualizar etiquetas y colocando el cursor sobre uno de los nodos, se mostrarán los enlaces que corresponden al nodo y el resto de los nodos que están vinculados al elegido mediante dichos enlaces.
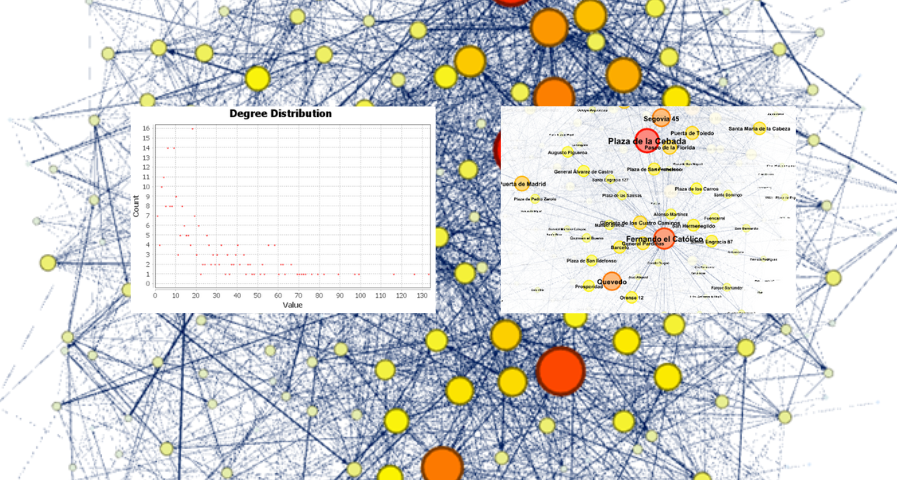
A continuación, podemos visualizar los nodos y enlaces relativos a la estación de bicicletas “Fernando el Católico". En la visualización se distinguen con facilidad los nodos que poseen un mayor número de conexiones, ya que aparecen con un mayor tamaño y colores más llamativos, como por ejemplo "Plaza de la Cebada" o "Quevedo".
Figura 7. Visualización grafo para la estación "Fernando el Católico"
5.4 Principales medidas de red
Junto a la visualización del grafo, las siguientes medidas nos aportan la principal información de la red analizada. Estas medias, que son las métricas habituales cuando se realiza analítica de redes, podremos calcularlas en la ventana de estadísticas.
Figura 8. Ventana estadísticas
Nodos (N): son los distintos elementos individuales que componen una red, representando entidades diversas. En este caso las distintas estaciones de bicicletas. Su valor en la red es de 243
Enlaces (L): son las conexiones que existen entre los nodos de una red. Los enlaces representan las relaciones o interacciones entre los elementos individuales (nodos) que componen la red. Su valor en la red es de 3014
Número máximo de enlaces (Lmax): es el máximo posible de enlaces en la red. Se calcula mediante la siguiente fórmula Lmax= N(N-1)/2. Su valor en la red es de 31878
Grado medio (k): es una medida estadística para cuantificar la conectividad promedio de los nodos de la red. Se calcula promediando los grados de todos los nodos de la red. Su valor en la red es de 23,8
Densidad de la red (d): indica la proporción de conexiones existentes entre los nodos de la red con respecto al total de conexiones posibles. Su valor en la red es de 0,047
Diámetro (dmax ): es la distancia de grafo más larga entre dos nodos cualquiera de la res, es decir, cómo de lejos están los 2 nodos más alejados. Su valor en la red es de 7
Distancia media (d): es la distancia de grafo media promedio entre los nodos de la red. Su valor en la red es de 2,68
Coeficiente medio de clustering (C): Índica cómo los nodos están incrustados entre sus nodos vecinos. El valor medio da una indicación general de la agrupación en la red. Su valor en la red es de 0,208
Componente conexo: grupo de nodos que están directa o indirectamente conectados entre sí, pero no están conectados con los nodos fuera de ese grupo. Su valor en la red es de 24
5.5 Interpretación de los resultados
La probabilidad de grados sigue de forma aproximada una distribución de larga cola, donde podemos observar que existen unas pocas estaciones que interactúan con un gran número de ellas mientras que la mayoría interactúa con un número bajo de estaciones.
El grado medio es de 23,8 lo que indica que cada estación interacciona de media con cerca de otras 24 estaciones (entrada y salida).
En el siguiente gráfico podemos observar que, aunque tengamos nodos con grados considerados como altos (80, 90, 100, …), se observa que el 25% de los nodos tienen grados iguales o inferiores a 8, mientras que el 75% de los nodos tienen grados inferiores o iguales a 32.
Figura 9. Gráfico de dIstribución de grados
La gráfica anterior se puede desglosar en las dos siguientes correspondientes al grado medio de entrada y de salida (ya que la red es direccional). Vemos que ambas tienen distribuciones de larga cola similares, siendo su grado medio el mismo de 11,9.
Su principal diferencia es que la gráfica correspondiente al grado medio de entrada tiene una mediana de 7 mientras que la de salida es de 9, lo que significa que existe una mayoría de nodos con grados más bajos en los de entrada que los de salida.
Figura 10. Gráficos distribución de grados de entrada y salida
El valor del grado medio con pesos es de 346,07 lo cual nos indica la media de viajes totales de entrada y salida de cada estación.
Figura 11. Gráfico distribución de grados con pesos
La densidad de red de 0,047 es considerada una densidad baja indicando que la red es dispersa, es decir, contiene pocas interacciones entre distintas estaciones en relación con las posibles. Esto se considera lógico debido a que las conexiones entre estaciones estarán limitadas a ciertas zonas debido a la dificultad de llegar a estaciones que se encuentra a largas distancias.
El coeficiente medio de clustering es de 0,208 significando que la interacción de dos estaciones con una tercera no implica necesariamente la interacción entre sí, es decir, no implica necesariamente transitividad, por lo que la probabilidad de interconexión de esas dos estaciones mediante la intervención de una tercera es baja.
Por último, la red presenta 24 componentes conexos, siendo 2 de ellos componentes conexos débiles y 22 componentes conexos fuertes.
5.6 Análisis de centralidad
Un análisis de centralidad se refiere a la evaluación de la importancia de los nodos en una red utilizando diferentes medidas. La centralidad es un concepto fundamental en el análisis de redes y se utiliza para identificar nodos clave o influyentes dentro de una red. Para realizar esta tarea se parte de las métricas calculadas en la ventana de estadísticas.
La medida de centralidad de grado indica que cuanto más alto es el grado de un nodo, más importante es. Las cinco estaciones con valores más elevados son: 1º Plaza de la Cebada, 2º Plaza de Lavapiés, 3º Fernando el Católico, 4º Quevedo, 5º Segovia 45.
Figura 12. Visualización grafo centralidad de grado
La media de centralidad de cercanía indica que cuanto más alto sea el valor de cercanía de un nodo, más central es, ya que puede alcanzar cualquier otro nodo de la red con el menor esfuerzo posible. Las cinco estaciones que valores más elevados poseen son: 1º Fernando el Católico 2º General Pardiñas, 3º Plaza de la Cebada, 4º Plaza de Lavapiés, 5º Puerta de Madrid.
Figura 13. Distribución medida centralidad de cercanía
Figura 14. Visualización grafo centralidad de cercanía
La medida de centralidad de intermediación indica que cuanto mayor sea la medida de intermediación de un nodo, más importante es dado que está presente en más rutas de interacción entre nodos que el resto de los nodos de la red. Las cinco estaciones que valores más elevados poseen son: 1º Fernando el Católico, 2º Plaza de Lavapiés, 3º Plaza de la Cebada, 4º Puerta de Madrid, 5º Quevedo.
Figura 15. Gráfico distribución medida centralidad de intermediación
FIgura 16. Visualización grafo centralidad de intermediación
Con la herramienta Gephi se pueden calcular gran cantidad de métricas y parámetros que no se reflejan en este estudio ,como por ejemplo, la medida de vector propio o distribucción de centralidad "eigenvector".
5.7 Filtros
Mediante la ventana de filtrado, podemos seleccionar ciertos parámetros que simplifiquen las visualizaciones con la finalidad de mostrar información relevante del análisis de redes de una forma más clara visualmente.
Figura 17. Ventana de filtrado
A continuación, mostraremos varios filtrados realizados:
Filtrado de rango (grado), en el que se muestran los nodos con un rango superior a 50, suponiendo un 13,44% (34 nodos) y un 15,41% (464 aristas)
Figura 18. Visualización grafo filtrado de rango (grado)
Filtrado de aristas (peso de la arista), en el que se muestran las aristas con un peso superior a 100, suponiendo un 0,7% (20 aristas)
Figura 19. VIsualización grafo filtrado de arista (peso)
Dentro de la ventana de filtros, existen muchas otras opciones de filtrado sobre atributos, rangos, tamaños de particiones, las aristas, … con los que puedes probar a realizar nuevas visualizaciones para extraer información del grafo. Si quieres conocer más sobre el uso de Gephi, puedes consultar los siguientes cursos y formaciones sobre la herramienta.
6. Conclusiones del ejercicio
Una vez realizado el ejercicio, podemos apreciar las siguientes conclusiones:
Las tres estaciones más interconectadas con otras estaciones son Plaza de la Cebada (133), Plaza de Lavapiés (126) y Fernando el Católico (114).
La estación que tiene un mayor número de conexiones de entrada es la Plaza de la Cebada (78), mientras que la que tiene un mayor número de conexiones de salida es la Plaza de Lavapiés con el mismo número que Fernando el Católico (57)
Las tres estaciones con un mayor número de viajes totales son Plaza de la Cebada (4524), Plaza de Lavapiés (4237) y Fernando el Católico (3526).
Existen 20 rutas con más de 100 viajes. Siendo las 3 rutas con un mayor número de ellos: Puerta de Toledo – Plaza Conde Suchil (141), Quintana Fuente del Berro – Quintana (137), Camino Vinateros – Miguel Moya (134).
Teniendo en cuenta el número de conexiones entre estaciones y de viajes, las estaciones de mayor importancia dentro de la red son: Plaza la Cebada, Plaza de Lavapiés y Fernando el Católico.
Esperemos que esta visualización paso a paso te haya resultado útil para el aprendizaje de algunas técnicas muy habituales en el tratamiento y representación de datos abiertos. Volveremos para mostraros nuevas reutilizaciones. ¡Hasta pronto!
11/09/2023