28 exercicios de datos atopados

Ciencia e tecnoloxía
Introducción
El Instituto Nacional de Estadística (INE) pone a disposición de la ciudadanía datos geográficos de interés social distribuidos por secciones censales. El uso de estas unidades territoriales es, sin embargo, poco frecuente fuera del ámbito estadístico. En cambio, es habitual asociar datos y variables geográficas a códigos postales, ya que la ciudadanía está más familiarizada con su localización y extensión en sus respectivos municipios o provincias. Por esta razón, varios organismos públicos, así como iniciativas privadas, recopilan y publican datos asociados a códigos postales atendiendo a esta familiaridad.
En este ejercicio se detalla un método para establecer una correspondencia y extrapolar los datos asociados de las secciones censales a sus códigos postales correspondientes. Esta relación no es directa, ya que los límites de ambas unidades territoriales no coinciden exactamente, esto es, dentro del área de un código postal encontramos varias secciones censales completas, e igualmente, un mismo código postal puede extenderse por más de un código postal. La falta de plena coincidencia entre ambos conceptos requiere de métodos para poder extrapolar la información contenida de uno a otro con rigor y precisión.
Para este ejercicio utilizaremos los datos del INE de renta neta media por persona, originalmente disponible por sección censal, para estimar su valor por código postal. Posteriormente, estos resultados se relacionarán con la distribución de instalaciones deportivas en la provincia de Sevilla, distinguiendo entre Sevilla capital y el resto de la provincia.
A partir de estos datos se realizará un análisis exploratorio dirigido a identificar posibles patrones en relación con:
Las diferencias en la distribución de instalaciones por renta entre Sevilla capital y el resto de la provincia de Sevilla.
Las diferencias en la distribución de pistas de baloncesto y gimnasios por renta.
Los resultados servirán para identificar diferencias territoriales y formular hipótesis que puedan contribuir a orientar análisis posteriores sobre la cobertura y distribución de estas instalaciones, sin establecer relaciones causales entre el nivel de renta y su localización.
Se utilizará para ellos datos abiertos geográficos y estadísticos de diferentes organismos públicos.
Definiciones
En este ejercicio manejaremos los conceptos de sección censal y código postal, que se definen a continuación para facilitar la comprensión del análisis.
Sección censal: es una unidad territorial que se utiliza para la recopilación de información estadística y la organización de procesos electorales. Generalmente, cada sección censal tiene un tamaño de entre 500 y 2000 habitantes para facilitar la operatividad de encuestadores y votantes. Sus límites están definidos por elementos fácilmente identificables, como ríos o calles, lo que permite una clara identificación geográfica.
Figura 1: Secciones censales correspondientes a la provincia de Sevilla y de Sevilla capital. Fuente: elaboración propia a partir de datos del Instituto Nacional de Estadística (INE)
Código postal: es un código que en España está formado por cinco cifras que se asigna a una zona o región geográfica específica para agilizar la clasificación, el acceso y la entrega de envíos postales. Los dos primeros dígitos indican la provincia en orden alfabético. Los tres últimos dígitos identifican el municipio, zona postal o ruta de reparto.
Figura 2: Códigos postales correspondientes a la provincial de Sevilla. Fuente: elaboración propia a partir de datos del Instituto Geográfico Nacional (IGN).
A partir de las definiciones anteriores, la Figura 3 muestra la superposición de las secciones censales y los códigos postales de Sevilla capital y su entorno, así como las zonas de intersección que se utilizarán posteriormente en el análisis.
Figura 3: Superposición de las secciones censales y los códigos postales de Sevilla capital y su entorno. Fuente: elaboración propia a partir de datos del INE e IGN.
Datos para el ejercicio
Una vez definidas las unidades geográficas en las que se enmarca el estudio, recurrimos a datos abiertos de organismos públicos para realizar el ejercicio. En concreto utilizaremos los siguientes conjuntos de datos:
Geometría de las secciones censales del Instituto Nacional de estadística para el año 2023.
Geometría de los códigos postales en la provincia de Sevilla.
Relación de tramos de vía de secciones censales por código postal, del Instituto Nacional de Estadística.
Renta neta media por persona por sección censal del Instituto Nacional de Estadística.
Censo de instalaciones deportivas de Andalucía, que incluye información sobre su localización -localización por calle, municipio, provincia y código postal – y tipo de instalación deportiva.
Proceso de desarrollo
En esta sección detallaremos los pasos a seguir de cara a asociar la renta neta media por persona de cada sección censal con la localización de las instalaciones deportivas de Sevilla capital y del resto de la provincia. Una vez que obtengamos la distribución de las instalaciones por renta, se profundiza en el análisis para estudiar las diferencias entre ambos territorios, así como entre los tipos de instalaciones dependiendo del deporte practicado.
El análisis se ha desarrollado en Python. Además, se ha utilizado el software de visualización cartográfico Kepler.gl, de uso fácil e intuitivo, y ya descrito en el ejercicio de visualización de datos sobre los terremotos en la isla de la Palma.
El código en Python así como los conjuntos de datos ya descargados para su procesamiento se encuentran en el repositorio en Github:
Accede al repositorio del laboratorio de datos en GitHub
El notebook de Google Colab con todos los comandos necesarios para ejecutar el análisis en Python se puede encontrar en:
Accede al notebook de Google Colab
1. Peso de las secciones censales en cada código postal
El primer paso dentro de este ejercicio es calcular el peso de cada sección censal en cada código postal. Para ello realizamos la lectura del fichero de entrada que contiene los tramos de vía de cada sección censal. En la lectura identificamos primeramente los códigos de: provincia, municipio, distrito y sección
Con esos códigos creamos el código de sección censal mediante la concatenación. Un primer ejemplo lo encontramos en la primera entrada del fichero "Relación de tramos de vía", en la que observamos los siguientes valores para los campos anteriormente descritos: provincia: 41; municipio: 001; distrito: 01; sección: 001
La sección censal resultante para ese tramo de vía es el 4100101001, obtenida de la concatenación de esos campos de acuerdo con el orden descrito.
Una vez tenemos definida la sección censal, calculamos cuántas veces aparece la combinación única sección censal y código postal. A continuación, calculamos el número total de tramos de vía que tiene cada sección censal y, por último, la proporción de esos tramos que corresponden a cada código postal. De esta forma, obtenemos la llamada matriz de pesos, donde cada combinación de sección censal y código postal tiene asociada una fracción o peso. La mayoría de las secciones censales tienen un peso de 1 o fracción unidad, lo que quiere decir que todos sus tramos de vía están asociados a un único código postal. Otras secciones censales están repartidas en dos o más códigos postales.
En total, de las 1.595 secciones censales de la provincia de Sevilla, obtenemos 1.207 secciones censales cuyos tramos están asociados íntegramente a un código postal, mientras que 388 presentan tramos asociados a más de un código postal.
En la Figura 4 se muestra la distribución geográfica de las secciones censales según el peso de sus tramos de vía en los códigos postales, tanto en la provincia de Sevilla como en Sevilla capital. Se observa que las secciones cuyos tramos están asociados a más de un código postal se localizan tanto en ámbitos urbanos como rurales.
Figura 4: Secciones censales de la provincia de Sevilla y de Sevilla capital según el peso de sus tramos de vía en los códigos postales. Fuente: elaboración propia.
Focalizando sobre la ciudad de Sevilla, se comprueba cómo, de nuevo, la disparidad de pesos se reparte por toda la geografía de la ciudad. Los resultados ponen de manifiesto la necesidad de aplicar estos pesos y para estimar los valores correspondientes a cada código postal a partir de los datos disponibles por sección censal.
2. Asociación de renta a cada código postal
El siguiente paso en este ejercicio es asociar a los códigos postales los valores de renta neta media por persona.
A continuación podemos observar cómo están estructurados los datos del INE respecto a las rentas netas medias por persona y la sección censal asignada. En concreto, en la Tabla 1 se muestran dos secciones censales, pertenecientes a distritos censales distintos del municipio de Aguadulce, con diferentes valores de renta. Ambas secciones están asociadas a un único código postal, y por lo tanto, la renta estimada para ese código postal resultará de la media ponderada de los valores de renta de las secciones censales asociadas, utilizando los pesos calculados en el apartado anterior.
Tabla 1: Datos de muestra de renta neta media por persona y sección censal para el municipio de Aguadulce. Fuente: INE.
El resultado de ponderar las contribuciones de las distintas secciones censales para estimar la renta neta media por persona de un código postal se puede ver en la Tabla 2, siguiendo el ejemplo anterior del municipio de Aguadulce. El valor obtenido se sitúa entre los valores de renta mostrados en la Tabla 1.
Variable
Valor
Municipio
41001
Código postal
41550
Renta neta media por persona
10.539
Tabla 2: Estimación de la renta neta media por persona para el código postal 41550 correspondiente al Municpio con código censal 41001. Fuente: elaboración propia.
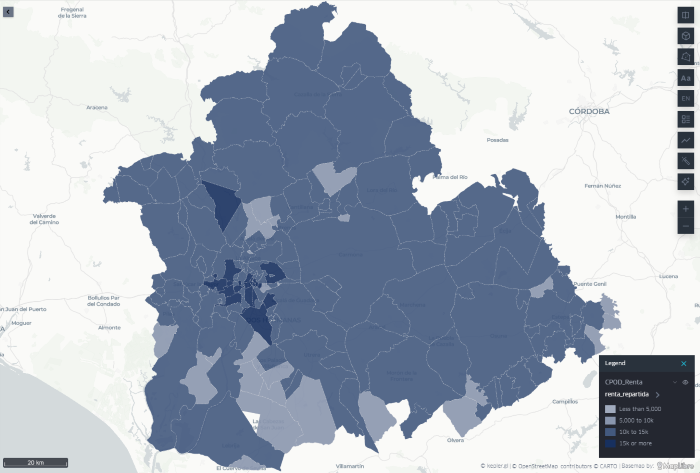
La distribución geográfica de la renta media por persona estimada para cada código postal de la provincia de Sevilla se puede observar en la Figura 5. En ella se observa una tendencia según la cual las rentas más elevadas se concentran principalmente en los núcleos urbanos, en particular en Sevilla capital, mientras que los valores más bajos aparecen con mayor frecuencia en zonas periféricas de la provincia
Figura 5: Distribución de la renta neta media por persona estimada para cada código postal de la provincia de Sevilla y de Sevilla capital. Fuente: elaboración propia.
3. Asociación de instalaciones deportivas al nivel de renta
El siguiente paso es establecer la asociación de la localización de las instalaciones deportivas con el nivel de renta estimado para cada código postal.
En la Tabla 3 tenemos la estructura del conjunto de datos de instalaciones deportivas en Andalucía. En ella se detalla la localización de la instalación, el municipio, el nombre de la vía y el código postal. También se incluye el tipo de instalación, determinada por el deporte que se practica.
Variable
Valor
Código IDA
2
Nombre de instalación
PABELLON DEPORTIVO CUBIERTO
Provincia
Sevilla
Municipio
Castilblanco de los Arroyos
Nombre vía
CAMINO DEL TOLEDILLO
Código postal
41230
Espacio deportivo (texto libre)
PISTA POLIDEPORTIVA
Tabla 3: Estructura del conjunto de datos de los centros deportivos en Andalucía. Fuente: Junta de Andalucía.
Gracias a la correspondencia obtenida entre los valores estimados de renta y los códigos postales en el paso anterior, podemos ampliar la información asociada a cada instalación deportiva mediante la incorporación de un nuevo campo: la renta neta media por persona estimada para su código postal. En la Tabla 4 se puede ver el nuevo campo incluido.
Variable
Valor
Código IDA
2
Nombre de instalación
PABELLON DEPORTIVO CUBIERTO
Provincia
Sevilla
Municipio
Castilblanco de los Arroyos
Nombre vía
CAMINO DEL TOLEDILLO
Código postal
41230
Espacio deportivo (texto libre)
PISTA POLIDEPORTIVA
Renta por persona
10.620
Tabla 4: Estructura del conjunto de datos de los centros deportivos en Andalucía complementada con el valor estimado de la renta neta media por persona. Fuente: elaboración propia.
De esta forma, hemos conseguido relacionar la información del nivel de renta neta media por persona estimada para cada código postal con las instalaciones deportivas de Sevilla provincia o capital.
Este resultado nos permite a continuación desarrollar toda una serie de análisis estadísticos para identificar posibles patrones y describir la distribución de las instalaciones deportivas, como se expone en el siguiente apartado.
4. Localización de instalaciones deportivas respecto a la renta media
Tomando la media de la renta por persona tanto en la provincia de Sevilla como en Sevilla capital, es posible identificar cómo se distribuyen las instalaciones deportivas respecto de esa media. De este modo, podemos observar si las instalaciones se sitúan en códigos postales con una renta estimada inferior o superior a la media de cada ámbito territorial.
En este punto hacemos una separación entre la provincia de Sevilla sin capital y Sevilla capital, al tratarse de dos entornos muy diferentes. A nivel provincial encontramos población más dispersa, códigos postales abarcando una mayor extensión y una concentración de servicios en los núcleos de población.
Por el contrario, en Sevilla capital encontramos, en general, áreas de códigos postales de menor extensión y una mayor concentración de instalaciones deportivas fuera del centro de la ciudad, comúnmente asociadas a deportes como el fútbol, pistas de pádel o piscinas.
En la Figura 6 se representa el número de instalaciones deportivas por renta media por persona estimada para su código postal en tres áreas: la provincia de Sevilla en su totalidad, la provincia sin la capital y la propia capital. En estas tres regiones observamos:
En el conjunto de la provincia, el máximo de concentración de instalaciones se localiza en códigos postales con valores de renta por debajo de la media provincial, aunque la distribución presenta igualmente una alta densidad en intervalos muy definidos situados por encima de ella.
Respecto a la provincia de Sevilla sin la capital, la mayor concentración de instalaciones también se sitúa en códigos postales con valores de renta por debajo de la media de este ámbito. Asimismo, se observa un número destacado de instalaciones en códigos postales para rentas superiores a la media pero un orden de magnitud por debajo de las observadas para rentas inferiores a la media.
En el caso de Sevilla capital, la distribución presenta una mayor dispersión entre los distintos intervalos de renta. Las instalaciones se distribuyen a lo largo de un intervalo más amplio de valores y no se aprecia una concentración tan acusada en un único intervalo de renta como en el resto de la provincia.
Figura 6: Número de instalaciones deportivas por renta por persona estimada para su código postal en la provincia de Sevilla, la provincia sin capital y Sevilla capital. Las líneas verticales indican la renta media estimada en cada ámbito territorial. Fuente: elaboración propia
Atendiendo a la dispersión en los valores de renta observamos en la Figura 6 cómo, a pesar de compartir casi el mismo espectro de rentas posibles, a nivel provincial la concentración es mucho mayor en torno a un reducido en torno a la renta media, mientras que en el caso de Sevilla capital las instalaciones deportivas cubren un intervalo más amplio que en el caso de la provincia, sobre todo hacia rentas más altas. Esto nos lleva a la reflexión del efecto homogeneizador de las ciudades, donde un espacio más reducido convive un espectro de rentas más amplio que en la provincia.
5. Distribución de instalaciones deportivas por tipo de deporte
El último análisis realizado aborda la variabilidad asociada al tipo de deporte practicado y, por lo tanto, al tipo de instalación deportiva. Deportes diferentes tienen diferentes necesidades de espacio, y pueden estar asociados a perfiles de usuarios diferentes. En este análisis preliminar distinguimos entre dos tipos de instalaciones, pistas de baloncesto y gimnasios, para realizar el mismo cálculo que en la sección anterior.
Filtrando los datos mediante las palabras clave “baloncesto” y “gimnasio” en el campo de texto libre correspondiente al espacio deportivo, podemos generar un histograma para el caso de Sevilla capital y analizar la distribución de instalaciones deportivas respecto de la renta media por persona para cada código postal. En la Figura 7 y Figura 8 se muestran los resultados por deporte, donde encontramos:
En el caso de pistas de baloncesto, la distribución del histograma en Sevilla capital se desplaza ligeramente hacia valores de rentas inferiores a la media. En total, un 67% de las pistas de baloncesto están en códigos postales con renta media por persona estimada por debajo de la media de Sevilla capital.
La distribución de gimnasios en Sevilla capital, por el contrario, presenta un reparto más equilibrado respecto al nivel de renta. El 55% de los gimnasios se encuentra en códigos postales cuya renta media por persona estimada se sitúa por debajo de la renta media de la ciudad.
a {
text-decoration: none;
color: #464feb;
}
tr th, tr td {
border: 1px solid #e6e6e6;
}
tr th {
background-color: #f5f5f5;
}
Figura 7: Distribución de pistas de baloncesto según la renta neta media por persona estimada para su código postal en Sevilla capital. Fuente: elaboración propia.
Figura 8: Distribución de gimnasios según la renta neta media por persona estimada para su código postal en Sevilla capital. Fuente: elaboración propia.
Estos resultados ponen de manifiesto diferencias en la distribución territorial de ambas tipologías de instalaciones respecto a la renta estimada de los códigos postales donde se localizan. No obstante, serían necesarias variables adicionales para analizar las causas que pueden explicar estas diferencias.
Lecciones aprendidas
A lo largo de este ejercicio de análisis hemos aprendido a manejar datos del INE por secciones censales, a estimar por código postal valores originalmente disponibles por sección censal, a aplicar este procedimiento a un caso real vinculado a un conjunto de datos del Catálogo y a realizar un breve análisis estadístico exploratorio que permite identificar patrones y formular hipótesis para análisis posteriores. En concreto, hemos aprendido a:
Diferenciar entre sección censal y código postal, desde su definición más básica hasta ejemplos reales de ambas unidades en una provincia concreta.
Lectura de ficheros del INE con información agrupada por secciones censales y detallada por provincias, municipios y distritos, así cómo crear el código de sección censal.
Calcular el peso relativo de cada sección censal en distintos códigos postales, profundizando en su complejidad y teniendo en cuenta las diferencias correspondencias entre ambas unidades territoriales
Aplicar filtros en Python para seleccionar datos por código postal o campos de texto concretos, como los deportes seleccionados, y focalizar así el análisis en casos determinados.
Crear visualizaciones en Python para realizar un análisis estadístico básico, como el histograma.
Utilizar de Kepler.gl para crear mapas de forma fácil e intuitiva que acompañen a los ejercicios de datos georreferenciados.
Conclusiones
Este ejercicio nos ha permitido familiarizarnos con el concepto de sección censal, desde el acceso, lectura y manipulación de los ficheros originales del INE hasta una aplicación real con datos de la Junta de Andalucía.
Igualmente, nos ha permitido comprobar cómo un script sencillo y relativamente corto de Python es suficiente para la lectura y análisis de datos del INE, así como para un análisis estadístico exploratorio de ese y de otros conjuntos de datos relacionados, demostrando el potencial de la programación.
Por último, este ejercicio invita a la formulación de toda una serie de hipótesis sobre la distribución de instalaciones deportivas por el nivel de renta, así como sobre los posibles factores territoriales, sociales o urbanísticos que pueden influir en dicha distribución, que van más allá del foco de este sencillo ejercicio.
Siguientes pasos
A partir de este ejercicio, el análisis podría ampliarse incorporando nuevas variables, como la población de cada código postal, la titularidad y capacidad de las instalaciones o su grado de utilización. Esto permitiría calcular indicadores comparables, como el número de instalaciones por cada 10.000 habitantes, y profundizar en el estudio de su distribución territorial. El mismo procedimiento también podría aplicarse a otros servicios y equipamientos, como centros educativos, sanitarios o culturales.

Ciencia e tecnoloxía
Introducción
El baile celestial de los astros en el sistema solar ofrece cada cierto tiempo espectáculos únicos y singulares, como el fenómeno del eclipse total que se pudo contemplar en la península ibérica este año, y que se podrá ver de nuevo en 2027 y 2028. Durante un eclipse total, la Luna se interpone entre la Tierra y el Sol, ocultando al astro rey y proyectando durante unos minutos una sombra sobre una parte de la superficie terrestre.
El eclipse total del 12 de agosto de 2026 tuvo su comienzo hacia las 20h30 horas (GMT+01:00), cubriendo de penumbra desde Galicia hasta las Islas Baleares a lo largo de la hora y media de duración del eclipse.
El Centro Nacional de Información Geográfica (CNIG) ha puesto a disposición del público unos conjuntos de datos que ofrecen un amplio espectro de información astronómica relativa tanto al eclipse del pasado agosto como a los que se van a producir sobre la península ibérica durante los próximos dos años.
Estos conjuntos de datos incluyen información sobre la visibilidad por el propio relieve del terreno a la hora del eclipse, la duración del eclipse en cada punto de la geografía española, el nivel de oscurecimiento o la elevación del Sol en el punto máximo del eclipse, así como la sombra proyectada por la Luna en su trayecto por delante del Sol.
En este ejercicio accederemos a los conjuntos de datos del CNIG y abriremos los ficheros tipo .TIFF y .GPKG con toda la información relativa al eclipse, y en concreto con todo lo relacionado con las zonas de sombra, tanto en lo referente a la visibilidad por efecto del relieve en la península, como en lo que respecta a la zona de sombra en sí debido al eclipse total.
Una vez hayamos accedido a los datos, delimitaremos nuestro análisis a una zona concreta sobre la visibilidad por relieve, recortaremos los datos originales con el perímetro de un municipio, exportaremos el resultado en formato GeoJSON y, haciendo uso de éste, seremos capaces de crear diferentes tipos de mapas con diversas herramientas útiles e intuitivas tales como KeplerGL, GoogleEarth, Leaflet o D3.js.
Datos para el ejercicio
Los datos disponibles para realizar este ejercicio se encuentran accesibles en el Catálogo de datos abiertos de datos.gob.es y constan de tres ficheros con información relevante para describir y caracterizar el eclipse. En concreto encontramos:
Sombras del terreno: fichero donde se describe la visibilidad por relieve en una malla de puntos que cubre la península ibérica y la parte occidental del norte de África.
Curvas de nivel: fichero que contiene la duración, el oscurecimiento máximo y las curvas de penumbra proyectadas desde la Luna sobre la Tierra.
Efemérides: fichero que alberga las efemérides del eclipse, tales como elevación, azimut, salida y puesta de sol, así como inicio y final del eclipse.
En este ejercicio nos centraremos en los dos primeros , ya que contienen información sobre la sombra proyectada tanto por el relieve como por la Luna sobre la península ibérica.
Adicionalmente, recurriremos igualmente al Catálogo de datos para obtener el perímetro en formato SHP de algún municipio que nos permita analizar en detalle la sombra por relieve. De esta forma completaremos el acceso y lectura de tres formatos de datos georreferenciados diferentes:
TIFF: formato popular para información gráfica de alta resolución que tolera altos grados de compresión sin pérdida de información y que por lo tanto es muy manejable. Las siglas hacen referencia a Tagged Image File Format.
GPKG: acrónimo de GeoPackage. Este formato se utiliza en sistemas de información geográfica para almacenar datos tanto en modo ráster como modo vectorial.
SHP: formato de datos vectorial que contiene localizaciones geométricas, muy utilizado también en sistemas de información geográfica. Contiene exclusivamente puntos, líneas o polígonos y se compone de varios ficheros que contienen índices o atributos.
El formato SHP lo necesitaremos para disponer del perímetro de un municipio y así poder limitar nuestro estudio a una zona en concreta de interés. Dentro del Catálogo de datos tenemos perímetros municipales en el País Vasco en este conjunto de datos. Dentro de este fichero SHP podremos elegir uno de esos municipios ya que vienen caracterizados por su nombre.
Proceso de desarrollo
En esta sección veremos las diferentes etapas que hay que cubrir para llegar desde el fichero comprimido original hasta desplegar mapas en diversas plataformas con la información relevante del eclipse total. El código de lectura y tratamiento de datos se ha realizado en Python y se puede consultar en Github, en Google Colab y, el resultado, en Observable. El repositorio en Github se encuentra en el siguiente enlace:
Accede al repositorio del laboratorio de datos en GitHub
En Google Colab tenemos dos notebooks. El primero nos permite extraer y representar las zonas de sombra por el relieve natural a la hora del eclipse, mientras que el segundo nos permite obtener y visualizar las zonas de sombra creadas por el eclipse en sí:
Accede a los notebooks de Google Colab
Por último, en Observable podemos consultar el código que nos permite crear los mapas con la información extraída tanto en Leaflet como en D3.js:
Accede a los notebooks de Observable
1. Visibilidad por relieve
El primer paso de este ejercicio consiste en identificar puntos en los cuales el eclipse fue visible en condiciones ideales sin ningún tipo de nubosidad, circunstancia que no fue completamente ideal el día del eclipse, sobre todo en zonas costeras donde el calor generó brumas y niebla a última hora de la tarde.
Los datos que analizamos hacen referencia a los puntos afectados por el propio relieve y orografía de la península ibérica. Los datos ofrecidos en formato .TIFF detallan aquellos puntos donde la visibilidad fue total, parcial o nula por efecto del relieve asignando cuatro valores:
Valor 0: el terreno impide ver el eclipse.
Valor 1: el terreno permite ver la mitad superior del Sol.
Valor 2: el terreno permite ver la mitad superior y parte de la inferior del Sol.
Valor 3: el terreno permite ver en Sol en su integridad.
1.1 Lectura del fichero TIFF
Para la lectura del .TIFF utilizaremos la librería Rioxarray de Python, que nos permite volcar el contenido de un TIFF en un xarray, una estructura de datos ampliamente utilizada para trabajar con información georreferenciada. Una vez cargados los datos y formateados como xarray, es posible recurrir a la librería Matplotlib para crear un mapa e inspeccionar el ámbito geográfico que comprende, mostrado a continuación.
Figura 1: Mapa de visibilidad por relieve del Sol el 12 de agosto de 2026. Fuente: elaboración propia -datos.gob.es.
Los datos, como se mencionaba en la introducción, abarcan toda la península ibérica, parte de Francia y la zona occidental del norte de África, de forma que las Islas Baleares y las Canarias forman parte de un único conjunto de datos. Se puede observar en este punto cómo las zonas de sombra se relacionan de forma intuitiva con la orografía de cordilleras y mesetas, así como con la puesta de sol y la sombra que induce en el levante a la hora del eclipse.
Otra información relevante que podemos observar es la resolución de este conjunto de datos. En los ejes x e y se puede ver el número de puntos aproximado en cada una de las dimensiones, lo que se traduce en una alta resolución orientada a obtener el mayor detalle posible.
Dado que nuestro objetivo es desarrollar mapas y visualizaciones que puedan ser publicadas en la web, así como el tratamiento ágil de datos, nos centraremos en una zona en concreta, tomando como muestra la extensión de un municipio. De este modo, los ficheros de salida son relativamente ligeros y siempre por debajo de los 10Mb, permitiendo que los navegadores actuales sean capaces de procesarlos de forma rápida y eficiente.
1.2 Perímetro de estudio
Utilizando los datos sobre los perímetros municipales en el País Vasco, procedemos a la lectura del fichero SHP y a su estructuración en formato GeoPandas, una librería de Python que permite crear geometrías asociadas a una serie de propiedades y atributos de forma intuitiva.
Para la realización de este ejercicio seleccionamos el municipio de Amurrio, ya que presenta una orografía diversa que nos permite tener todo el espectro posible de visibilidades. En la siguiente imagen podemos observar los límites del municipio utilizando la librería Matplotlib de Python, contextualizados en coordenadas de longitud y latitud.
Figura 2: Mapa del perímetro del municipio de Amurrio en el País Vasco a partir del SHP accesible como datos abiertos. Fuente: elaboración propia -datos.gob.es.
1.3 Recorte del perímetro
Gracias a la librería Shapely de Python es posible recortar un xarray con la información municipal contenida en el GeoPandas. Una vez recortado, utilizamos Matplotlib para representar el subconjunto de datos, donde observamos la variedad de valores y, por tanto, la diversidad de lugares con visibilidad total, parcial o nula en una región relativamente pequeña dentro de lo que es la extensión de la península ibérica. A continuación observamos el patrón de una zona dominante de buena visibilidad y de otras de visibilidad más pobre.
Figura 3: Mapa de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
1.4 Exportar como GeoJSON
Una vez tenemos un conjunto de datos pequeño y manejable, podemos exportar cada uno de los puntos en formato GeoJSON. Este formato es muy versátil a la hora de exportar datos y utilizarlo en un gran número de aplicaciones y herramientas, a diferencia del TIFF original que suele estar restringido a programas específicos de sistemas de información geográfica.
1.5 Visualización en mapas del GeoJSON
El fichero GeoJSON resultante nos permite presentar la información en aplicaciones de visualización geográfica como KeplerGL o GoogleEarth, así como integrarla de forma sencilla en proyectos de visualización utilizando Javascript. Para ello, pueden utilizarse bibliotecas como Leaflet o D3.js, requiriendo únicamente unas pocas líneas de código.
La primera herramienta que utilizaremos para visualizar las zonas de sombra por relieve va a ser la herramienta KeplerGL, que ya introdujimos en un ejercicio anterior sobre de datos geoespaciales. Para ello, basta con arrastrar el fichero al interfaz de carga de archivos, tras lo cual se genera de forma automática una representación por polígonos asociado a cada punto. En la configuración de la visualización, vinculamos el color a la variable shadow y establecemos la escala tipo Quantize para distribuir los valores de forma homogénea a lo largo del intervalo. Finalmente, seleccionamos una capa base de imágenes satelitales para contextualizar la información y facilitar la identificación del relieve subyacente que da lugar a las zonas de mayor y menor visibilidad, tal y como vemos en la siguiente imagen.
Figura 4: Mapa en KeplerGL de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
La siguiente herramienta en la cual podremos visualizar el resultado de un GeoJSON es Google Earth. En su entorno de desarrollo podemos cargar el fichero GeoJSON, seleccionar la escala de colores y configurar distintos parámetros de visualización mediante el cuadro de diálogo correspondiente. A pesar de ser mucho más limitado en customización que KeplerGL, GoogleEarth cuenta con una precisa distribución tridimensional que permite asociar cada punto a su equivalente en el mapa, pero esta vez incorporando la altitud del punto. El efecto de distribuir puntos en altura dota de más realismo al mapa, tal y como se ilustra a continuación.
Figura 5: Mapa en GoogleEarth de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio. Fuente: elaboración propia -datos.gob.es.
Finalmente, el fichero GeoJSON podemos incorporarlo a un frontal web donde la librería Leaflet permite crear una cartografía en la que poder proyectar los puntos contenidos dentro del archivo de datos. En la siguiente imagen podemos ver el resultado, muy similar a los casos anteriores, donde sobre una imagen satelital tenemos los puntos que hemos extraído del TIFF originalmente. Este tipo de mapas podemos incorporarlos a frontales web con un alto grado de customización, superando las posibilidades ofrecidas por herramientas como KeplerGL o GoogleEarth. El notebook con el código de Javascript para Leaflet se puede consultar en Observable.
Figura 6: Mapa de las zonas de sombra naturales por elevación del terreno a la hora del eclipse en el municipio de Amurrio en Leaflet. Fuente: elaboración propia -datos.gob.es.
2. Zona de sombra proyectada del eclipse
Una vez que hemos identificado los puntos de la geografía ibérica en los cuales es posible ver el eclipse en su plenitud, pasamos a visualizar la trayectoria y extensión de la zona de sombra que proyecta la Luna sobre la superficie terrestre.
Para ello utilizamos el fichero .GPKG del CNIG, que incluye una capa dedicada a la localización y extensión de las zonas de sombra a determinados intervalos de tiempo.
2.1 Lectura de .GPKG
La lectura del archivo .GPKG la realizaremos con la ayuda de la librería GeoPandas de Python. En primer lugar, extraemos los nombres de las diferentes capas contenidas en el geopackage, siendo éstas definidas por las primeras dos palabras: oscurez_standard, moon_shadow y durtot_standard.
La capa que nos interesa es moon_shadow, así que volcamos el contenido de esa capa en un dataframe de GeoPandas. Para tener una perspectiva global de todo el recorrido de la sombra a través de la península, unimos todas las geometrías de cada intervalo temporal en una única forma geométrica.
2.2 Zona de sombra agregada
Con la ayuda de la librería Cartopy podemos crear un sencillo mapa de la extensión de todo el recorrido del eclipse sobre la península. A continuación se muestra el recorrido contextualizado por las coordenadas de latitud y longitud.
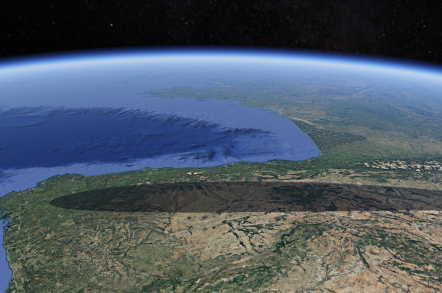
Figura 7: Mapa de la zona de sombra agregada creado por el eclipse desarrollado en Cartopy. Fuente: elaboración propia -datos.gob.es.
Al igual que en el caso de las zonas de sombra por relieve, nos interesa focalizar sobre el detalle, en este caso un intervalo temporal determinado. Para ello elegimos un tiempo concreto de la duración del eclipse y creamos un mapa específico para ese momento, lo cual nos permite ver con gran realismo qué forma puede llegar a tener la zona de sombra sobre la Tierra. En la siguiente imagen se muestra la zona de sombra para t = 200, unos 20 minutos tras el comienzo del eclipse.
Figura 8: Mapa de la zona de sombra a los 20 minutos del comienzo del eclipse creado en Cartopy. Fuente: elaboración propia -datos.gob.es.
2.3 Exportar como GeoJSON
Una vez tenemos seleccionado un momento y zona de sombra determinados, podemos exportar esa geometría en formato GeoJSON para poder utilizar otras herramientas más sofisticadas o para incorporarla a un entorno web. Para ello, redefinimos el orden de las coordenadas de los puntos que forman la geometría. Este paso, poco intuitivo, nos permite garantizar la correcta definición de la forma de la geometría en Javascript. Hay que tener en cuenta que en una forma geométrica cerrada, el interior puede ser considerado el exterior y viceversa. Forzando el orden de los puntos que se sigue para crear una forma geométrica cerrada garantizamos la definición de lo que es exterior e interior, facilitando así el posterior coloreado de la geometría en Javascript.
2.4 Visualización en mapas del GeoJSON
Al igual que en la sección sobre las zonas de sombra por relieve y orografía, incorporamos el fichero GeoJSON a diferentes herramientas y métodos de cartografía en Javascript para explorar diferentes formas de visualización, sacando partida de las ventajas de cada una de ellas.
En KeplerGL podemos subir el archivo GeoJSON de salida y crear una forma poligonal con todos los puntos contenidos en el fichero. El resultado es la zona de sombra proyectada sobre un mapa que podemos modificar tal y como explicamos en un ejercicio de datos previo. El resultado se muestra a continuación:
Figura 9: Mapa de las zonas de sombra creadas por el eclipse en KeplerGL. Fuente: elaboración propia -datos.gob.es.
Alternativamente podemos utilizar Google Earth y aprovechar su proyección cartográfica en forma de esfera para resaltar el efecto que produce el eclipse a escala planetaria y donde las formas geométricas curvas y distorsionadas cobran más realismo y sentido. Un eclipse no deja de ser el resultado de la interferencia de la luz entre dos esferas proyectada sobre otra esfera. En este contexto las proyecciones "planas" pierden la coherencia de una proyección esférica. El resultado se puede ver en la siguiente imagen.
Figura 10: Mapa de las zonas de sombra creadas por el eclipse en Google Earth. Fuente: elaboración propia -datos.gob.es.
A la hora de integrar estas visualizaciones en un entorno web, librerías de Javascript como Leaflet o D3.js son de gran ayuda, ya que con unas pocas líneas de código se puede crear un mapa con los polígonos contenidos en un GeoJSON, y personalizar los estilos de ese polígono de forma fácil e intuitiva. En el caso de Leaflet, muestra a continuación la extensión de la zona de sombra sobre una proyección satelital. El código correspondiente para la creación de este mapa se encuentra en un notebook de Observable:
Figura 11: Mapa de las zonas de sombra creadas por el eclipse en Leaflet. Fuente: elaboración propia -datos.gob.es.
En el caso de D3.js, aprovechamos la extensa librería de proyecciones cartográficas para crear un globo terráqueo y, al igual que en el caso de Google Earth, dar esa perspectiva planetaria que resulta, sin duda, más realista para comprender la naturaleza de un eclipse y el efecto combinado de las geometrías esféricas implicadas. En la siguiente imagen se puede ver el trazo de la zona de sombra elegido para este ejercicio. Para replicar este mapa se puede utilizar el código del notebook de Observable:
Figura 12: Mapa de las zonas de sombra creadas por el eclipse creado con D3.js. Fuente: elaboración propia -datos.gob.es.
Lecciones aprendidas
En este ejercicio de datos hemos aprendido a leer un fichero .TIFF o .GPKG, extraer la información relevante, volcar los datos sobre estructuras como xarray o GeoPandas, hacer un mapa preliminar sin salir de Python, exportar los datos en formato GeoJSON y, finalmente, explorar diversas herramientas dependiendo del entorno que necesitemos para el proyecto de visualización. De esta manera, hemos conseguido:
Adquirir familiaridad con diferentes formatos de información geográfica tales como .TIFF, .GPKG o .SHP. Esto nos permite aprovechar la riqueza en formatos disponibles, tener la misma información geográfica representada en diferentes formas y, por lo tanto, habilitar el uso de una plétora de herramientas para representar los datos.
Leer ficheros .TIFF a través de Python tanto para su representación gráfica como para su transformación a formatos válidos para crear visualizaciones en la web. En este proceso aprendemos, además, a realizar conversión de datos geográficos, pasando de ficheros de entrada .TIFF y .GPKG a ficheros de salida en un formato manejable y adecuado a entornos web como es el formato GeoJSON.
Delimitar zonas de interés a partir de archivos con una amplia cobertura espacial, para centrarse en poblaciones o regiones precisas y poder transmitir un mensaje concreto a la hora de comunicar información relevante. En concreto, aprendemos a recortar información georreferenciada en formato TIFF sobre un contorno específico como pueden ser los límites de un municipio y a descartar aquellos datos que estén fuera de ese contorno.
Utilizar las librerías Cartopy o Matplotlib de Python para hacer una visualización preliminar de la información contenida en un fichero TIFF.
Crear un globo terráqueo donde se pueda visualizar la zona de sombra de un eclipse utilizando Google Earth o D3.js, aportando una visualización con un mayor rigor astronómico.
Explorar distintas alternativas de visualización gracias a la diversidad de herramientas disponibles. En concreto, hacemos un recorrido por todo el espectro de complejidad de visualizaciones espaciales, desde herramientas intuitivas como GoogleEarth, con la cual el público ya está familiarizado gracias a GoogleMaps, hasta herramientas de código como Python o Javascript a través de D3.js.
Conclusiones
Este ejercicio de datos nos ha permitido pasar de formatos utilizados habitualmente en entornos profesionales de sistemas de información geográfica a otros más manejables para poder crear nuestros propios mapas, bien con la ayuda de aplicaciones populares como KeplerGL o GoogleEarth, bien con librerías de Javascript para su integración en proyectos web.
Asimismo, hemos visto cómo con unas pocas líneas de código podemos manipular los datos de entrada para focalizar sobre regiones de interés, seleccionar intervalos temporales determinados o personalizar mapas a nuestro gusto y elección.
Próximos pasos
Los pasos siguientes que se proponen para profundizar en el análisis son:
Explorar los formatos NetCDF o KML/KMZ, también georreferenciados, para tener un mayor control y dominio sobre los formatos de datos más populares en cartografía y análisis geoespacial.
Comparar las características astronómicas del eclipse de 2026 con los de 2027 y 2028, accesibles en el Catálogo de datos de datos.gob.es.
Representar variables que no se han mostrado en este ejercicio, como las efemérides o parámetros tales como la duración, la elevación o el azimut de los cuerpos celestes implicados en el eclipse.
Ámbitos de aplicación
El resultado de este ejercicio de visualización de datos aplica y apela a los siguientes ámbitos del análisis de datos:
Periodístico: para la divulgación de la información precisa referente a los eclipses de sol.
Científico: una vez los datos son accesibles, se pueden explorar todas las variables astronómicas incluidas en el conjunto de datos del CNIG y hacer un retrato del fenómeno astronómico mucho más completo que el descrito en este ejercicio.
Analítico: el ejercicio se ha ceñido a la visualización más tradicional en base a mapas y cartografías. Explorar otras formas de visualización con un conjunto de datos tan atractivo puede incentivar la creatividad y la innovación a la hora de representar este tipo de eventos.
Ciencia e tecnoloxía
Introducción
En 2018 la compañía Uber creó una herramienta para poder visualizar información geoespacial y poder representar gráficamente miles de puntos de localización, así como trayectorias en un amplio rango temporal. Esta herramienta pasó a ser de dominio público bajo el nombre de KeplerGL y, a día de hoy, está disponible como código abierto para la realización de mapas de forma sencilla.
KeplerGL permite representar información georreferenciada en un interfaz web sin necesidad de utilizar herramientas como ArcGIS o QGIS, o cualquier otro software que necesite de instalación en el ordenador o de complejas actualizaciones.
KeplerGL ofrece una amplia variedad de formas de representación, desde los convencionales puntos o rectángulos a formas de clustering tipo hexagonal binning o mapas de calor, hasta sistemas de mallas más sofisticados como H3.
Toda la gama de elementos gráficos viene con una serie muy completa de opciones de customización, tanto en el tamaño como en el color pasando por los rangos de valores. La propia cartografía de fondo que se utiliza para referenciar la información que queremos visualizar también dispone de todo un catálogo de opciones, entre los que se incluyen fondos claros, oscuros o imágenes satelitales del espectro visible.
En este ejercicio visualizaremos información georreferenciada relacionada con la actividad sísmica de la erupción del volcán de la Palma en torno a septiembre de 2021. Esta información se vio reflejada de formas diversas en varias infografías en medios de comunicación de ámbito estatal, donde se geolocalizaban los epicentros de los terremotos tomando como referencia la isla de La Palma. En la Figura 1 observamos el mismo tipo de mapa, en el cual se superponen círculos a una cartografía de fondo, y donde el radio de los círculos es proporcional a la actividad sísmica. En este ejercicio aprenderemos a hacer mapas similares en contenido y en estilo de forma rápida e intuitiva gracias a KeplerGL.
Figura 1: Mapa mostrado en diversos medios de comunicación con los epicentros de la actividad sísmica previa a la erupción del volcán de la Palma. (a) Antena3, (b) Telemadrid, (c) La Vanguardia y (d) ElDiario.es
Para crear el mapa de actividad sísmica tenemos dos alternativas dependiendo del nivel de detalle y de procesamiento que queramos realizar:
La primera opción es utilizar los datos que nos bajaremos directamente del portal de datos tal y como están. En el apartado de Datos para el ejercicio se indica el enlace a través del cual podemos acceder a un fichero .CSV con todos los datos que necesitamos para crear el mapa y desarrollar todo el ejercicio sin necesidad de programar ni crear código.
La segunda opción es procesar y filtrar los datos a través de Python por si queremos familiarizarnos con unas líneas sencillas de código y así seleccionar variables o intervalos temporales de nuestro interés. El acceso al repositorio de Github y el notebook de Google Colab para realizar la lectura, selección de variables y criterios de filtrado para obtener un subconjunto de datos se puede realizar a través de los siguientes enlaces:
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Datos para el ejercicio
En este ejercicio vamos a utilizar datos abiertos del Cabildo Insular de La Palma recopilados durante la actividad sísmica anterior y posterior a la erupción volcánica en La Palma en 2021, y que están disponibles aquí:
https://datos.gob.es/es/catalogo/l03380010-terremotos
En este dataset encontramos el registro de cada uno de los puntos en los que se detectó actividad sísmica durante esos días, así como, entre otras, las siguientes métricas que caracterizan sus propiedades geológicas:
Metrica
Descripción
ID
Identificador asociado a cada evento
Datetime
Fecha y hora de cada evento
ErrTime
Error asociado al tiempo de registro
RMS
Root Mean Square del tiempo de propagación
Latitude
Coordenada de latitud en grados
Longitude
Coordenada de longitud en grados
Az
Grado azimutal
Depth
Profundidad del evento en kilómetros
ErrDepth
Error asociado a la medida de la profundidad
Nsta
Número de estaciones empleadas en medir el evento
Gap
Mayor diferencia azimutal entre estaciones adyacentes
Author
Organismo responsable de la medición
Magnitud
Magnitud sísmica del evento
IntensMax
Intensidad máxima del evento
Localización
Localización
TipoMagnit
Tipo de magnitud
XUTM
Coordenada de longitud en el sistema UTM
YUTM
Coordenada de latitud en el sistema UTM
GlobalID
Identificador del evento
Para la creación del mapa nos centraremos en la variable asociada a la actividad sísmica: magnitud, así como la longitud y latitud de cada punto y la fecha y la hora de cada evento.
Proceso de desarrollo
1. Acceso a la interfaz web
Como mencionábamos en la introducción, KeplerGL no necesita de instalación en el ordenador, sino que se accede a través de internet a su interfaz. Por lo tanto, lo primero que haremos será abrir un navegador y acceder a la web de KeplerGL a través del dominio:
https://kepler.gl/
Una vez en la página de inicio haremos click sobre Get Started para poder subir los datos y empezar a crear nuestro mapa.
Como vemos en la Figura 2, KeplerGL incluye otras opciones, como acceder a datos que estén almacenados en una base de datos o consultar directamente el código Github, especialmene útil para desarrolladores o para integrar KeplerGL dentro de otras aplicaciones. No obstante, en este caso nos centraremos en la opción más sencilla: la carga de nuestros datos directamente en la interfaz.
Figura 2: Pantalla principal de KeplerGL donde se nos ofrece un ejemplo de visualización, así como la opción de empezar el proceso de creación de nuestro mapa.
2. Carga de datos en la página
En la página de carga de datos tenemos el habitual cuadro de diálogo para poder subir nuestros datos. Como vemos en la Figura 3, KeplerGL acepta diferentes formatos:
CSV: el tradicional formato con valores, generalmente separados por comas.
JSON: alternativa al CSV con entradas estructuradas en formato de listas y objetos
GeoJSON: formas geométricas estructuradas como un JSON.
Arrow: datos estructurados en columnas para la aplicación Apache Arrow.
Parquet: formato en columnas para grandes cantidades de datos.
En este punto subiremos los datos que hemos obtenido directamente del portal o aquellos filtrados que hemos realizado con el código de Python reflejado en el repositorio de Github y el notebook de GoogleColab. Ambas opciones son válidas para crear los mapas.
Figura 3: Cuadro de dialogo para la carga de archivos, ya sea mediante la selección desde el ordenador o arrastrándolos directamente al navegador.
3. Visualización
KeplerGL nos permite representar la informacion geografica a través de varios elementos, como puntos, rejillas (grids), distribuciones en hexágonos, mapas de calor, así como proyectar todas estas formas en tres dimensiones. En la Figura 4 se detallan los diferentes tipos de visualización posibles que ofrece la herramienta.
Figura 4: Opciones de visualización de la información georreferenciada, que incluye puntos, trayectorias, líneas, cuadros, hexágonos, polígonos, clusters, iconos, mapas de calor, celdas H3, tridimensional, viajes, celdas S2, vectorial y rasters.
A continuación vemos en detalle las características de las formas de visualización que podemos explorar con este conjunto de datos.
3.1 Puntos
Dentro de los puntos podremos parametrizar las siguientes variables: color del punto, borde del punto, magnitud adicional asociada al radio, dimensiones del radio, etiquetas, tooltip con información, interacción entre superposiciones o transparencia.
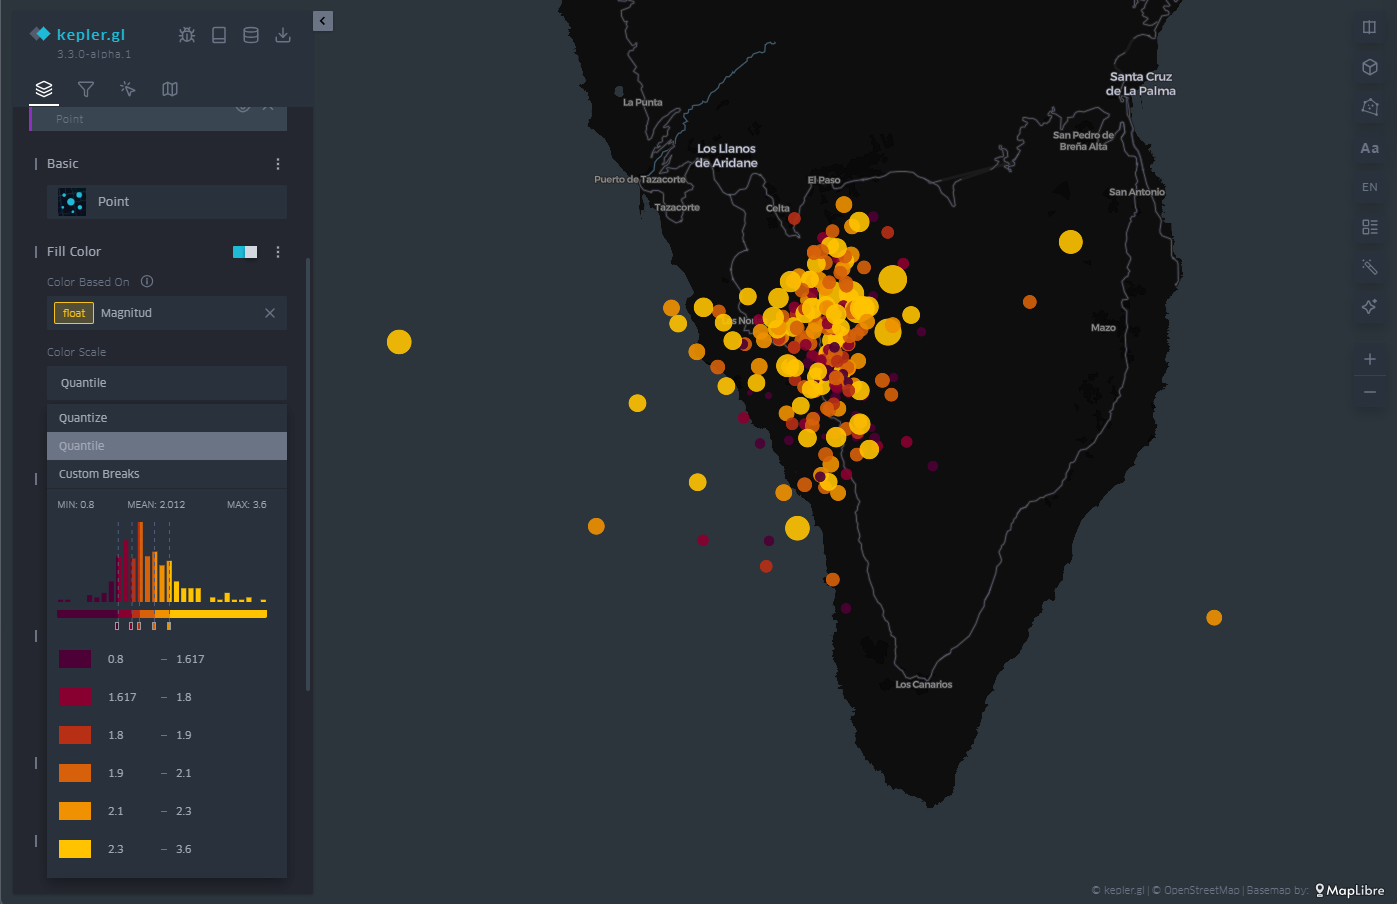
En la Figura 5 podemos observar la aplicación directa de la representación por puntos. KeplerGL identifica tanto la latitud como la longitud automáticamente para situar sobre el plano cada uno de los puntos. A partir de ahí dibuja un círculo con un radio determinado y asigna un color dependiendo de la intensidad de la magnitud.
En el panel de control de la izquierda se puede controlar tanto el radio de los círculos como la paleta de colores, y aplicar las opciones que más nos gusten para representar la intensidad. El hecho de poder jugar con ambos parámetros nos permitiría añadir otro eje de información a la visualización. En este caso, por simplicidad, dejamos esta representación tal y como está, explorando únicamente el color.
Figura 5: Mapa con los seísmos en la isla de La Palma representados por puntos. El color y el radio es proporcional a la magnitud del seísmo.
3.2 Malla de puntos
De la misma forma que KeplerGL identifica la latitud y la longitud para situar los círculos, también es capaz de promediar los valores de magnitud en celdas. Dichas celdas pueden englobar uno o varios puntos, y KeplerGL asigna en consecuencia un color que representa su valor en base al valor promedio, como vemos en la Figura 6.
Al igual que en el caso de los puntos, el cuadro de diálogo de la izquierda permite cambiar la paleta de colores, aumentar o disminuir el tamaño de las celdas para promediar sobre áreas más extensas o reducidas. Igualmente, la escala de valores sobre la cual se basa la asignación de cada uno de los colores de la escala también está sujeta a su personalización, dependiendo del rango de valores que queramos destacar en la visualización.
Figura 6: Mapa con los seísmos en la isla de La Palma representados por una malla. El color está asociado a la escala de magnitud del seísmo.
3.3 Hexbin
Similar a la malla de celdas, hexbin es un acrónimo de hexagonal binning, es decir, promediado de valores sobre celdas con forma de hexágono. A diferencia de las celdas rectangulares, el empaquetamiento de celdas con forma de hexágono responde a estructuras más compactas, similares a las que pueden observarse en la organización de partículas o átomos en la formación de estructuras de estado sólido.
El hexbin tiene las mismas propiedades que hemos visto en el caso de la malla de celdas, es decir, podemos cambiar el tamaño de la celda hexagonal para que ocupe una mayor superficie en su promedio, podemos cambiar igualmente la paleta de colores y también el rango de valores sobre el cual actúa cada intervalo de color. Un ejemplo del hexagonal binning se encuentra en la Figura 7.
Figura 7: Mapa con los seísmos en la isla de La Palma representados por hexágonos. El color está asociado a la magnitud del seísmo y el hexágono agrega los puntos que cubre su extensión.
3.4 Heatmap
La última de las representaciones que veremos en el plano es el mapa de calor o heatmap, en su concepción en inglés. El heatmap no es más que un diagrama de contorno, donde cada curva de nivel corresponde a un intervalo determinado de valores. En el momento en el que el número de curvas de nivel es muy elevado obtenemos esa sensación de continuo que evoca al mapa de calor.
En este caso, tanto la paleta de color elegida con su número de niveles como el radio sobre el cual se promedian los valores son personalizables a través de las opciones del menú de la izquierda. En la Figura 8 tenemos un ejemplo, donde la densidad de eventos aflora de forma natural con este tipo de representación.
Figura 8: Mapa con los seísmos en la isla de La Palma representados por un mapa de calor. El color está asociado a la densidad de eventos sísmicos.
3.5 Tridimensionalidad
Por último, en la representación geográfica tenemos la posibilidad de utilizar el eje z, o eje vertical, para añadir o redundar información en esa dimensión. Para ello tenemos la opción denominada "Height" dentro del menú de la izquierda. La opción "Height" aplica tanto a círculos como a mallas de celdas, donde afecta al polígono que define cada una de las celdas.
De esta forma, proyectamos en la vertical otra magnitud a nuestra elección, que complementa aquella magnitud ya representada por el color de las celdas o círculos sobre el plano, tal y como ilustra la Figura 9.
Figura 9: Mapa con los seísmos en la isla de La Palma representados por rectángulos. La altura y el color están asociados a la magnitud del seísmo.
3.6 Filtro Temporal
Como se puede ver en la Figura 10, en el menú superior de la izquierda encontramos una herramienta de gran utilidad como es el filtro de tiempo. Cuando, como en este caso, disponemos de información temporal de los eventos, a través del campo de fecha, podemos utilizar ese eje de información para filtrar la información que queremos representar y focalizar sobre aquellos días u horas de mayor interés para nuestro análisis y proyecto de visualización.
La herramienta de filtro permite elegir la magnitud sobre la cual vamos a realizar la selección filtrada. Una vez elegida, se despliega en la parte inferior un histograma en el cual podemos ver a simple vista la distribución del número de puntos que se corresponden con cada fecha. En la Figura 10 podemos ver el histograma en la parte inferior.
Esta herramienta permite no sólo seleccionar un día sino también un intervalo de tiempo. Deslizando ese intervalo de tiempo a lo largo del histograma nos permite, no sólo ver un determinado periodo de interés, sino también realizar una animación que desplace de forma automática ese intervalo de tiempo a lo largo de toda la serie temporal.
Esta característica hace de este filtro una opción muy atractiva para poder crear en segundos lo que se conoce como storytelling, esto es, una animación fácil y muy intuitiva.
Figura 10: Mapas con los seísmos en la isla de la Palma a través de puntos con un filtro temporal aplicado a toda la secuencia de datos en la parte inferior. El intervalo a media altura en el histograma especifica la longitud temporal.
Como ejemplo de animación podemos ver en la Figura 11 un vídeo donde se muestra la herramienta del filtro y cómo la ventana que definimos va recorriendo el histograma. Esta animación se centra en los días anteriores y posteriores a la erupción del volcán el 19 de septiembre de 2021, así como toda la actividad sísmica que siguió a la erupción del volcán hasta entrado 2022.
El acceso al vídeo se puede realizar tanto a través de la miniatura de Youtube de la Figura 11 como a través de este enlace al canal de vídeos de datos.gob.es:
Accede al vídeo de la actividad sísmica en KeplerGL
Figura 11: Secuencia de la actividad sísmica detectada antes, durante y después de la erupción volcánica en la isla de La Palma alrededor de septiembre de 2021.
3.7 Leyenda
Como se ilustra en la Figura 12, en el menú de la derecha tenemos diferentes opciones, tales como disponer la proyección cartográfica en tres dimensiones o, en la esquina inferior derecha, activar la aparición de una leyenda.
La leyenda aparece asociada a la variable que hemos elegido para representar los puntos, en este caso, la magnitud. Los intervalos vienen predefinidos según los intervalos que hayamos definido cuando creamos los intervalos en la escala de color de los puntos.
Figura 12: Leyenda del código de colores y valores utilizado para la representación por puntos, en sintonía con nuestras definiciones de intervalos en la configuración de la representación por puntos.
3.8 Cartografía de fondo
Dependiendo del evento que representemos en el mapa, es conveniente utilizar diferentes tipos de cartografías de fondo para una mejor comprensión del mensaje que se intenta transmitir a través de la visualización. Dependiendo de la audiencia y del contexto, la información que ofrece el mapa de fondo puede resultar más o menos útil. Si, como es en este caso, sólo queremos transmitir información geológica, su relevancia es menor. Si, por el contrario, queremos describir también infraestructuras civiles que se puedan ver afectadas por los terremotos, será necesario incorporar una cartografía base.
De esta forma, KeplerGL ofrece también toda una serie de cartografías de fondo, divididas mayormente en dos familias: las de fondo oscuro y las de fondo claro. Aquí conviene recordar que el ojo humano percibe mejor detalles pequeños sobre un fondo oscuro, e interpreta mejor formas grandes sobre fondo claro. En el caso de los terremotos y la escala a la cual los estamos representando, conviene utilizar un fondo oscuro, ya que seremos capaces de discernir con mejor precisión las distancias y los detalles.
Para seleccionar los diferentes mapas de fondo iremos al icono situado en la parte superior del panel de la izquierda, y en el menú desplegable podremos elegir aquel que más nos convenga. En la Figura 13 se muestran los diferentes tipos de mapas.
Figura 13: Diferentes cartografías de fondo en KeplerGL para la representación de la actividad sísmica en la isla de La Palma en septiembre de 2021: Positron (a), Satellite (b), Voyager (c) y Light (d).
4. Exporta el mapa
Por último, una vez realizado nuestro mapa, podemos exportar el resultado a través del icono de descarga situado en la parte superior del menú de la izquierda. Una vez seleccionado ese icono podemos guardar el mapa como imagen.
Las opciones que se nos ofrecen son: el tamaño mediante el ratio de la imagen respecto a sus dimensiones horizontales y verticales, la resolución ligada a ese ratio que hayamos seleccionado y la opción de incorporar una leyenda en la imagen de salida, tal y como muestra la Figura 14.
Figura 14: Cuadro de diálogo para exportar el mapa como una imagen. Nótese la selección de la casilla de mostrar la leyenda, así como la selección de un formato panorámico con espacio para incorporar más adelante elementos infográficos en otros contenidos
Adicionalmente existe la posibilidad de compartir el mapa con toda su interactividad a través del registro en Dropbox o en Carto, si la intención es la difusión del mapa a través de otros canales más allá de una imagen estática.
Lecciones aprendidas
En este ejercicio hemos aprendido a crear un mapa de forma sencilla e intuitiva con la ayuda de KeplerGL. En concreto hemos aprendido a:
Subir un fichero a través del interfaz web de KeplerGL.
Representar de diferentes maneras información georreferenciada.
Aprender a utilizar un filtro temporal sobre la serie de datos y crear una animación para su difusión como vídeo.
Añadir una leyenda y manejar los valores que refleja esa leyenda.
Customizar cada una de las formas de visualización al detalle.
Exportar el mapa resultante con un cierto grado de customización.
Conclusiones y próximos pasos
El mundo de la cartografía siempre ha necesitado de conocimientos previos sobre proyecciones, sistemas de referencia, formatos de datos georreferenciados y sobre todo la instalación de software específico para crear mapas. Gracias al desarrollo de productos web uno de estos proyectos nos permite crear mapas de forma muy sencilla y puede suponer una herramienta muy potente a la hora de crear mapas sin necesidad de muchos conocimientos previos y con un alto grado de customización.
A partir de este punto se pueden explorar herramientas más sofisticadas que requieren bien de conocimientos generales, bien de conocimientos de programación para poder realizar mapas con Leaflet o con D3.js, dependiendo de la audiencia y de la aplicación en la cual queremos encuadrar el mapa.
Ámbitos de Aplicación
La creación de mapas sencillos tiene muchos campos de aplicación, ya que la cartografía en general resulta ser una de las formas de visualización más claras y populares gracias a su uso desde el origen de la civilización. Los ámbitos propuestos incluyen:
Redacciones de periodismo: reaccionar a eventos concretos tales como catástrofes naturales o grandes bases de datos de eventos georreferenciados puede ser más fácil gracias a herramientas como KeplerGL.
Corporaciones y empresas: localización de volúmenes asociados a puntos concretos de la geografía se puede leer de forma intuitiva con la creación de mapas que pueden resumir grandes cantidades de datos.
Aplicaciones: Integrar mapas dentro de las aplicaciones suele ayudar tanto en las capas tanto de información como en la de interactividad para explorar el rendimiento y resultado de un producto a diferentes escalas.
Ciencia e tecnoloxía
Enerxía
Economía
Introducción
En los últimos años hemos visto cómo la inteligencia artificial generativa ha dejado de ser una curiosidad técnica para convertirse en una herramienta cotidiana en el flujo de trabajo de los profesionales del dato. Sin embargo, sigue existiendo una pregunta importante: ¿cómo se traduce esta tecnología en un proceso real de análisis de datos abiertos?, ¿Qué cambia en la práctica cuando un analista trabaja "junto a" un modelo de lenguaje en lugar de hacerlo en solitario?
Este post documenta un ejercicio práctico realizado con datos publicados en el portal datos.gob.es: el análisis de precios de las más de 11.000 estaciones de servicio en España. A diferencia de otros ejercicios publicados en este espacio, el análisis no se ha realizado de forma manual línea por línea, sino que se ha llevado a cabo en un entorno agéntico: una interfaz conversacional apoyada en un modelo grande de lenguaje (LLM) y un sistema de codificación asistido por inteligencia artificial. En la práctica, esto significa que en lugar de escribir el código de análisis nosotros mismos, le describimos al sistema en lenguaje natural qué queremos obtener, y este lo implementa.
El objetivo de este post es doble. Por un lado, explicar el análisis propiamente dicho: qué preguntas nos hacemos sobre los datos, qué problemas técnicos encontramos y qué conclusiones extraemos. Por otro, reflexionar sobre el método: cómo se estructura un proceso de análisis cuando trabajamos con un copiloto de IA, qué patrones de interacción funcionan mejor y dónde están los límites de la asistencia automatizada.
Nota metodológica: para la realización de este ejercicio hemos empleado una metodología Spec Driven Development (SDD), que guía a la IA a través de un proceso estructurado con el objetivo de evitar que la conversación pierda el foco del ejercicio. La explicación detallada de esta metodología queda fuera del alcance del presente post, pero el lector encontrará en el repositorio especificaciones, planes técnicos y checklists que la documentan.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
El proceso: un flujo clásico, asistido por IA
Antes de entrar en cada fase, conviene describir el esquema general del trabajo. El análisis sigue cinco etapas habituales en ciencia de datos —ingesta, limpieza, exploración, ingeniería de variables y análisis de impacto— pero introduciendo en cada una de ellas un patrón conversacional con la IA.
Ese patrón puede resumirse en cinco pasos:
Describir el problema en lenguaje natural.
Proponer una primera solución (lo hace la IA).
Cuestionar los supuestos de esa propuesta (lo hace el analista humano).
Refinar la solución hasta que sea robusta.
Documentar el patrón para reutilizarlo en futuros proyectos.
A continuación, veremos, fase por fase, cómo se materializa este patrón en el análisis del precio de los combustibles. Cada apartado comienza explicando el reto conceptual, continúa describiendo cómo abordamos la resolución con la asistencia de la IA, y termina mostrando el código resultante y las lecciones aprendidas.
Fase 1: ingesta robusta de datos desde una API pública
El reto: API públicas que no siempre responden como se espera
Aviso para el lector: esta fase entra en cierto detalle técnico sobre integración de API, errores SSL y estrategias de respaldo. Si tu perfil es más analítico que de desarrollo, puedes hojear el bloque de código y centrarte en los apartados El enfoque y Reflexión, donde la idea de fondo —cómo diseñar una ingesta tolerante a fallos— se explica sin entrar en detalles de implementación.
La descarga de datos desde la API del Ministerio para la Transición Ecológica es conceptualmente sencilla: una petición HTTP GET a un endpoint conocido debería devolver un fichero JSON con aproximadamente 11.000 estaciones de servicio. En la práctica, sin embargo, las API públicas presentan dificultades habituales que cualquier analista termina encontrando antes o después:
Certificados SSL caducados o mal configurados, que provocan errores del tipo SSLError.
Bloqueo de IP procedentes de servidores en la nube (Google Colab, AWS, etc.), interpretadas como tráfico sospechoso.
Servidores inestables, con tiempos de respuesta variables y timeouts esporádicos.
Inconsistencias en la documentación, por ejemplo, cuando se describe una respuesta JSON pero el servidor devuelve XML.
La pregunta clave es: ¿cómo diseñamos un sistema de ingesta que tolere estos problemas en lugar de fallar al primer obstáculo?
El enfoque: una arquitectura de respaldos escalonados
En ingeniería de software, los sistemas críticos no dependen de un único componente. Cuando un canal falla, existe otro de respaldo (lo que en inglés se denomina fallback). Aplicar esta lógica a la ingesta de datos es especialmente útil cuando trabajamos con fuentes públicas sobre las que no tenemos control.
Para este ejercicio, diseñamos una estrategia de triple respaldo:
Primer intento — requests con configuración permisiva: realizamos la petición HTTP con la librería estándar de Python, pero configurando un User-Agent que simula un navegador real y desactivando la verificación de SSL. Esto resuelve buena parte de los problemas de certificados.
Segundo intento — curl desde la shell: si requests falla, invocamos curl como subproceso. La razón es que curl utiliza una pila TLS distinta a la de Python y no envía los mismos certificados, lo que permite sortear ciertos tipos de bloqueo.
Tercer intento — datos de demostración: si todo lo anterior falla, generamos un conjunto sintético de 11.000 estaciones de servicio con distribuciones realistas. Esto garantiza que el notebook siempre sea ejecutable en un contexto educativo, aunque la API esté caída.
El razonamiento de fondo es sencillo: cada método sortea un tipo distinto de fallo de red, y su combinación proporciona robustez. A continuación, mostramos el código que implementa esta arquitectura.
El código resultante
El siguiente fragmento ilustra cómo se materializan los tres niveles de respaldo en una única función. Las cláusulas try/except permiten detectar el fallo de cada método y pasar automáticamente al siguiente:
def descargar_datos_api(url):
"""
Descarga datos con triple respaldo:
1. requests con verify=False (sortea problemas de SSL)
2. curl -k (pila TLS alternativa)
3. datos sintéticos (garantía de ejecución)
"""
# Intento 1: requests con cabeceras de navegador
try:
sesion = requests.Session()
sesion.headers.update({
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
})
response = sesion.get(url, timeout=45, verify=False)
return response.json()
except Exception as e_requests:
print(f"[Respaldo 1] requests ha fallado: {e_requests}")
# Intento 2: curl como subproceso
try:
resultado = subprocess.run(
["curl", "-s", "-k", url],
capture_output=True, timeout=45, text=True
)
return json.loads(resultado.stdout)
except Exception as e_curl:
print(f"[Respaldo 2] curl ha fallado: {e_curl}")
# Intento 3: datos sintéticos de demostración
print("[Respaldo 3] Utilizando datos de demostración")
return generar_datos_demo_gasolineras(11000)
Reflexión: dónde aporta valor la IA en esta fase
La iteración con la IA no produjo el código anterior de un solo intento. El proceso real fue más interesante: planteamos el problema ("la API a veces rechaza las peticiones, necesito respaldos"), la IA propuso una solución inicial, y el avance vino de cuestionar esa propuesta. La pregunta "¿por qué curl debería funcionar si requests ya ha fallado?" obligó al modelo a explicar las diferencias entre ambas pilas TLS, lo que a su vez nos permitió validar que la solución tenía fundamento técnico real, no era simplemente "probar lo mismo dos veces".
Una estimación razonable: resolver este problema mediante prueba y error puro habría llevado entre dos y tres horas de depuración. Con la iteración asistida, lo abordamos en aproximadamente treinta minutos.
Fase 2: limpieza con conocimiento de dominio
El reto: los datos reales nunca son perfectos
Una vez descargados los datos, comienza el trabajo menos visible pero más decisivo de cualquier análisis: la limpieza y preparación. La calidad del resultado final depende en gran medida del cuidado puesto en esta etapa. En el caso de los combustibles, las inconsistencias más habituales son:
Variantes textuales no normalizadas: la marca "MOEVE" puede aparecer como "MOEVE", "Moeve" o "moeve" en distintos registros. Para una persona son obviamente la misma marca, pero en una agregación por groupby aparecen como tres categorías independientes.
Coordenadas geográficas incorrectas: puntos situados fuera del territorio español (islas remotas, fragmentos de Marruecos, errores de captura).
Separadores decimales inconsistentes: precios codificados como "1,349" con coma, que requieren conversión explícita antes de poder operar con ellos.
Conversiones que introducen valores nulos: pd.to_numeric(..., errors='coerce') es muy útil, pero genera NaN silenciosos que pueden romper análisis posteriores.
La cuestión central de esta fase es: ¿cómo traducimos el conocimiento humano sobre el dominio en reglas de código?
El enfoque: validación organizada en capas
En lugar de limpiar "según va apareciendo", conviene organizar las reglas de validación en capas, cada una con una responsabilidad clara:
Capa
Responsabilidad
Ejemplo
Tipos
Conversión y coerción a tipos adecuados
Precio como float, fecha como datetime
Rangos
Valores dentro de límites razonables
Precio entre 0,5€ y 3,0€ por litro
Semántica
Coherencia con el dominio
Coordenadas dentro de España, marcas normalizadas
Figura 1. Tabla de validación organizada en capas. Fuente: elaboración propia - datos.gob.es
La pregunta que cada capa debe responder es siempre la misma: ¿tiene sentido este valor en el contexto de las estaciones de servicio españolas? La novedad respecto a un flujo manual es que aquí describimos las reglas a la IA en lenguaje natural y dejamos que ella las traduzca a código pandas. Nosotros conservamos la responsabilidad de definir qué es válido y qué no.
El código resultante
El siguiente bloque implementa las tres capas de validación de forma secuencial. Conviene destacar que la lista de aliases de marcas (CEPSA → MOEVE) refleja conocimiento de negocio específico —el rebranding de CEPSA a MOEVE en 2023— que la IA no podría inferir por sí sola; es información que aporta el analista. Este es un ejemplo muy claro de aportación del conocimiento humano difícilmente alcanzable por la IA:
def validar_y_limpiar_carburantes(df):
# Capa 1: normalización de tipos
df['precio'] = (
df['precio'].astype(str)
.str.replace(',', '.')
.astype(float)
)
df['marca'] = df['marca'].str.upper().str.strip()
# Capa 2: validación de rangos
df = df[(df['precio'] >= 0.5) & (df['precio'] <= 3.0)]
df = df[
(df['latitud'] >= 27.5) & (df['latitud'] <= 43.8) &
(df['longitud'] >= -18.2) & (df['longitud'] <= 4.4)
]
# Capa 3: coherencia semántica (conocimiento de negocio)
aliases = {'CEPSA': 'MOEVE'} # Rebranding 2023
df['marca'] = df['marca'].map(lambda x: aliases.get(x, x))
# Auditoría de nulos
nulos = df[['precio', 'latitud', 'longitud', 'marca']].isnull().sum()
if nulos.sum() > 0:
print(f"Atención: se han detectado valores nulos:\n{nulos}")
return df.dropna(subset=['precio', 'latitud', 'longitud'])Reflexión: el reparto del trabajo entre la IA y el analista
Esta fase es especialmente reveladora del tipo de colaboración que la IA habilita. Las reglas más técnicas (conversión de tipos, detección de nulos, normalización de mayúsculas) son prácticamente automáticas: basta con describir el problema y el modelo propone una implementación correcta. En cambio, las reglas que dependen del dominio (que las islas Canarias tienen un sobrecoste logístico del 5%, que CEPSA y MOEVE son la misma marca tras la fusión, que un precio inferior a 0,5€ es probablemente un error de carga) deben ser especificadas por el analista humano.
La lección aprendida es importante: la calidad de la limpieza depende directamente del conocimiento de dominio que aporta el analista. La IA acelera la implementación, pero no inventa contexto. Por eso el patrón reutilizable es el mismo en cualquier proyecto: describe tu dominio con detalle, deja que la IA escriba las validaciones, y verifica tú mismo que los resultados son coherentes.
Fase 3: análisis exploratorio visual (EDA)
El reto: convertir números en intuiciones
Con 11.000 registros limpios ya en memoria, el siguiente paso es responder a las preguntas de negocio que motivaron el análisis. En este caso, formulamos cuatro preguntas concretas:
¿Qué provincias tienen los combustibles más caros?
¿Existe relación entre la ubicación geográfica (latitud y longitud) y el precio?
¿Hay diferencias significativas entre marcas?
¿Cómo se distribuyen los precios (media, mediana, valores atípicos)?
El reto técnico no es complejo —pandas y matplotlib resuelven cualquiera de estas preguntas— pero sí lo es el reto metodológico: elegir la visualización adecuada para cada pregunta. Una gráfica mal elegida puede ocultar tanto como una agregación incorrecta.
El enfoque: cada pregunta determina su gráfico
En análisis exploratorio existe una correspondencia natural entre el tipo de pregunta y la visualización más apropiada. Conviene tenerla presente antes de escribir una sola línea de código:
Pregunta
Visualización adecuada
Razón
¿Ranking?
Gráfico de barras ordenado
Permite comparar valores ordenados
¿Relación espacial?
Scatter con escala de color
Muestra correlación en dos dimensiones
¿Distribución y atípicos?
Diagrama de caja (box plot)
Revela mediana, cuartiles y outliers
¿Diferencias entre grupos?
Box plot o violin plot
Compara distribuciones simultáneamente
Figura 2. Tabla de correspondencia natural entre el tipo de pregunta y la visualización más adecuada. Fuente: elaboración propia - datos.gob.es
El objetivo no es producir gráficos vistosos, sino gráficos que respondan a preguntas concretas. Esta es una idea aparentemente obvia, pero conviene recordarla: en la práctica, es frecuente que se generen visualizaciones por inercia, sin tener claro qué se quiere mostrar.
El código resultante
A continuación, mostramos uno de los gráficos como ejemplo, el ranking de precios por provincia. La estructura es siempre la misma: declaración del gráfico, configuración estética, y un breve comentario interpretando el resultado:
# Pregunta 1: ¿qué provincias son las más caras?
top_provincias = (
df.groupby('provincia')['precio']
.mean()
.sort_values(ascending=False)
.head(12)
)
fig, ax = plt.subplots(figsize=(12, 6))
top_provincias.plot(kind='bar', ax=ax, color='steelblue')
ax.set_title('Precio medio del combustible por provincia (Top 12)',
fontsize=14, fontweight='bold')
ax.set_ylabel('Precio (€/litro)')
ax.set_xlabel('Provincia')
plt.xticks(rotation=45, ha='right')
plt.tight_layout()
plt.show()
# Hallazgo: las tres provincias más caras son insulares o costeras
# (Baleares, Canarias, Tarragona). Hipótesis: el coste logístico
# y la lejanía a los hubs de distribución elevan el precio.En el caso del scatter geográfico, aplicamos una segmentación adicional —península, Baleares y Canarias— para visualizar simultáneamente la ubicación y la insularidad. Esta segmentación reveló un patrón que ninguna agregación numérica había mostrado claramente: las estaciones insulares tienen precios sistemáticamente superiores, hallazgo probablemente atribuible a costes de transporte marítimo. El insight no emergió de un cálculo, sino de la visualización.
Reflexión: el punto ciego de la IA
Esta fase pone de manifiesto una limitación importante del modelo: la IA no ve el resultado gráfico. Puede sugerir el tipo de visualización adecuado, escribir el código correctamente y proponer una paleta de colores, pero no puede juzgar si la escala del eje es apropiada, si la densidad de puntos satura el gráfico o si los rótulos se solapan. Todas estas validaciones siguen siendo responsabilidad humana.
En la práctica, esto significa que la fase de EDA es la que requiere más iteración entre persona y máquina: la IA escribe, el analista observa, identifica un problema visual ("este eje no muestra bien la variación"), y describe la corrección ("ajusta el eje Y a [precio_min0.95, precio_max1.05]"). El patrón reutilizable es claro: una pregunta clara, un tipo de gráfico adecuado y una validación visual humana.
Fase 4: ingeniería de variables (feature engineering)
El reto: capturar variación con nuevas variables
El análisis exploratorio identifica patrones, pero rara vez los explica. Para entender qué factores influyen en el precio es necesario construir nuevas variables —features— que capturen hipótesis específicas sobre la dinámica del mercado. En este ejercicio formulamos tres hipótesis:
Temporal: ¿Influye el día de la semana en el precio? ¿Es más caro repostar en fin de semana?
Geográfica: ¿Influye la distancia a un hub económico (en este caso, Madrid)?
Regional: ¿Existen diferencias estructurales entre el norte, el centro y el sur de España?
La ingeniería de variables consiste precisamente en traducir esas hipótesis en columnas calculadas que el resto del análisis pueda utilizar.
El enfoque: cada variable, una historia testable
Una buena variable debe contar una historia clara. No basta con calcular un número: hay que poder explicar qué pregunta intenta responder. En nuestro caso:
es_fin_semana (0/1): ¿cambia el precio el sábado y el domingo?
distancia_a_madrid (km): ¿se encarece el combustible al alejarse del hub logístico?
region (norte/centro/sur): ¿hay brechas estructurales entre regiones?
Cada una de estas tres variables es, en realidad, una pregunta empírica disfrazada de columna. Si la variable no explica nada cuando la cruzamos con el precio, simplemente la descartamos.
El código resultante
Implementamos las tres variables en una única función. La más interesante técnicamente es la distancia a Madrid, que requiere la fórmula de Haversine para calcular distancias sobre la superficie terrestre teniendo en cuenta la curvatura del planeta:
from math import radians, cos, sin, asin, sqrt
def crear_features_carburantes(df):
# Variable temporal
df['es_fin_semana'] = (
df['fecha'].dt.dayofweek.isin([5, 6]).astype(int)
)
# Variable geográfica: distancia haversine a Madrid
madrid_lat, madrid_lon = 40.4168, -3.7038
def haversine(lat, lon):
lat, lon = radians(lat), radians(lon)
m_lat, m_lon = radians(madrid_lat), radians(madrid_lon)
dlat = lat - m_lat
dlon = lon - m_lon
a = sin(dlat/2)**2 + cos(m_lat) * cos(lat) * sin(dlon/2)**2
return 6371 * 2 * asin(sqrt(a)) # radio de la Tierra en km
df['distancia_a_madrid'] = df.apply(
lambda r: haversine(r['latitud'], r['longitud']), axis=1
)
# Variable regional
def region(lat):
if lat >= 42: return 'Norte'
if lat >= 39: return 'Centro'
return 'Sur'
df['region'] = df['latitud'].apply(region)
return dfReflexión: proponer variables con argumento, no solo con código
En esta fase la IA aporta un valor especialmente alto, pero no en lo que se podría pensar a primera vista. Lo verdaderamente útil no es que escriba la fórmula de Haversine —cualquier referencia técnica la contiene—, sino que proponga variables candidatas con argumentación detrás. Cuando le preguntamos "¿qué features podrían capturar la variación de precios?", la propuesta vino acompañada de razonamiento: Madrid se sugirió como hub porque es el mercado más eficiente y estable, y por tanto las desviaciones respecto a su precio funcionan como aproximación a la fricción logística.
Ese razonamiento es lo valioso: no la fórmula, sino la justificación. Trial-and-error puro habría llevado tres o cuatro horas explorando variables hasta encontrar las útiles; con la iteración asistida, llegamos a un conjunto razonado en aproximadamente cuarenta y cinco minutos.
Fase 5: análisis de impacto de las variables
El reto: cuantificar la contribución real
Construir variables es una cosa; demostrar que realmente explican algo es otra. En esta última fase del análisis evaluamos el impacto efectivo de cada una de las tres variables creadas, combinando dos enfoques: una medida numérica (correlación o diferencia de medias) y una representación visual que permita interpretar el resultado de un vistazo.
El enfoque: dos enfoques complementarios
Para cada variable, calculamos:
Una medida numérica que cuantifica el efecto (correlación de Pearson para variables continuas; diferencia de medias para categóricas).
Una representación visual que permite interpretar la magnitud del efecto y detectar relaciones no lineales.
El cruce de ambos enfoques es lo que da fiabilidad al resultado. Una correlación alta sin una visualización que la respalde puede ser engañosa (por ejemplo, si está dominada por outliers); una visualización sugestiva sin métrica puede llevar a sobreinterpretación.
El código resultante
Como ejemplo, mostramos el análisis de impacto de la distancia a Madrid. Primero calculamos la correlación, después segmentamos en cuartiles para hacer la relación visualmente interpretable:
# Medida numérica
correlacion = df['distancia_a_madrid'].corr(df['precio'])
print(f"Correlación (distancia a Madrid → precio): {correlacion:.3f}")
# Representación visual por cuartiles de distancia
df['cuartil_distancia'] = pd.qcut(
df['distancia_a_madrid'], q=4,
labels=['Q1 (cercano)', 'Q2', 'Q3', 'Q4 (lejano)']
)
precio_por_cuartil = df.groupby('cuartil_distancia')['precio'].mean()
fig, ax = plt.subplots(figsize=(10, 5))
precio_por_cuartil.plot(kind='bar', ax=ax, color='#2ecc71')
ax.set_title('Impacto geográfico: precio medio por cuartiles de distancia a Madrid')
ax.set_ylabel('Precio medio (€/litro)')
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()El patrón emergente del análisis completo —comparando las tres variables— es que la distancia a Madrid es la más explicativa, seguida por la región, y por último por el efecto fin de semana, que en nuestro periodo de estudio resulta ser marginal. En conjunto, las tres variables explican aproximadamente el 60-70% de la variación de precios; el resto depende de factores como la marca específica, el tipo de estación (autopista, urbana, rural) y eventos puntuales del mercado.
Reflexión: no todas las variables impactan por igual
Una de las virtudes de este análisis estructurado es que revela cuáles de nuestras hipótesis iniciales se sostienen y cuáles no. En este caso, la hipótesis temporal (fin de semana) resultó ser mucho más débil de lo esperado, mientras que la hipótesis geográfica se confirmó con claridad. Sin este paso de cuantificación, habríamos podido seguir asumiendo que todas las variables aportan información valiosa.
Síntesis: las lecciones técnicas que nos llevamos
A lo largo de las cinco fases anteriores hemos ido acumulando soluciones a problemas concretos. La siguiente tabla resume las más reutilizables; cada una está documentada con mayor detalle en el directorio prompts del repositorio:
Fase
Problema
Solución
Reutilizable en
Ingesta
Bloqueos SSL o de IP en APIs
Triple respaldo: request -> curl -> demo
Cualquier API pública
Ingesta
Documentación inconsistente
Validación de estructura + manejo de errores
APIs gubernamentales
Limpieza
Variantes textuales en marcas
.st.upper().str.trip() antes de agrupar
Cualquier agregación categórica
Limpieza
Coordenadas fuera de España
Bounding box [27.5-43.8, -18.2- 4.4]
Análisis geográficos en España
Limpieza
Rangos comprimidos en gráficos
ax.set_xlim(min*0.95, max*1.05)
Visualización con rangos estrechos
EDA
Elección de tipo de gráfico
Mapeo explícito pregunta -> gráfico
Cualquier EDA
Features
Variables sin justificación
Cada feature responde una hipótesis testable
Feature engineering en general
Análisis
Impacto no cuantificado
Métrica + visualización en paralelo
Cualquier análisis de impacto
Figura 3. Tabla resumen de soluciones a problemas concretos. Fuente: elaboración propia - datos.gob.es
Reflexión final: qué hace que la IA sea un buen copiloto
Al cabo del ejercicio, podemos extraer algunas conclusiones generales sobre el uso de IA generativa como apoyo al análisis de datos. Las dividimos en dos planos: dónde aporta valor, y dónde no debe sustituir al criterio humano.
Donde la IA aporta valor de forma clara:
Iteración rápida. El ciclo "describir problema – obtener solución – validar" se reduce de horas a minutos. Esto cambia cualitativamente la dinámica de trabajo: nos permite probar ideas que de otro modo descartaríamos por coste.
Pensamiento lateral. La IA propone alternativas que un analista podría pasar por alto, como la idea de usar curl cuando requests falla. No siempre acierta, pero sí amplía el espacio de soluciones consideradas.
Documentación articulada. La IA es especialmente buena explicando el porqué de una decisión técnica, no solo el qué. Esto facilita que el código resultante sea legible para personas no técnicas.
Donde el criterio humano sigue siendo imprescindible:
Conocimiento de dominio. La IA no sabe que CEPSA y MOEVE son la misma marca, ni que Canarias tiene un sobrecoste logístico estructural. Esa información debe aportarla el analista.
Validación estadística. La IA puede sugerir modelos, pero la validez estadística del análisis es responsabilidad humana.
Lectura de gráficos. La IA no ve sus propias visualizaciones. El juicio sobre si una gráfica es legible, comunica lo que se pretende y respeta buenas prácticas visuales sigue siendo humano.
Decisiones de negocio. Qué preguntar a los datos, qué considerar relevante, cómo comunicar los resultados a la organización: son decisiones que la IA puede apoyar, pero no sustituir.
En síntesis, la idea que resume mejor nuestra experiencia es la siguiente: la IA generativa funciona mejor cuando piensa con nosotros que cuando piensa por nosotros. El ejercicio que aquí presentamos no fue "pedir a Claude que hiciera el análisis", sino mantener una conversación estructurada en la que la IA proponía, el analista cuestionaba, la IA refinaba y el analista validaba. El resultado de esa conversación es un análisis más robusto, mejor documentado y más reutilizable que el que habríamos producido en solitario.
Cómo aprovechar este repositorio
El código completo, los prompts y la documentación están disponibles en el repositorio público del proyecto. Distintos perfiles pueden aprovecharlo de formas distintas:
Si estudias análisis de datos: abre directamente el notebook en Google Colab y recorre cada celda en orden. Para cada visualización, consulta el prompt correspondiente en prompts/visualizacion/.
Si trabajas como científico de datos: revisa specs/001-carburantes-ia/plan.md, donde están documentadas las decisiones arquitectónicas y las lecciones aprendidas. Los snippets de prompts/ son reutilizables tal cual en otros proyectos.
Si te interesa la metodología de prompt engineering: el patrón "describe – cuestiona – refina – valida" está documentado caso por caso a lo largo de los prompts. Es replicable en cualquier dominio: finanzas, salud, marketing o cualquier análisis de datos abiertos.
Conclusión
El ejercicio que hemos presentado muestra que la IA generativa, utilizada con criterio, puede acelerar de manera notable el análisis de datos abiertos sin sacrificar rigor metodológico. Las cinco fases recorridas —ingesta, limpieza, exploración, ingeniería de variables y análisis de impacto— siguen siendo las mismas que en un flujo tradicional, pero la dinámica de trabajo cambia: pasamos de escribir código a describir intenciones y validar resultados.
Contenido elaborado por Alejandro Alija, experto en Transformación Digital e Innovación. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor

Ciencia e tecnoloxía
Introducción
Cada año se producen en España decenas de miles de accidentes, en los que miles de personas resultan heridas de diversa consideración, y que ocurren en circunstancias muy diversas, tanto de tipo de vía, como por el tipo de accidente.
Muchas de las estadísticas relacionadas con estos parámetros están recogidas en las bases de datos de la Dirección General de Tráfico (DGT) y algunas de ellas en el catálogo albergado en datos.gob.es.
En este ejercicio examinaremos el contenido de la base de datos de siniestralidad de la DGT para el año 2024 con el fin de realizar una serie de visualizaciones básicas que nos permitan ver de forma rápida e intuitiva cuáles son los hechos a destacar respecto a la incidencia de accidentes y sus consecuencias en ese año.
Para ello vamos a desarrollar código en Python que nos permita la lectura y cálculo de métricas básicas respecto al número total de víctimas, las particularidades de las infraestructuras así como las diferentes casuísticas de los accidentes. Y una vez tengamos disponibles esos datos, los visualizaremos utilizando la librería de Javascript D3.js, que nos permite tanto la representación de datos en su forma más tradicional como en diseños más contemporáneos, habituales en la prensa, favoreciendo así una narrativa fluída en estilo y coherente en contenido.
En el entorno de Python utilizaremos librerías de uso común y frecuente como son Numpy, para el cálculo básico - sumas, máximos y mínimos-, y Pandas, para estructurar los datos de forma intuitiva, facilitando tanto su organización como su transformación. Igualmente trabajaremos con Datetime, tanto para el formateo de los datos de entrada en tipos de fecha estándares dentro del mundo de la programación en Python, como para agregar los datos de forma fácil e intuitiva. De esta forma aprenderemos a abrir cualquier tipo de fichero de datos en formato .CSV, a estructurarlo de forma ordenada y a realizar transformaciones y operaciones básicas de forma sencilla.
En el entorno de Javascript desarrollaremos notebooks en D3.js gracias al uso de Observable, una iniciativa abierta y gratuita, para poder ejecutar código de Javascript directamente en un interfaz web, y sin tener que recurrir a servidores locales o complejas instalaciones. En diferentes notebooks crearemos visualizaciones clásicas -como las series temporales en ejes cartesianos o mapas- junto con otras propuestas tales como distribuciones de burbujas o elementos apilados por categorías.
En la Figura 1 se pueden ver las principales etapas de este ejercicio, desde la lectura de los datos dentro del fichero de la DGT, hasta las operaciones y las variables de salida en formato JSON, que nos servirán a su vez en un entorno Javascript para poder desarrollar las visualizaciones en D3.js.
Figura 1. Pasos en los cuales se estructura este ejercicio, con punto de partida en la base de datos de la DGT, el procesado y manipulación de esos datos en Python, la creación de ficheros de salida en formato JSON y su uso en Javascript para visualizar los resultados.
El acceso al repositorio de Github, el notebook de Google Colab y los notebooks de Observable se pueden realizar a través de los siguientes enlaces:
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Accede a los notebooks de Observable
Proceso de Desarrollo
1. Lectura del fichero de datos
El primer paso será leer el fichero de la DGT que contiene todos los registros de accidentes del año 2024. Este paso nos permitirá identificar los campos de interés y sobre todo en qué formato se encuentran. Podremos identificar si se precisa de alguna transformación sobre todo en la información de la fecha, tal y como está estructurada en el fichero de origen.
Igualmente veremos cómo traducir los códigos de muchas de las categorías que nos ofrece la DGT, de modo que podamos hacer una interpretación real más allá de los números de categorías como tipo de accidente, tipo de vía o titularidad de la vía.
Una vez entendemos la estructura y contenido de los datos podemos empezar a operar con ellos.
2. Cálculo de métricas
La librería Pandas de Python nos permite operar con las diferentes columnas de datos y realizar cálculos básicos que serán suficientemente representativos para entender mínimamente la casuística de los accidentes en las carreteras españolas.
En este apartado se realizarán tres tipos de cálculos.
El primero de ellos será el cálculo del número total de víctimas por hora del día para cada uno de los días de la semana. La base de datos de la DGT viene estructurada por día de la semana, de forma que utilizaremos también esa escala temporal para representar los datos en una serie. Cabe hacer notar que por víctima se considera toda aquella persona que ha fallecido o que sea diagnosticada como herida grave o leve.
El segundo cálculo será la suma total de accidentes para diferentes categorías, tales como la titularidad de la vía, el tipo de accidente o el tipo de vía. Esto nos permitirá ver cuáles son las condiciones en las cuales los accidentes son más frecuentes.
El tercer cálculo será el de número de accidentes por municipio. En este caso realizaremos el cálculo restringido a la provincia de Valencia como ejemplo, y que sería aplicable a cualquier provincia o municipio de nuestro interés. En este caso observaremos las diferencias entre los núcleos urbanos y no urbanos, así como aquellos municipios por los que pasan las principales vías de comunicación.
3. Diseño de las visualizaciones
Una vez hemos calculado las métricas de interés, desarrollaremos cinco ejercicios de visualización en D3.js. Para ello exportaremos en formato JSON el resultado de las métricas y crearemos notebooks en Observable. En concreto realizamos las siguientes visualizaciones:
Serie temporal con el número total de víctimas en cada hora y día de la semana, con un menú desplegable interactivo para seleccionar el día de la semana de interés. A mayores de la curva que describe el número de víctimas dibujaremos sobre el fondo de la gráfica la incertidumbre de todos los días de la semana, de forma que la serie temporal diaria queda enmarcada en el contexto de toda la semana como referencia.
Mapa de la provincia de Valencia con el número total de accidentes por municipio.
Diagrama de burbujas, con las diferentes magnitudes de los diferentes tipos de accidentes con el número total de accidentes en cada caso escrita de forma detallada.
Diagrama de puntos apilados, donde acumulamos círculos o cualquier otra forma geométrica para las diferentes titularidades de la vía y su número total de accidentes dentro del marco de cada titularidad.
Diagrama de sierra, con la altura de cada montaña correspondiente al número de accidentes en cada tipo de vía en escala logarítmica.
Visualización de las métricas
El resultado de este ejercicio se podrá ver de forma gráfica y explícita en forma de visualizaciones realizadas para el formato web y accesibles desde una interfaz también web, tanto para su desarrollo como para su posterior publicación. Todo el conjunto de visualizaciones se encuentra en el repositorio de Datos.gob.es en Observable:
Accede a los notebooks de Observable
En la Figura 2 tenemos el resultado de la serie temporal del total de víctimas respecto a la hora del día para diferentes días de la semana. La serie temporal está enmarcada dentro de la incertidumbre del total de días de la semana, para dar una idea del margen de variabilidad que podemos tener dependiendo de la hora del día.
Figura 2. Serie temporal del total de víctimas en accidentes por hora del día para todos los días de la semana en 2024. En el fondo en color azul claro se indica la incertidumbre asociada a todos los días de la semana como contexto, con menú desplegable para seleccionar el día de la semana.
En la Figura 3 podemos observar el mapa de la provincia de Valencia con una intensidad de color proporcional al número de accidentes en cada municipio. Aquellos municipios en los cuales no se han registrado accidentes aparecen en color blanco. De forma intuitiva se puede adivinar el trazado de las principales carreteras que atraviesan la provincia, tanto la carretera hacia el este de la ciudad de Valencia en dirección Madrid como la carretera del interior hacia el sur de la ciudad en dirección a Alicante.
Figura 3. Mapa del número de accidentes por municipio en la provincia de Valencia en 2024.
En la Figura 4 vemos una forma geométrica, el círculo, asociada a los tipos de accidente, con el detalle del número de accidentes asociada a cada categoría. En este tipo de visualización emerge de forma natural aquellos accidentes más frecuentes en torno al centro del diagrama, mientras que aquellos minoritarios o residuales ocupan el perímetro del diagrama para dar igualmente una forma redonda al conjunto de formas.
Figura 4. Diagrama de burbujas del número de accidentes por tipo de accidente en 2024.
En la Figura 5 se puede contemplar el tradicional diagrama de barras pero esta vez descompuesto en unidades más pequeñas, para afinar la cantidad de accidentes asociada a la titularidad de la vía donde han sucedido. Este tipo de diagramas permite discernir pequeñas diferencias entre magnitudes parecidas, preservando el mensaje general que obtenemos de un cálculo de estas características.
Figura 5. Diagrama de barras con discretización de puntos para el número de accidentes por titularidad de la vía en el 2024.
En la Figura 6 creamos una serie de formas geométricas que replican una cordillera o sierra donde los diferentes picos apuntan a la diferencia de número de accidentes por tipo de vía. Dada la diferencia en órdenes de magnitud establecemos una escala logarítmica, que permita comparar en el mismo diagrama diferentes casuísticas.
Figura 6. Diagrama en cordillera para los diferentes órdenes de magnitud del número de accidentes por tipo de vía en el 2024.
Lecciones aprendidas
A través de estos pasos aprenderemos toda una serie de habilidades transversales que nos permiten trabajar con aquellos conjunto de datos que se nos presentan en formato CSV en columnas, un formato muy popular para el cual podremos realizar tanto su análisis como su visualización. Estas lecciones son en concreto:
Universalidad de lectura y estructuración de datos: el uso de herramientas como Python, con sus librerías Numpy y Pandas, permiten acceder a los datos en detalle y estructurarlos de forma ordenada e intuitiva con pocas líneas de código.
Cálculos sencillos en Pandas: la propia librería de Python permite cálculos sencillos pero esenciales para la interpretación preliminar de resultados.
Formato Datetime: a través de esta librería de Python podemos familiarizarnos con el estándar del formato de fecha, y así realizar todo tipo de transformaciones, filtros y selecciones que más nos interesen en cualquier intervalo temporal.
Formato JSON: una vez que decidimos dar espacio a nuestras visualizaciones en la web, aprender la estructura y uso del formato JSON es de gran utilidad dado su amplio uso en todo tipo de aplicaciones y arquitecturas web.
Espectro de posibilidades de D3.js: esta librería de Javascript nos permite explorar de lo más tradicional y conservador a lo más creativo gracias a sus principios basados en las formas más básicas, sin plantillas, templates o diagramas predefinidos.
Conclusiones y próximos pasos
Hemos aprendido a leer y a estructurar datos según los estándares de los formatos más utilizados en el mundo del análisis y visualización. Este ejercicio también sirve como módulo introductorio al mundo de D3.js, una herramienta muy versátil, vigente y popular dentro del mundo del storytelling y la visualización de datos a todos los niveles.
Para poder avanzar en este ejercicio se recomienda:
Para los analistas y desarrolladores, se puede prescindir de la librería Pandas y estructurar los datos con objetos más elementales de Python como arrays y matrices, buscando qué funciones y qué operadores permiten realizar las mismas tareas que hace Pandas pero de una forma más fundamental, sobre todo si pensamos en entornos de producción para los cuales necesitamos el menor número de librerías posibles para aligerar la aplicación.
Para los creadores de visualizaciones, la información sobre los municipios puede proyectarse igualmente sobre bases cartográficas ya existentes como OpenStreetMap y de esta forma vincular la incidencia de accidentes a características orográficas o infraestructuras ya reflejadas en esas bases cartográficas. Para las magnitudes de los números de accidentes se pueden explorar diagramas de tipo Treemap o diagramas de Voronoi y ver si transmiten el mismo mensaje que los que presentamos en este ejercicio.
Ámbitos de aplicación
Los pasos descritos en este ejercicio pueden pasar a formar parte de cualquier caja de herramientas de uso habitual para los siguientes perfiles:
Analistas de datos: aquí se encuentran los pasos básicos para la descripción de un fichero de datos en formato CSV y los cálculos básicos a realizar tanto en el campo de la fecha como de operaciones entre variables de diferentes columnas. Estas herramientas pueden servir para introducirse en el mundo del análisis de datos y ayuda en esos primeros pasos a la hora de enfrentarse a un dataset.
Científicos y personal investigador: la universalidad de las herramientas aquí descritas aplican a una gran variedad de origen de datos, como el que se experimenta en las ciencias experimentales y de observaciones o medidas de todo tipo. Estas herramientas permiten un análisis rápido a la vez que riguroso sin importar el campo de conocimiento en el que se trabaje.
Desarrolladores web: la exportación de datos en formato JSON así como el código en Javascript que se ofrece en los notebooks de Observable son fácilmente integrables en todo tipo de entornos (Svelte, React, Angular, Vue) y permite la creación de visualizaciones en una web de forma sencilla e intuitiva.
Periodistas: abarcar todo el proceso de vida de un fichero de datos, desde su lectura a su visualización, otorga al periodista o investigador independencia a la hora de evaluar e interpretar los datos por sí mismo sin depender de recursos técnicos ajenos. La creación del mapa por municipios abre la puerta a utilizar cualquier otro dato similar, como por ejemplo procesos electorales, con el mismo formato de salida para mostrar variabilidad geográfica respecto a cualquier tipo de magnitud.
Diseñadores Gráficos: el manejo de herramientas de visualización con un amplio grado de libertad permite a los diseñadores cultivar toda su creatividad dentro del rigor y la exactitud que los datos necesitan.
Ciencia e tecnoloxía
Los agentes de IA (como los de Google ADK, LangChain, etc.) son "cerebros". Pero un cerebro sin "manos" no puede actuar en el mundo real (consultar APIs, buscar en bases de datos, etc.). Esas "manos" son las herramientas.
El desafío es: ¿cómo conectas el cerebro con las manos de forma estándar, desacoplada y escalable? La respuesta es el Model Context Protocol (MCP).
Como ejercicio práctico, construiremos un sistema de agente conversacional que permite explorar el Catálogo Nacional de datos abiertos albergado en datos.gob.es mediante preguntas en lenguaje natural, facilitando así el acceso a datos públicos.
En este ejercicio práctico, el objetivo principal es ilustrar, paso a paso, cómo construir un servidor de herramientas independiente que hable el protocolo MCP.
Para hacer este ejercicio tangible y no solo teórico, usaremos, FastMCP para construir el servidor. Para probar que nuestro servidor funciona, crearemos un agente simple con Google ADK que lo consuma. El caso de uso (consultar la API de datos.gob.es) ilustra esta conexión entre herramientas y agentes. El verdadero aprendizaje es la arquitectura, que podrías reutilizar para cualquier API o base de datos.
A continuación se muestran las tecnologías que usaremos y un esquema de cómo están realizados entre sí los diferentes componentes
FastMCP (mcp.server.fastmcp): implementación ligera del protocolo MCP que permite crear servidores de herramientas con muy poco código mediante decoradores Python. Es el 'protagonista' del ejercicio.
Google ADK (Agent Development Kit): framework para definir el agente de IA, su prompt y conectarlo a las herramientas. Es el 'cliente' que prueba nuestro servidor.
FastAPI: para servir el agente como una API REST con interfaz web interactiva.
httpx: para realizar llamadas asíncronas a la API externa de datos.gob.es.
Docker y Docker Compose: para paquetizar y orquestar los dos microservicios, permitiendo que se ejecuten y comuniquen de forma aislada.
Figura 1. Arquitectura desacoplada con comunicación MCP.
El diagrama ilustra una arquitectura desacoplada dividida en cuatro componentes principales que se comunican mediante el protocolo MCP. Cuando el usuario realiza una consulta en lenguaje natural, el Agente ADK (basado en Google Gemini) procesa la intención y se comunica con el servidor MCP a través del Protocolo MCP, que actúa como intermediario estandarizado. El servidor MCP expone cuatro herramientas especializadas (buscar datasets, listar temáticas, buscar por temática y obtener detalles) que encapsulan toda la lógica de negocio para interactuar con la API externa de datos.gob.es. Una vez que las herramientas ejecutan las consultas necesarias y reciben los datos del catálogo nacional, el resultado se propaga de vuelta al agente, que finalmente genera una respuesta comprensible para el usuario, completando así el ciclo de comunicación entre el "cerebro" (agente) y las "manos" (herramientas).
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
La arquitectura: servidor MCP y agente consumidor
La clave de este ejercicio es entender la relación cliente-servidor:
El Servidor (Backend): es el protagonista de este ejercicio. Su único trabajo es definir la lógica de negocio (las "herramientas") y exponerlas al mundo exterior usando el "contrato" estándar de MCP. Es el responsable de encapsular toda la lógica de comunicación con la API de datos.gob.es.
El Agente (Frontend): es el "cliente" o "consumidor" de nuestro servidor. Su rol en este ejercicio es probar que nuestro servidor MCP funciona. Lo usamos para conectarnos, descubrir las herramientas que el servidor ofrece y llamarlas.
El Protocolo MCP: es el "lenguaje" o "contrato" que permite que el agente y el servidor se entiendan sin necesidad de conocer los detalles internos del otro.
Proceso de desarrollo
El núcleo del ejercicio se divide en tres partes: crear el servidor, crear un cliente para probarlo y ejecutarlos.
1. El servidor de herramientas (el backend con MCP)
Aquí es donde reside la lógica de negocio y el foco de este tutorial. En el archivo principal (server.py), definimos funciones Python simples y usamos el decorador @mcp.tool de FastMCP para exponerlas como 'herramientas' consumibles.
La description que añadimos al decorador es crucial, ya que es la documentación que cualquier cliente MCP (incluyendo nuestro agente ADK) leerá para saber cuándo y cómo usar cada herramienta.
Las herramientas que definiremos en el ejercicio son:
buscar_datasets(titulo: str): para buscar datasets por palabras clave en el título.
listar_tematicas(): para descubrir qué categorías de datos existen.
buscar_por_tematica(tematica_id: str): para encontrar datasets de un tema específico.
obtener_detalle_dataset(dataset_id: str): para obtener la información completa de un dataset.
2. El agente consumidor (el frontend con Google ADK)
Una vez construido nuestro servidor MCP, necesitamos una forma de probarlo. Aquí es donde entra Google ADK. Lo usamos para crear un "agente consumidor" simple.
La magia de la conexión ocurre en el argumento tools. En lugar de definir las herramientas localmente, simplemente le pasamos la URL de nuestro servidor MCP. El agente, al iniciarse, consultará esa URL, leerá el "contrato" MCP y sabrá automáticamente qué herramientas tiene disponibles y cómo usarlas.
# Ejemplo de configuración en agent.py
root_agent = LlmAgent(
...
instruction="Eres un asistente especializado en datos.gob.es...",
tools=[
MCPToolset(
connection_params=StreamableHTTPConnectionParams(
url="http://mcp-server:8000/mcp",
),
)
]
)3. Orquestación con Docker Compose
Finalmente, para ejecutar nuestro Servidor MCP y el agente consumidor juntos, usamos docker-compose.yml. Docker Compose se encarga de construir las imágenes de cada servicio, crear una red privada para que se comuniquen (por eso el agente puede llamar a http://mcp-server:8000) y exponer los puertos necesarios.
Probando el servidor MCP en acción
Una vez que ejecutamos docker-compose up --build, podemos acceder a la interfaz web del agente (http://localhost:8080).
El objetivo de esta prueba no es solo ver si el bot responde bien, sino verificar que nuestro servidor MCP funciona correctamente y que el agente ADK (nuestro cliente de prueba) puede descubrir y usar las herramientas que este expone.
Figura 2. Pantalla del agente demostrando sus herramientas.
El verdadero poder del desacoplamiento se ve cuando el agente encadena lógicamente las herramientas que nuestro servidor le proveyó.
Figura 3. Pantalla del agente demostrando el uso conjunto de las herramientas.
¿Qué puedes aprender?
El objetivo de este ejercicio es aprender los fundamentos de una arquitectura de agentes moderna, centrándonos en el servidor de herramientas. En concreto:
Cómo construir un servidor MCP: cómo crear un servidor de herramientas desde cero que hable MCP, usando decoradores como @mcp.tool.
El patrón de una arquitectura desacoplada: el patrón fundamental de separar el 'cerebro' (LLM) de las 'herramientas' (lógica de negocio).
Descubrimiento dinámico de herramientas: cómo un agente (en este caso, de ADK) puede conectarse dinámicamente a un servidor MCP para descubrir y consumir herramientas.
Integración de API externas: el proceso de 'envolver' una API compleja (como la de datos.gob.es) en funciones simples dentro de un servidor de herramientas.
Orquestación con Docker: cómo gestionar un proyecto de microservicios para desarrollo.
Conclusiones y futuro
Hemos construido un servidor de herramientas MCP robusto y funcional. El verdadero valor de este ejercicio es el cómo: una arquitectura escalable centrada en un servidor de herramientas que habla un protocolo estándar.
Esta arquitectura basada en MCP es increíblemente flexible. El caso de datos.gob.es es solo un ejemplo. Podríamos fácilmente:
Cambiar el caso de uso: reemplazar el server.py por uno que conecte a una base de datos interna o a la API de Spotify, y cualquier agente que hable MCP (no solo ADK) podría consumirlo.
Cambiar el "cerebro": cambiar el agente ADK por un agente de LangChain o cualquier otro cliente MCP, y nuestro servidor de herramientas seguiría funcionando sin cambios.
Para aquellos interesados en llevar este análisis al siguiente nivel, las posibilidades se centran en mejorar el servidor MCP:
Implementar más herramientas: añadir filtros por formato, publicador o fecha al servidor MCP.
Integrar caché: usar Redis en el servidor MCP para cachear las respuestas de la API y mejorar la velocidad.
Añadir persistencia: guardar el historial de chat en una base de datos (esto sí sería en el lado del agente).
Más allá de estas mejoras técnicas, esta arquitectura abre la puerta a múltiples aplicaciones en contextos muy diversos.
Periodistas y académicos pueden disponer de asistentes de investigación que les ayuden a descubrir conjuntos de datos relevantes en segundos.
Organizaciones de transparencia pueden construir herramientas de monitorización que detecten automáticamente nuevas publicaciones de datos de contratación pública o presupuestos.
Consultoras y equipos de inteligencia de negocio pueden desarrollar sistemas que crucen información de múltiples fuentes gubernamentales para elaborar informes sectoriales.
Incluso en el ámbito educativo, esta arquitectura sirve como base didáctica para enseñar conceptos avanzados de programación asíncrona, integración de API y diseño de agentes de IA.
El patrón que hemos construido —un servidor de herramientas desacoplado que habla un protocolo estándar— es la base sobre la que puedes desarrollar soluciones adaptadas a tus necesidades específicas, independientemente del dominio o la fuente de datos con la que trabajes.
Ciencia e tecnoloxía
En el ecosistema del sector público, las subvenciones representan uno de los mecanismos más importantes para impulsar proyectos, empresas y actividades de interés general. Sin embargo, entender cómo se distribuyen estos fondos, qué organismos convocan ayudas más voluminosas o cómo varía el presupuesto según la región o los beneficiarios no es trivial cuando se trabaja con cientos de miles de registros.
En esta línea, presentamos un nuevo ejercicio práctico de la serie “Ejercicios de datos paso a paso”, en el que aprenderemos a explorar y modelar datos abiertos utilizando Apache Spark, una de las plataformas más extendidas para el procesamiento distribuido y el machine learning a gran escala.
En este laboratorio trabajaremos con datos reales del Sistema Nacional de Publicidad de Subvenciones y Ayudas Públicas (BDNS) y construiremos un modelo capaz de predecir el rango de presupuesto de nuevas convocatorias en función de sus características principales.
Todo el código utilizado está disponible en el correspondiente repositorio de GitHub para que puedas ejecutarlo, entenderlo y adaptarlo a tus propios proyectos.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Contexto: ¿por qué analizar las subvenciones públicas?
La BDNS recoge información detallada sobre cientos de miles de convocatorias publicadas por distintas administraciones españolas: desde ministerios y consejerías autonómicas hasta diputaciones y ayuntamientos. Este conjunto de datos es una fuente extraordinariamente valiosa para:
analizar la evolución del gasto público,
entender qué organismos son más activos en ciertas áreas,
identificar patrones en los tipos de beneficiarios,
y estudiar la distribución presupuestaria según sector o territorio.
En nuestro caso, utilizaremos el dataset para abordar una pregunta muy concreta, pero de gran interés práctico:
¿Podemos predecir el rango de presupuesto de una convocatoria a partir de sus características administrativas?
Esta capacidad facilitaría tareas de clasificación inicial, apoyo a la toma de decisiones o análisis comparativos dentro de una administración pública.
Objetivo del ejercicio
El objetivo del laboratorio es doble:
Aprender a manejar Spark de forma práctica:
Cargar un dataset real de gran volumen
Realizar transformaciones y limpieza
Manipular columnas categóricas y numéricas
Estructurar un pipeline de machine learning
2. Construir un modelo predictivo
Entrenaremos un clasificador capaz de estimar si una convocatoria pertenece a uno de estos rangos de presupuesto bajo (hasta 20 k€), medio (entre 20 y 150k€) o alto (superior a 150k€), basándonos para ello en variables como:
Organismo concedente
Comunidad Autónoma
Tipo de beneficiario
Año de publicación
Descripciones administrativas
Recursos utilizados
Para completar este ejercicio empleamos:
Herramientas analíticas
Python, lenguaje principal del proyecto
Google Colab, para ejecutar Spark y crear Notebooks de forma sencilla
PySpark, para el procesamiento de datos en las etapas de limpieza y modelado
Pandas, para pequeñas operaciones auxiliares
Plotly, para algunas visualizaciones interactivas
Datos
Dataset oficial del Sistema Nacional de Publicidad de Subvenciones (BDNS), descargado desde el portal de subvenciones del Ministerio de Hacienda.
Los datos utilizados en este ejercicio fueron descargados el 28 de agosto de 2025. La reutilización de los datos del Sistema Nacional de Publicidad de Subvenciones y Ayudas Públicas está sujeta a las condiciones legales recogidas en https://www.infosubvenciones.es/bdnstrans/GE/es/avisolegal.
Desarrollo del ejercicio
El proyecto se divide en varias fases, siguiendo el flujo natural de un caso real de data science.
5.1. Volcado y transformación de datos
En este primer apartado vamos a descargar automáticamente el dataset de subvenciones desde la API del portal del Sistema Nacional de Publicidad de Subvenciones (BDNS). Posteriormente transformaremos los datos a un formato optimizado como Parquet (formato de datos columnar) para facilitar su exploración y análisis.
En este proceso utilizaremos algunos conceptos complejos, como:
Funciones asíncronas: permite procesar en paralelo dos o más operaciones independientes, lo que facilita hacer más eficiente el proceso.
Escritor rotativo: cuando se supera un límite de cantidad de información el fichero que se está procesando se cierra y se abre uno nuevo con un índice autoincremental (a continuación del anterior). Esto evita procesar ficheros demasiado grandes y mejora la eficiencia.
Figura 1. Captura de la API del Sistema Nacional de Publicidad de Subvenciones y Ayudas Públicas
5.2. Análisis exploratorio
El objetivo de esta fase es obtener una primera idea de las características de los datos y de su calidad.
Analizaremos entre otros, aspectos como:
Qué tipos de subvenciones tienen mayor número de convocatorias.
Figura 2. Tipos de subvenciones con mayor número de convocatorias.
Cuál es la distribución de las subvenciones en función de su finalidad (i.e. Cultura, Educación, Fomento del empleo…).
Figura 3. Distribución de las subvenciones en función de su finalidad.
Qué finalidades agregan un mayor volumen presupuestario.
Figura 4. Finalidades con mayor volumen presupuestario.
5.3. Modelado: construcción del clasificador de presupuesto
Llegados a este punto, entramos en la parte más analítica del ejercicio: enseñar a una máquina a predecir si una nueva convocatoria tendrá un presupuesto bajo, medio o alto a partir de sus características administrativas. Para conseguirlo, diseñamos un pipeline completo de machine learning en Spark que nos permite transformar los datos, entrenar el modelo y evaluarlo de forma uniforme y reproducible.
Primero preparamos todas las variables —muchas de ellas categóricas, como el órgano convocante— para que el modelo pueda interpretarlas. Después combinamos toda esa información en un único vector que sirve como punto de partida para la fase de aprendizaje.
Con esa base construida, entrenamos un modelo de clasificación que aprende a distinguir patrones sutiles en los datos: qué organismos tienden a publicar convocatorias más voluminosas o cómo influyen elementos administrativos específicos en el tamaño de una ayuda.
Una vez entrenado, analizamos su rendimiento desde distintos ángulos. Evaluamos su capacidad para clasificar correctamente los tres rangos de presupuesto y analizamos su comportamiento mediante métricas como la accuracy o la matriz de confusión.
Figura 5. Métricas accuracy.
Pero no nos quedamos ahí: también estudiamos qué variables han tenido mayor peso en las decisiones del modelo, lo que nos permite entender qué factores parecen más determinantes a la hora de anticipar el presupuesto de una convocatoria.
Figura 6. Variables que han tenido mayor peso en las decisiones del modelo.
Conclusiones del ejercicio
Este laboratorio nos permitirá comprobar cómo Spark simplifica el procesamiento y modelado de datos de gran volumen, especialmente útiles en entornos donde las administraciones generan miles de registros al año, y conocer mejor el sistema de subvenciones tras analizar algunos aspectos clave de la organización de estas convocatorias.
¿Quieres realizar el ejercicio?
Si te interesa profundizar en el uso de Spark y en el análisis avanzado de datos públicos, puedes acceder al repositorio y ejecutar el Notebook completo paso a paso.
Contenido elaborado por Juan Benavente, ingeniero superior industrial y experto en Tecnologías ligadas a la economía del dato. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor.
Ciencia e tecnoloxía
Medio ambiente
En el campo de la ciencia de datos, la capacidad de construir modelos predictivos robustos es fundamental. Sin embargo, un modelo no es solo un conjunto de algoritmos, es una herramienta que debe ser comprendida, validada y, en última instancia, útil para la toma de decisiones.
Gracias a la transparencia y accesibilidad de los datos abiertos, tenemos la oportunidad única de trabajar en este ejercicio con información real, actualizada y de calidad institucional que refleja problemáticas ambientales. Esta democratización del acceso permite no solo desarrollar análisis rigurosos con datos oficiales, sino también contribuir al debate público informado sobre políticas ambientales, creando un puente directo entre la investigación científica y las necesidades sociales.
En este ejercicio práctico, nos sumergiremos en el ciclo de vida completo de un proyecto de modelado, utilizando un caso de estudio real: el análisis de la calidad del aire en Castilla y León. A diferencia de los enfoques que se centran únicamente en la implementación de algoritmos, nuestra metodología se enfoca en:
Carga y exploración inicial de los datos: identificar patrones, anomalías y relaciones subyacentes que guiarán nuestro modelado.
Análisis exploratorio orientado al modelado: construir visualizaciones y realizar ingeniería de características para optimizar el modelado.
Desarrollo y evaluación de modelos de regresión: construir y comparar múltiples modelos iterativos para entender cómo la complejidad afecta el rendimiento.
Aplicación del modelo y conclusiones: utilizar el modelo final para simular escenarios y cuantificar el impacto de posibles políticas ambientales.
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
Arquitectura del Análisis
El núcleo de este ejercicio sigue un flujo estructurado en cuatro fases clave, como se ilustra en la Figura 1. Cada fase se construye sobre la anterior, desde la exploración inicial de los datos hasta la aplicación final del modelo.
Figura 1. Fases del proyecto de modelado predictivo.
Proceso de Desarrollo
1. Carga y exploración inicial de los datos
El primer paso es entender la materia prima de nuestro análisis: los datos. Utilizando un conjunto de datos de calidad del aire de Castilla y León, que abarca 24 años de mediciones, nos enfrentamos a desafíos comunes en el mundo real:
Valores Faltantes: variables como el CO y el PM2.5 tienen una cobertura de datos limitada.
Datos Anómalos: se detectan valores negativos y extremos, probablemente debidos a errores de los sensores.
A través de un proceso de limpieza y transformación, convertimos los datos brutos en un conjunto de datos limpio y estructurado, listo para el modelado.
2. Análisis exploratorio orientado al modelado
Una vez limpios los datos, buscamos patrones. El análisis visual revela una fuerte estacionalidad en los niveles de NO₂, con picos en invierno y valles en verano. Esta observación es crucial y nos lleva a la creación de nuevas variables (ingeniería de características), como componentes cíclicos para los meses, que permiten al modelo "entender" la naturaleza circular de las estaciones.
Figura 2. Variación estacional de los niveles de NO₂ en Castilla y León.
3. Desarrollo y evaluación de modelos de regresión
Con un conocimiento sólido de los datos, procedemos a construir tres modelos de regresión lineal de complejidad creciente:
Modelo Base: utiliza solo los contaminantes como predictores.
Modelo Estacional: añade las variables de tiempo.
Modelo Completo: incluye interacciones y efectos geográficos.
La comparación de estos modelos nos permite cuantificar la mejora en la capacidad predictiva. El Modelo Estacional emerge como la opción óptima, explicando casi el 63% de la variabilidad del NO₂, un resultado notable para datos ambientales.
4. Aplicación del modelo y conclusiones
Finalmente, sometemos el modelo a un riguroso diagnóstico y lo utilizamos para simular el impacto de políticas ambientales. Por ejemplo, nuestro análisis estima que una reducción del 20% en las emisiones de NO podría traducirse en una disminución del 4.8% en los niveles de NO₂.
Figura 3. Rendimiento del modelo estacional. Los valores predichos se alinean bien con los valores reales.
¿Qué puedes aprender?
Este ejercicio práctico te permite aprender:
Ciclo de vida de un proyecto de datos: desde la limpieza hasta la aplicación.
Técnicas de regresión lineal: construcción, interpretación y diagnóstico.
Manejo de datos temporales: captura de estacionalidad y tendencias.
Validación de modelos: técnicas como la validación cruzada y temporal.
Comunicación de resultados: cómo traducir hallazgos en insights accionables.
Conclusiones y Futuro
Este ejercicio demuestra el poder de un enfoque estructurado y riguroso en la ciencia de datos. Hemos transformado un conjunto de datos complejo en un modelo predictivo que no solo es preciso, sino también interpretable y útil.
Para aquellos interesados en llevar este análisis al siguiente nivel, las posibilidades son numerosas:
Incorporación de datos meteorológicos: variables como la temperatura y el viento podrían mejorar significativamente la precisión.
Modelos más avanzados: explorar técnicas como los Modelos Aditivos Generalizados (GAM) u otros algoritmos de machine learning.
Análisis espacial: investigar cómo varían los patrones de contaminación entre diferentes ubicaciones.
En resumen, este ejercicio no solo ilustra la aplicación de técnicas de regresión, sino que también subraya la importancia de un enfoque integral que combine el rigor estadístico con la relevancia práctica.

Ciencia e tecnoloxía
La compartición de datos o data sharing se ha convertido en un pilar imprescindible para el avance de la analítica y el intercambio de conocimiento, tanto en el ámbito privado como en el público. Las organizaciones de cualquier tamaño y sector –empresas, administraciones públicas, instituciones de investigación, comunidades de desarrolladores o individuos– encuentran un fuerte valor en la capacidad de compartir información de forma segura, fiable y eficiente. Este intercambio no se limita a datos en crudo o datasets estructurados; también se extiende a productos de datos más avanzados, tales como modelos de machine learning entrenados, dashboards analíticos, resultados de experimentos científicos y otros artefactos complejos que generan un gran impacto a través de su reutilización.
En este contexto, la importancia de la gobernanza de estos recursos cobra un papel crítico. No es suficiente con disponer de un método para mover ficheros de un sitio a otro; es necesario garantizar aspectos clave como el control de acceso (quién puede leer o modificar cierto recurso), la trazabilidad y la auditoría (saber quién ha accedido, cuándo y con qué finalidad) o el cumplimiento de regulaciones o estándares, especialmente en entornos empresariales y gubernamentales.
Con el fin de unificar estos requisitos, Unity Catalog surge como un almacén de metadatos (metastore) de próxima generación, pensado para centralizar y simplificar la gobernanza de datos y recursos de datos. Originalmente, Unity Catalog formaba parte de los servicios ofrecidos por la plataforma Databricks, pero el proyecto ha dado un salto a la comunidad de código abierto para convertirse en un estándar de referencia. Esto implica que ahora es posible utilizarlo, modificarlo y, en definitiva, contribuir a su evolución desde un entorno libre y colaborativo. Con ello, se espera que más organizaciones adopten sus modelos de catálogo y compartición, impulsando la reutilización de datos y la creación de flujos analíticos e innovaciones tecnológicas.
Fuente: https://docs.unitycatalog.io/
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
Objetivos
En este ejercicio, aprenderemos a configurar Unity Catalog, una herramienta que nos ayuda a organizar y compartir datos en la nube de manera segura. Aunque utilizaremos algo de código, explicaremos cada paso para que incluso personas con poca experiencia en programación puedan seguirlo a través de un laboratorio práctico.
Trabajaremos con un escenario realista donde gestionaremos datos sobre transporte público en diferentes ciudades. Crearemos catálogos de datos, configuraremos una base de datos y aprenderemos a interactuar con la información usando herramientas como Docker, Apache Spark y MLflow.
Nivel de dificultad: Intermedio.
Figura 1. Esquema Unity Catalog
Recursos Necesarios
En esta sección explicaremos los requisitos previos y recursos necesarios para poder desarrollar este laboratorio. El laboratorio está pensado para desarrollarse en un ordenador personal estándar (Windows, MacOS, Linux).
Adicionalmente utilizaremos las siguientes herramientas y entornos de trabajo:
Docker Desktop: Docker es una herramienta que nos permite ejecutar aplicaciones en un entorno aislado llamado contenedor. Un contenedor es como una "caja" que contiene todo lo necesario para que una aplicación funcione correctamente, sin importar el sistema operativo que estés usando.
Visual Studio Code: Nuestro entorno de trabajo será un Notebook Python que ejecutaremos y manipularemos a través del editor de código ampliamente utilizado Visual Studio Code (VS Code).
Unity Catalog: Es una herramienta de gobernanza de datos que permite organizar y controlar el acceso a recursos como tablas, volúmenes de datos, funciones o modelos de machine learning. A lo largo del laboratorio, utilizaremos su versión open source, que puede desplegarse localmente, para aprender a gestionar catálogos de datos con control de permisos, trazabilidad y estructura jerárquica. Unity Catalog actúa como un metastore centralizado, facilitando la colaboración y la reutilización de datos de forma segura.
Amazon Web Services: AWS será el proveedor cloud que utilizaremos para alojar ciertos datos del laboratorio, en concreto los datos en crudo (como archivos JSON) que gestionaremos mediante volúmenes de datos. Aprovecharemos su servicio Amazon S3 para almacenar estos archivos y configuraremos las credenciales y permisos necesarios para que Unity Catalog pueda interactuar con ellos de forma controlada.
Desarrollo del ejercicio
A lo largo del ejercicio, los participantes desplegarán la aplicación, comprenderán su arquitectura e irán construyendo un catálogo de datos paso a paso, aplicando buenas prácticas de organización, control de acceso y trazabilidad.
Despliegue y primeros pasos
Clonamos el repositorio de Unity Catalog y lo levantamos con Docker.
Exploramos su arquitectura: un backend accesible por API y CLI, y una interfaz gráfica intuitiva.
Navegamos por los recursos que gestiona Unity Catalog: catálogos, esquemas, tablas, volúmenes, funciones y modelos.
Figura 2. Captura de pantalla
¿Qué aprenderemos aquí?
Cómo levantar la aplicación, sus componentes principales, y cómo empezar a interactuar con ella desde distintos puntos: web, API y CLI.
Organización de recursos
Configuramos una base de datos MySQL externa como repositorio de metadatos.
Creamos catálogos para representar distintas ciudades y esquemas para distintos servicios públicos.
Figura 3. Captura de pantalla
¿Qué aprenderemos aquí?
Cómo estructurar el gobierno de datos a distintos niveles (ciudad, servicio, dataset) y cómo gestionar los metadatos de forma centralizada y persistente.
Construcción de datos y uso real
Creamos tablas estructuradas para representar rutas, autobuses o paradas.
Cargamos datos reales en estas tablas usando PySpark.Habilitamos un bucket en AWS S3 como almacenamiento de datos en crudo (volúmenes).
Subimos ficheros JSON con eventos de telemetría y los gobernamos desde Unity Catalog.
Figura 4. Esquema
¿Qué aprenderemos aquí?
Cómo convivir con distintos tipos de datos (estructurados y no estructurados), y cómo integrarlos con fuentes externas (como AWS S3).
Funciones reutilizables y modelos de IA
Registramos funciones personalizadas (como el cálculo de distancias) reutilizables desde el catálogo.
Creamos y registramos modelos de machine learning con MLflow.
Ejecutamos predicciones desde Unity Catalog como si fueran cualquier otro recurso del ecosistema.
Figura 5. Captura de pantalla
¿Qué aprenderemos aquí?
Cómo ampliar el gobierno de datos a funciones y modelos, y cómo facilitar su reutilización y trazabilidad en entornos colaborativos.
Resultados y conclusiones
Como resultado de este laboratorio práctico, vamos a poner conocer la herramienta Unity Catalog como plataforma abierta para la gobernanza de datos y recursos de datos como modelos de machine learning. Exploraremos, además, el contexto de un caso de uso concreto y con un ecosistema de herramientas similar al que podemos encontrar en una organización real, sus capacidades, su modo de despliegue y su uso.
Mediante este ejercicio configuraremos y utilizaremos Unity Catalog para organizar datos de transporte público. En concreto, podrás:
Aprender a instalar herramientas como Docker o Spark.
Crear catálogos, esquemas y tablas en Unity Catalog.
Cargar datos y almacenarlos en un bucket de Amazon S3.
Implementar un modelo de machine learning con MLflow.
Veremos, en los próximos años, si este tipo de herramientas alcanzan el nivel de estandarización necesario para transformar la forma en que se administran y comparten los recursos de datos en múltiples sectores.
¡Te animamos a realizar más ejercicios de ciencia de datos! Accede al repositorio aquí
Contenido elaborado por Juan Benavente, ingeniero superior industrial y experto en tecnologías ligadas a la economía del dato. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor.

Ciencia e tecnoloxía
En el panorama actual del análisis de datos y la inteligencia artificial, la generación automática de informes completos y coherentes representa un desafío significativo. Mientras que las herramientas tradicionales permiten visualizar datos o generar estadísticas aisladas, existe la necesidad de sistemas que puedan investigar un tema a fondo, recopilar información de diversas fuentes, y sintetizar hallazgos en un informe estructurado y coherente.
En este ejercicio práctico, exploraremos el desarrollo de un agente de generación de reportes basado en LangGraph e inteligencia artificial. A diferencia de los enfoques tradicionales basados en plantillas o análisis estadísticos predefinidos, nuestra solución aprovecha los últimos avances en modelos de lenguaje para:
Crear equipos virtuales de analistas especializados en diferentes aspectos de un tema.
Realizar entrevistas simuladas para recopilar información detallada.
Sintetizar los hallazgos en un informe coherente y bien estructurado.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
Como se muestra en la Figura 1, el flujo completo del agente sigue una secuencia lógica que va desde la generación inicial de preguntas hasta la redacción final del informe.
Figura 1. Diagrama de flujo del agente.
Arquitectura de la aplicación
El núcleo de la aplicación se basa en un diseño modular implementado como un grafo de estados interconectados, donde cada módulo representa una funcionalidad específica en el proceso de generación de reportes. Esta estructura permite un flujo de trabajo flexible, recursivo cuando es necesario, y con capacidad de intervención humana en puntos estratégicos.
Componentes principales
El sistema se compone de tres módulos fundamentales que trabajan en conjunto:
1. Generador de Analistas Virtuales
Este componente crea un equipo diverso de analistas virtuales especializados en diferentes aspectos del tema a investigar. El flujo incluye:
Creación inicial de perfiles basados en el tema de investigación.
Punto de retroalimentación humana que permite revisar y refinar los perfiles generados.
Regeneración opcional de analistas incorporando sugerencias.
Este enfoque garantiza que el informe final incluya perspectivas diversas y complementarias, enriqueciendo el análisis.
2. Sistema de Entrevistas
Una vez generados los analistas, cada uno participa en un proceso de entrevista simulada que incluye:
Generación de preguntas relevantes basadas en el perfil del analista.
Búsqueda de información en fuentes vía Tavily Search y Wikipedia.
Generación de respuestas informativas combinando la información obtenida.
Decisión automática sobre continuar o finalizar la entrevista en función de la información recopilada.
Almacenamiento de la transcripción para su procesamiento posterior.
El sistema de entrevistas representa el corazón del agente, donde se obtiene la información que nutrirá el informe final. Tal y como se muestra en la Figura 2, este proceso puede monitorizarse en tiempo real mediante LangSmith, una herramienta abierta de observabilidad que permite seguir cada paso del flujo.
Figura 2. Monitorización del sistema vía LangGraph. Ejemplo concreto de una interacción analista-entrevistador.
3. Generador de Informes
Finalmente, el sistema procesa las entrevistas para crear un informe coherente mediante:
Redacción de secciones individuales basadas en cada entrevista.
Creación de una introducción que presente el tema y la estructura del informe.
Organización del contenido principal que integra todas las secciones.
Generación de una conclusión que sintetiza los hallazgos principales.
Consolidación de todas las fuentes utilizadas.
La Figura 3 muestra un ejemplo del informe resultante del proceso completo, demostrando la calidad y estructura del documento final generado automáticamente.
Figura 3. Vista del informe resultante del proceso de generación automática al prompt de “Datos abiertos en España”.
¿Qué puedes aprender?
Este ejercicio práctico te permite aprender:
Integración de IA avanzada en sistemas de procesamiento de información:
Cómo comunicarse efectivamente con modelos de lenguaje.
Técnicas para estructurar prompts que generen respuestas coherentes y útiles.
Estrategias para simular equipos virtuales de expertos.
Desarrollo con LangGraph:
Creación de grafos de estados para modelar flujos complejos.
Implementación de puntos de decisión condicionales.
Diseño de sistemas con intervención humana en puntos estratégicos.
Procesamiento paralelo con LLM:
Técnicas de paralelización de tareas con modelos de lenguaje.
Coordinación de múltiples subprocesos independientes.
Métodos de consolidación de información dispersa.
Buenas prácticas de diseño:
Estructuración modular de sistemas complejos.
Manejo de errores y reintentos.
Seguimiento y depuración de flujos de trabajo mediante LangSmith.
Conclusiones y futuro
Este ejercicio demuestra el extraordinario potencial de la inteligencia artificial como puente entre los datos y los usuarios finales. A través del caso práctico desarrollado, podemos observar cómo la combinación de modelos de lenguaje avanzados con arquitecturas flexibles basadas en grafos abre nuevas posibilidades para la generación automática de informes.
La capacidad de simular equipos de expertos virtuales, realizar investigaciones paralelas y sintetizar hallazgos en documentos coherentes, representa un paso significativo hacia la democratización del análisis de información compleja.
Para aquellas personas interesadas en expandir las capacidades del sistema, existen múltiples direcciones prometedoras para su evolución:
Incorporación de mecanismos de verificación automática de datos para garantizar la precisión.
Implementación de capacidades multimodales que permitan incorporar imágenes y visualizaciones.
Integración con más fuentes de información y bases de conocimiento.
Desarrollo de interfaces de usuario más intuitivas para la intervención humana.
Expansión a dominios especializados como medicina, derecho o ciencias.
En resumen, este ejercicio no solo demuestra la viabilidad de automatizar la generación de informes complejos mediante inteligencia artificial, sino que también señala un camino prometedor hacia un futuro donde el análisis profundo de cualquier tema esté al alcance de todos, independientemente de su nivel de experiencia técnica. La combinación de modelos de lenguaje avanzados, arquitecturas de grafos y técnicas de paralelización abre un abanico de posibilidades para transformar la forma en que generamos y consumimos información.