28 exercicios de datos atopados

Ciencia e tecnoloxía
Introducción
En anteriores contenidos, hemos explorado a fondo el apasionante mundo de los Modelos Grandes de Lenguaje (LLM) y, en particular, las técnicas de Generación Aumentada por Recuperación (RAG) que están revolucionando la forma en que interactuamos con los agentes conversacionales. Este ejercicio marca un hito en nuestra serie, ya que no solo explicaremos los conceptos, sino que también te guiaremos paso a paso en la construcción de tu propio agente conversacional potenciado con RAG. Para ello, utilizaremos un notebook de Google Colab.
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
A través de este notebook, construiremos un chat que utiliza RAG para mejorar sus respuestas, partiendo desde cero. El notebook guiará al usuario a través de todo el proceso:
Instalación de dependencias.
Configuración del entorno.
Integración de una fuente de información en forma de post.
Incorporación de dicha fuente a la base de conocimiento del chat utilizando técnicas RAG.
Finalmente, podremos observar cómo la respuesta del modelo cambia antes y después de proporcionar el post y realizar una pregunta específica sobre su contenido.
Herramientas utilizadas
Antes de comenzar, es necesario introducir y explicar qué herramientas hemos utilizado y por qué hemos escogido estas. Para la construcción de esta aplicación RAG hemos utilizado 3 piezas de tecnología o herramientas: Google Colab, OpenAI y LangChain. Tanto Google Colab como OpenAI son viejos conocidos y los hemos utilizado varias veces en contenidos previos. Por eso, en esta sección, ponemos especial atención en explicar qué es LangChain puesto que es una nueva herramienta que no hemos utilizado en anteriores posts.
Google Colab. Como es habitual en nuestros ejercicios, cuando son necesarios recursos de computación, así como un entorno de programación amigable, empleamos Google Colab, en la medida de lo posible. Google Colab nos garantiza que cualquier usuario que quiera reproducir el ejercicio lo pueda hacer sin complicaciones derivadas de la configuración de los entornos particulares de cada programador. Cabe destacar que adecuar este ejercicio inspirado en recursos previos disponibles en LangChain al entorno de Google Colab ha sido un reto.
OpenAI. Como proveedor del modelo grande del lenguaje (LLM) Chat GPT, OpenAI ofrece una variedad de modelos de lenguaje potentes, como GPT-4, GPT-4o, GPT-4o mini, etc. que se utilizan para procesar y generar texto en lenguaje natural. En este caso, el modelo de lenguaje de OpenAI se utiliza en la zona de generación de la respuesta, donde se combinan la pregunta del usuario y los documentos recuperados para producir una respuesta precisa.
LangChain. Es un framework (conjunto de bibliotecas) de código abierto diseñado para facilitar el desarrollo de aplicaciones basadas en modelos de lenguaje de gran escala (LLM). Este framework es especialmente útil para integrar y gestionar flujos complejos que combinan múltiples componentes, como modelos de lenguaje, bases de datos vectoriales, y herramientas de recuperación de información, entre otros.
LangChain es ampliamente utilizado en el desarrollo de aplicaciones como:
Sistemas de preguntas y respuestas (QA systems).
Asistentes virtuales con conocimiento específico.
Sistemas de generación de texto personalizados.
Herramientas de análisis de datos basadas en lenguaje natural.
Características principales de LangChain
Modularidad y flexibilidad. LangChain está diseñado con una arquitectura modular que permite a los desarrolladores conectar diferentes herramientas y servicios. Esto incluye modelos de lenguaje (como OpenAI, Hugging Face, o LLM locales) y bases de datos vectoriales (como Pinecone, ChromaDB o Weaviate). La La lista de modelos de chat con los que se puede interactuar a través de Langchain es muy amplia.
Soporte para técnicas RAG (Recuperación Aumentada por Generación). Langhain facilita la implementación de técnicas RAG al permitir la integración directa de modelos de recuperación de información y generación de texto. Esto mejora la precisión de las respuestas al permitir que los LLM trabajen con conocimiento actualizado y específico.
Optimización del manejo de prompts. Langhain ayuda a diseñar y gestionar prompts complejos de manera eficiente. Permite construir dinámicamente un contexto relevante que se trabaja con el modelo, optimizando el uso de tokens y asegurando que las respuestas sean precisas y útiles.
Los tokens representan las unidades básicas que un modelo de IA utiliza para procesar texto. Un token puede ser una palabra completa, una parte de una palabra o un signo de puntuación. En la frase "¡Hola mundo!" existen, por ejemplo, cuatro tokens distintos: "¡", "Hola", "mundo", "!". El procesamiento de texto requiere más recursos computacionales a medida que aumenta el número de tokens. Las versiones gratuitas de modelos de IA, incluida la que usamos en este ejercicio, establecen límites en la cantidad de tokens procesables.
Integración con múltiples fuentes de datos. El framework puede conectarse a diversas fuentes de datos, como bases de datos, API o documentos cargados por los usuarios. Esto lo hace ideal para construir aplicaciones que necesitan acceso a grandes volúmenes de información estructurada o no estructurada.
Interoperabilidad con múltiples LLM. LangChain es agnóstico (se puede adaptar a varios proveedores de modelos de lenguaje) respecto al proveedor del modelo de lenguaje, lo que significa que puedes utilizar OpenAI, Cohere, Anthropic o incluso modelos de lenguaje alojados localmente.
Para terminar con esta sección, cabe destacar el carácter open source de Langhain, algo que facilita la colaboración y la innovación en el desarrollo de aplicaciones basadas en modelos de lenguaje. Además, LangChain nos aporta una increíble flexibilidad porque permite a los desarrolladores integrar fácilmente diferentes LLM, vectorizadores y hasta interfaces web finales en sus aplicaciones.
Exploración del ejercicio paso a paso
Introducción al Repositorio
El repositorio de Github que utilizaremos contiene todos los recursos necesarios para construir nuestra aplicación RAG. En su interior, encontrarás:
README: este archivo proporciona una descripción general del proyecto, instrucciones de uso y recursos adicionales.
Jupyter Notebook: el ejemplo lo hemos desarrollado usando un formato de Jupyter Notebook que ya hemos empleado en el pasado para codificar ejercicios prácticos combinando un documento de texto con fragmentos de código ejecutable en Google Colab. Aquí se encuentra la implementación detallada de la aplicación, incluyendo la carga y procesamiento de datos, la integración con modelos de lenguaje como GPT-44, la configuración de sistemas de recuperación de información y la generación de respuestas basadas en los datos recuperados.
Notebook: preparando el entorno
Antes de comenzar, es recomendable contar con los siguientes requisitos.
Conocimientos básicos de Python y Procesamiento de Lenguaje Natural (PLN): si bien el notebook es autoexplicativo, una comprensión básica de estos conceptos facilitará el aprendizaje.
Acceso a Google Colab: el notebook se ejecuta en este entorno, que nos proporciona la infraestructura necesaria.
Cuentas activas en OpenAI y LangChain con claves de API válidas. Estos servicios son gratuitos y esenciales para la ejecución del notebook. Una vez que te registres en estos servicios, necesitarás generar una API Key para interactuar con los servicios. Deberás tener a mano esta clave para poder pegarla en el momento de ejecutar el fragmento de código correspondiente. Si necesitas ayuda para obtener estas claves, cualquier asistente conversacional como chatGPT o Google Gemini te pueden ayudar paso a paso a conseguir las claves. Si necesitas guía visual en youtube encontraras miles de tutoriales
OpenAI API: https://openai.com/api/
Lanchain API: https://www.langchain.com/
Explorando el Notebook: bloque por bloque
El notebook se divide en varios bloques, cada uno dedicado a una etapa específica del desarrollo de nuestra aplicación RAG. A continuación, describiremos cada bloque en detalle, incluyendo el código utilizado y su explicación.
Nota para el usuario. A continuación, vamos a ir reproduciendo bloques del código presentes en el notebook de Colab. Por claridad hemos dividido el código en unidades autocontenidas y hemos formateado el código para resaltar la sintaxis del lenguaje de programación Python. Además, las salidas que el Notebook proporciona, las hemos formateado y resaltado en formato JSON para que sean más legibles. Ha de tenerse en cuenta que este Notebook invoca API de modelos del lenguaje y por lo tanto, la respuesta del modelo cambia con cada ejecución. Esto hace que las salidas (las respuestas) que presentamos en este post puedan no ser exactamente iguales a las que el usuario reciba cuándo ejecute el Notebook en Colab
Bloque 1: instalación y configuración inicial
import osos.kill(os.getpid(), 9)
Es muy importante que ejecutes estas dos líneas al principio del ejercicio y luego ya no lo vuelvas a ejecutar más hasta que cierres y salgas de Google Colab.
%%capture!pip install openai==1.55.3 httpx==0.27.2 --force-reinstall --quiet
!pip install langchain --quiet%pip install --quiet --upgrade langchain-text-splitters langchain-community
import getpassimport osos.environ["LANGCHAIN_TRACING_V2"] = "true"os.environ["LANGCHAIN_API_KEY"] = getpass.getpass()
Cuando ejecutes este fragmento, aparecerá un pequeño cuadro de diálogo debajo del fragmento. Ahí debes de pegar tu API Key de Langchain.
!pip install -qU langchain-openai!pip install -qU langgraph
import getpassimport osos.environ["OPENAI_API_KEY"] = getpass.getpass()from langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o-mini")
Cuando ejecutes este fragmento, aparecerá un pequeño cuadro de diálogo debajo del fragmento. Ahí debes de pegar tu API Key de OpenAI.
En este primer bloque, hemos instalado las bibliotecas necesarias para nuestro proyecto. Algunas de las más relevantes son:
openai: Para interactuar con la API de OpenAI y acceder a modelos como GPT-4.
langchain: Un framework que simplifica el desarrollo de aplicaciones con LLM.
langchain-text-splitters: Para dividir textos largos en fragmentos más pequeños que puedan ser procesados por los modelos de lenguaje.
langchain-community: Una colección de herramientas y componentes adicionales para LangChain.
langchain-openai: Para integrar LangChain con la API de OpenAI.
langgraph: Para visualizar el flujo de trabajo de nuestra aplicación RAG.
Además de instalar las bibliotecas, también configuramos las claves de API para OpenAI y LangChain, utilizando la función getpass.getpass() para introducirlas de forma segura.
Bloque 2: inicializamos la interacción con el LLM
A continuación, iniciamos la primera interacción programática (le pasamos nuestro primer prompt) con el modelo del lenguaje. Para comprobar que todo funciona le pedimos traducir una sencilla frase.
import getpass
import osos.environ["OPENAI_API_KEY"] = getpass.getpass()from langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o-mini")from langchain_core.messages import HumanMessage, SystemMessagemessages = [SystemMessage("Translate the following from English into Italian"),HumanMessage("hi!"),]llm.invoke(messages)
Si todo ha ido bien obtendremos una salida como esta:
{ "content": "Ciao!", "additional_kwargs": { "refusal": null }, "response_metadata": { "token_usage": { "completion_tokens": 3, "prompt_tokens": 20, "total_tokens": 23, "completion_tokens_details": { "accepted_prediction_tokens": 0, "audio_tokens": 0, "reasoning_tokens": 0, "rejected_prediction_tokens": 0 }, "prompt_tokens_details": { "audio_tokens": 0, "cached_tokens": 0 } }, "model_name": "gpt-4o-mini-2024-07-18", "system_fingerprint": "fp_bd83329f63", "finish_reason": "stop", "logprobs": null }, "id": "run-ca631c07-fb63-47b2-8e78-339460c8a508-0", "usage_metadata": { "input_tokens": 20, "output_tokens": 3, "total_tokens": 23, "input_token_details": { "audio": 0, "cache_read": 0 }, "output_token_details": { "audio": 0, "reasoning": 0 } }}
Este bloque es una introducción básica a la utilización de un LLM para una tarea sencilla: la traducción. Se configura la clave de API de OpenAI y se instancia un modelo de lenguaje gpt-4o-mini utilizando ChatOpenAI.
Se definen dos mensajes:
SystemMessage: Instrucción al modelo para traducir del inglés al italiano.
HumanMessage: El texto que se desea traducir ("hi!").
Finalmente, se invoca al modelo con llm.invoke(messages) para obtener la traducción.
Bloque 3: creando Embeddings
Para entender el concepto del Embeddings aplicado al contexto del procesamiento del lenguaje natural recomendamos leer este post.
import getpassos.environ["OPENAI_API_KEY"] = getpass.getpass()from langchain_openai import OpenAIEmbeddingsembeddings = OpenAIEmbeddings(model="text-embedding-3-large")
pip install -qU langchain-core
from langchain_core.vectorstores import InMemoryVectorStorevector_store = InMemoryVectorStore(embeddings)
Cuando ejecutes este fragmento, aparecerá un pequeño cuadro de diálogo debajo del fragmento. Ahí debes de pegar tu API Key de OpenAI.
Este bloque se centra en la creación de embeddings (representaciones vectoriales de texto) que capturan su significado semántico. Utilizamos la clase OpenAIEmbeddings para acceder al modelo text-embedding-3-large de OpenAI, que genera embeddings de alta calidad.
Los embeddings se almacenarán en un InMemoryVectorStore, una estructura de datos en memoria que permite realizar búsquedas eficientes basadas en similitud semántica.
Bloque 4: implementando RAG
#RAGimport bs4from langchain_community.document_loaders import WebBaseLoader# Manten únicamente el título del post, los encabezados y el contenido del HTML bs4_strainer = bs4.SoupStrainer(class_=("post-title", "post-header", "post-content"))loader = WebBaseLoader(web_paths=("https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…",))docs = loader.load()assert len(docs) == 1print(f"Total characters: {len(docs.page_content)}")from langchain_text_splitters import RecursiveCharacterTextSplittertext_splitter = RecursiveCharacterTextSplitter(chunk_size=1000,chunk_overlap=200,add_start_index=True,)all_splits = text_splitter.split_documents(docs)print(f"Split blog post into {len(all_splits)} sub-documents.")document_ids = vector_store.add_documents(documents=all_splits)print(document_ids[:3])
Este bloque es el corazón de la implementación RAG. Comienza cargando el contenido de un post, utilizando WebBaseLoader y la URL del post sobre SLM, LLM, RAG y Fine-tuning.
Para preparar nuestro sistema de Recuperación Aumentada por Generación (RAG), comenzamos procesando el texto del post mediante técnicas de segmentación. Este paso inicial resulta fundamental, ya que dividimos el contenido en fragmentos más pequeños pero completos en significado. Utilizamos las herramientas de LangChain para realizar esta segmentación, asignando a cada fragmento un identificador único (id). Esta preparación previa nos permite posteriormente realizar búsquedas eficientes y precisas cuando el sistema necesite recuperar información relevante para responder a las consultas.
Se utiliza bs4.SoupStrainer para extraer solo las secciones relevantes del HTML. El texto del post se divide en fragmentos más pequeños con RecursiveCharacterTextSplitter, asegurando un solapamiento entre fragmentos para mantener el contexto. Estos fragmentos se añaden al vector_store creado en el bloque anterior, generando embeddings para cada uno.
Vemos que el resultado de uno de los fragmentos nos informa que ha dividido el documento en 21 sub-documentos.
Split blog post into 21 sub-documents.
Los documentos tienen un identificador propio. Por ejemplo, los 3 primeros se identifican como:
["409f1bcb-1710-49b0-80f8-e45b7ca51a96", "e242f16c-71fd-4e7b-8b28-ece6b1e37a1c", "9478b11c-61ab-4dac-9903-f8485c4770c6"]
Bloque 5: definiendo el Prompt y visualizando el flujo de trabajo
from langchain import hubprompt = hub.pull("rlm/rag-prompt")example_messages = prompt.invoke({"context": "(context goes here)", "question": "(question goes here)"}).to_messages()assert len(example_messages) == 1print(example_messages.content)from langchain_core.documents import Documentfrom typing_extensions import List, TypedDictclass State(TypedDict):question: strcontext: List[Document]answer: strdef retrieve(state: State):retrieved_docs = vector_store.similarity_search(state["question"])return {"context": retrieved_docs}def generate(state: State):docs_content = "\n\n".join(doc.page_content for doc in state["context"])messages = prompt.invoke({"question": state["question"], "context": docs_content})response = llm.invoke(messages)return {"answer": response.content}from langgraph.graph import START, StateGraphgraph_builder = StateGraph(State).add_sequence([retrieve, generate])graph_builder.add_edge(START, "retrieve")graph = graph_builder.compile()from IPython.display import Image, displaydisplay(Image(graph.get_graph().draw_mermaid_png()))result = graph.invoke({"question": "What is Task Decomposition?"})print(f"Context: {result["context"]}\n\n")print(f"Answer: {result["answer"]}")for step in graph.stream({"question": "¿Cual es el futuro de la IA Generativa?"}, stream_mode="updates"):print(f"{step}\n\n----------------\n")
Este bloque define el prompt que se utilizará para interactuar con el LLM. Se utiliza un prompt predefinido de LangChain Hub (rlm/rag-prompt) que está diseñado para tareas RAG.
Se definen dos funciones:
retrieve: busca en el vector_store los fragmentos más similares a la pregunta del usuario.
generate: genera una respuesta utilizando el LLM, teniendo en cuenta el contexto proporcionado por los fragmentos recuperados.
Se utiliza langgraph para visualizar el flujo de trabajo RAG.
Figura 1: flujo de trabajo RAG. Elaboración propia.
Finalmente, se prueba el sistema con dos preguntas: una en inglés ("What is Task Decomposition?") y otra en español ("¿Cual es el futuro de la IA Generativa?").
La primera pregunta, "What is Task Decomposition?, está en inglés y es una pregunta genérica, sin relación con nuestro post de contenido. Por esto, pese a que el sistema, busca en su base de conocimiento previamente creada con la vectorización del documento (post) no encuentra relación entre la pregunta y este contexto.
Este texto puede variar con cada ejecución
Answer: No se menciona explícitamente el concepto de "Task Decomposition" en el contexto proporcionado. Por lo tanto, no tengo información sobre qué es Task Decomposition.
Answer: Task Decomposition es un proceso que descompone una tarea compleja en subtareas más pequeñas y manejables. Esto permite abordar cada subtarea de manera independiente, facilitando su resolución y mejorando la eficiencia general. Aunque el contexto proporcionado no define explícitamente Task Decomposition, este concepto es común en la IA y optimización de tareas.
Esta respuesta es la que proporciona el modelo del lenguaje sin ninguna base de conocimiento específica. Ahora bien, cuando preguntamos por algo que tiene que ver con el post que hemos cargado como base de conocimiento, la técnica RAG entra en funcionamiento y ejecuta los mecanismos secuenciales de retrieve y generate.
{ "retrieve": { "context": [ { "id": "53962c40-c08b-4547-a74a-26f63cced7e8", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 12763 }, "page_content": "La verdadera magia ocurre cuando estos elementos se combinan de formas innovadoras, creando sistemas de IA Generativa más potentes, precisos y adaptables que nunca. A medida que estas tecnologías continúen evolucionando, podemos esperar ver aplicaciones cada vez más sofisticadas y útiles en una amplia gama de campos, desde la atención médica hasta la creación de contenido creativo.\nEl desafío para los desarrolladores e investigadores será encontrar el equilibrio óptimo entre estos elementos, considerando factores como la eficiencia computacional, la precisión, la adaptabilidad y la ética. El futuro de la IA Generativa promete ser fascinante, y estos cuatro conceptos estarán sin duda en el centro de su desarrollo y aplicación en los años venideros." }, { "id": "2dcdfcb3-e9cf-440b-a08a-6db6d5ddb356", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 11496 }, "page_content": "Conclusiones y futuro de la IA\nLa combinación de estos cuatro pilares está abriendo nuevas posibilidades en el campo de la IA Generativa:\n\nSistemas híbridos: combinación de SLM y LLM para diferentes aspectos de una misma aplicación, optimizando rendimiento y eficiencia.\nRAG avanzado: implementación de sistemas RAG más sofisticados que utilicen múltiples fuentes de información y técnicas de recuperación más avanzadas.\nFine-tuning continuo: desarrollo de técnicas para el ajuste continuo de modelos en tiempo real, adaptándose a nuevos datos y necesidades.\nPersonalización a escala: creación de modelos altamente personalizados para individuos o pequeños grupos, combinando fine-tuning y RAG.\nIA Generativa ética y responsable: implementación de estas técnicas con un enfoque en la transparencia, la verificabilidad y la reducción de sesgos." }, { "id": "9478b11c-61ab-4dac-9903-f8485c4770c6", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 1341 }, "page_content": "Fecha de la noticia: 09-09-2024\n\nEn el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación (RAG) y el Fine-tuning. En este artículo, exploraremos cada uno de estos términos, sus interrelaciones y cómo están moldeando el futuro de la IA generativa.\nEmpecemos por el principio. Definiciones." }, { "id": "d6dd28f3-5a20-4cee-8cbf-6bc39adbf098", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 12341 }, "page_content": "SLM, LLM, RAG y Fine-tuning representan los pilares fundamentales sobre los que se está construyendo el futuro de la IA Generativa. Cada uno de estos conceptos aporta fortalezas únicas:\n\nLos SLM ofrecen eficiencia y especialización.\nLos LLM proporcionan versatilidad y capacidad de generalización.\nRAG mejora la precisión y relevancia de las respuestas.\nEl Fine-tuning permite la adaptación y personalización de modelos." } ] }}
Cómo se ve en la respuesta, el sistema recupera 4 documentos (en el diagrama anterior, esto corresponde a la etapa de “Retrieve”) con sus correspondientes “id” (identificadores) cómo por ejemplo, el primer documento "id": "53962c40-c08b-4547-a74a-26f63cced7e8" que se corresponde con un fragmento del post original "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es"
Con esos 4 fragmentos el sistema considera que tiene suficiente información relevante para proporcionar (en el diagrama anterior, la etapa “generate”) una respuesta satisfactoria a la pregunta.
{ "generate": { "answer": "El futuro de la IA Generativa promete ser fascinante, con el desarrollo de sistemas más potentes, precisos y adaptables gracias a la combinación de los modelos de lenguaje pequeños (SLM), los grandes (LLM), la generación aumentada por recuperación (RAG) y el fine-tuning. Esperamos ver aplicaciones cada vez más sofisticadas en campos como la atención médica y la creación de contenido creativo, mientras se busca un equilibrio entre eficiencia, precisión y ética. La implementación de estas tecnologías con un enfoque ético y responsable será clave en su evolución." }}
Bloque 6: personalizando el prompt
from langchain_core.prompts import PromptTemplatetemplate = """Use the following pieces of context to answer the question at the end.If you don"t know the answer, just say that you don"t know, don"t try to make up an answer.Use three sentences maximum and keep the answer as concise as possible.Always say "thanks for asking!" at the end of the answer.{context}Question: {question}Helpful Answer:"""custom_rag_prompt = PromptTemplate.from_template(template)
Este bloque personaliza el prompt para que las respuestas sean más concisas y añadan una frase de cortesía al final. Se utiliza PromptTemplate para crear un nuevo prompt con las instrucciones deseadas.
Bloque 7: añadiendo metadatos y refinando la búsqueda
total_documents = len(all_splits)third = total_documents // 3for i, document in enumerate(all_splits):if i < third:document.metadata["section"] = "beginning"elif i < 2 * third:document.metadata["section"] = "middle"else:document.metadata["section"] = "end"all_splits.metadatafrom langchain_core.vectorstores import InMemoryVectorStorevector_store = InMemoryVectorStore(embeddings)_ = vector_store.add_documents(all_splits)from typing import Literalfrom typing_extensions import Annotatedclass Search(TypedDict):"""Search query."""query: Annotated[str, ..., "Search query to run."]section: Annotated(Literal["beginning", "middle", "end"],...,"Section to query.",]class State(TypedDict):question: strquery: Searchcontext: List[Document]answer: strdef analyze_query(state: State):structured_llm = llm.with_structured_output(Search)query = structured_llm.invoke(state["question"])return {"query": query}def retrieve(state: State):query = state["query"]retrieved_docs = vector_store.similarity_search(query["query"],filter=lambda doc: doc.metadata.get("section") == query["section"],)return {"context": retrieved_docs}def generate(state: State):docs_content = "\n\n".join(doc.page_content for doc in state["context"])messages = prompt.invoke({"question": state["question"], "context": docs_content})response = llm.invoke(messages)return {"answer": response.content}graph_builder = StateGraph(State).add_sequence([analyze_query, retrieve, generate])graph_builder.add_edge(START, "analyze_query")graph = graph_builder.compile()display(Image(graph.get_graph().draw_mermaid_png()))for step in graph.stream({"question": "¿Cual es el furturo de la IA Generativa en palabras del autor?"},stream_mode="updates",):print(f"{step}\n\n----------------\n")
En este bloque, se añaden metadatos a los fragmentos del post, dividiéndolos en tres secciones: "beginning", "middle" y "end". Esto permite realizar búsquedas más refinadas, limitando la búsqueda a una sección específica del post.
Se introduce una nueva función analyze_query que utiliza el LLM para determinar la sección del post más relevante para la pregunta del usuario. El flujo de trabajo RAG se actualiza para incluir esta nueva etapa.
Finalmente, se prueba el sistema con una pregunta en español ("¿Cuál es el futuro de la IA Generativa en palabras del autor?"), observando cómo el sistema utiliza la información de la sección "end" del post para generar una respuesta más precisa.
Veamos el resultado:
Figura 2: flujo de trabajo RAG. Elaboración propia.
{ "analyze_query": { "query": { "query": "futuro de la IA Generativa", "section": "end" } }}----------------{ "retrieve": { "context": [ { "id": "887fa76d-5bda-41fb-8976-eca46cff194e", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 11496, "section": "end" }, "page_content": "Conclusiones y futuro de la IA\nLa combinación de estos cuatro pilares está abriendo nuevas posibilidades en el campo de la IA Generativa: Sistemas híbridos: combinación de SLM y LLM para diferentes aspectos de una misma aplicación, optimizando rendimiento y eficiencia. RAG avanzado: implementación de sistemas RAG más sofisticados que utilicen múltiples fuentes de información y técnicas de recuperación más avanzadas. Fine-tuning continuo: desarrollo de técnicas para el ajuste continuo de modelos en tiempo real, adaptándose a nuevos datos y necesidades. Personalización a escala: creación de modelos altamente personalizados para individuos o pequeños grupos, combinando fine-tuning y RAG. IA Generativa ética y responsable: implementación de estas técnicas con un enfoque en la transparencia, la verificabilidad y la reducción de sesgos." }, { "id": "383ed352-8245-40e1-8249-7efbc6cbfd28", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 12763, "section": "end" }, "page_content": "La verdadera magia ocurre cuando estos elementos se combinan de formas innovadoras, creando sistemas de IA Generativa más potentes, precisos y adaptables que nunca. A medida que estas tecnologías continúen evolucionando, podemos esperar ver aplicaciones cada vez más sofisticadas y útiles en una amplia gama de campos, desde la atención médica hasta la creación de contenido creativo. El desafío para los desarrolladores e investigadores será encontrar el equilibrio óptimo entre estos elementos, considerando factores como la eficiencia computacional, la precisión, la adaptabilidad y la ética. El futuro de la IA Generativa promete ser fascinante, y estos cuatro conceptos estarán sin duda en el centro de su desarrollo y aplicación en los años venideros." }, { "id": "d0fd32fa-5fb9-49a1-9d23-7368cb3d30e2", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 12341, "section": "end" }, "page_content": "SLM, LLM, RAG y Fine-tuning representan los pilares fundamentales sobre los que se está construyendo el futuro de la IA Generativa. Cada uno de estos conceptos aporta fortalezas únicas: Los SLM ofrecen eficiencia y especialización. Los LLM proporcionan versatilidad y capacidad de generalización. RAG mejora la precisión y relevancia de las respuestas. El Fine-tuning permite la adaptación y personalización de modelos." }, { "id": "c064efe8-e782-4fde-9944-9a1ffd88ff7f", "metadata": { "source": "https://datos.gob.es/es/blog/slm-llm-rag-y-fine-tuning-pilares-de-la-ia…", "title": "SLM, LLM, RAG y Fine-tuning: Pilares de la IA Generativa Moderna | datos.gob.es", "description": "En el vertiginoso mundo de la Inteligencia Artificial (IA) Generativa, encontramos diversos conceptos que se han convertido en fundamentales para comprender y aprovechar el potencial de esta tecnología. Hoy nos centramos en cuatro: los Modelos de Lenguaje Pequeños (SLM, por sus siglas en inglés), los Modelos de Lenguaje Grandes (LLM), la Generación Aumentada por Recuperación", "language": "es", "start_index": 13522, "section": "end" }, "page_content": "Contenido elaborado por Alejandro Alija, experto en Transformación Digital e Innovación. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor. inteligencia artificial procesamiento del lenguaje natural PLN RAG LLM SLM fine-tuning algoritmos deep learning" } ] }}
{ "generate": { "answer": "El futuro de la IA Generativa se centra en la combinación de SLM, LLM, RAG y fine-tuning, que permiten crear sistemas más potentes, precisos y adaptables. A medida que estas tecnologías evolucionen, se espera ver aplicaciones sofisticadas en diversos campos. Sin embargo, el reto será equilibrar eficiencia, precisión, adaptabilidad y ética en su desarrollo." }}
Conclusiones
A través de este recorrido por el notebook de Google Colab, hemos experimentado de primera mano la construcción de un agente conversacional con RAG. Hemos aprendido a:
Instalar las bibliotecas necesarias.
Configurar el entorno de desarrollo.
Cargar y procesar datos.
Crear embeddings y almacenarlos en un vector_store.
Implementar las etapas de recuperación y generación de RAG.
Personalizar el prompt para obtener respuestas más específicas.
Añadir metadatos para refinar la búsqueda.
Este ejercicio práctico te proporciona las herramientas y conocimientos necesarios para comenzar a explorar el potencial de RAG y desarrollar tus propias aplicaciones.
¡Anímate a experimentar con diferentes fuentes de información, modelos de lenguaje y prompts para crear agentes conversacionales cada vez más sofisticados!
Contenido elaborado por Alejandro Alija,experto en Transformación Digital e Innovación. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor.


Ciencia e tecnoloxía
Los portales de datos abiertos son una fuente invaluable de información pública. Sin embargo, extraer insights significativos de estos datos puede resultar desafiante para usuarios sin conocimientos técnicos avanzados.
En este ejercicio práctico, exploraremos el desarrollo de una aplicación web que democratiza el acceso a estos datos mediante el uso de inteligencia artificial, permitiendo realizar consultas en lenguaje natural.
La aplicación, desarrollada utilizando el portal datos.gob.es como fuente de datos, integra tecnologías modernas como Streamlit para la interfaz de usuario y el modelo de lenguaje Gemini de Google para el procesamiento de lenguaje natural. La naturaleza modular permite que se pueda utilizar cualquier modelo de Inteligencia Artificial con mínimos cambios. El proyecto completo está disponible en el repositorio de GitHub.
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
Arquitectura de la aplicación
El núcleo de la aplicación se basa en cuatro apartados principales e interconectados que trabajan para procesar las consultas de la persona usuaria:
Generación del Contexto
Analiza las características del dataset elegido.
Genera una descripción detallada incluyendo dimensiones, tipos de datos y estadísticas.
Crea una plantilla estructurada con guías específicas para la generación de código.
Combinación de Contexto y Consulta
Une el contexto generado con la pregunta de la persona usuaria creando el prompt que recibirá el modelo de inteligencia artificial.
Generación de Respuesta
Envía el prompt al modelo y obtiene el código Python que permite resolver la cuestión generada.
Ejecución del Código
Ejecuta de manera segura el código generado con un sistema de reintentos y correcciones automáticas.
Captura y expone los resultados en el frontal de la aplicación.
Figura 1. Flujo de procesamiento de solicitudes
Proceso de desarrollo
El primer paso es establecer una forma de acceder a los datos públicos. El portal datos.gob.es ofrece vía API los datasets. Se han desarrollado funciones para navegar por el catálogo y descargar estos archivos de forma eficiente.
Figura 2. API de datos.gob
El segundo paso aborda la cuestión: ¿cómo convertir preguntas en lenguaje natural en análisis de datos útiles? Aquí es donde entra Gemini, el modelo de lenguaje de Google. Sin embargo, no basta con simplemente conectar el modelo; es necesario enseñarle a entender el contexto específico de cada dataset.
Se ha desarrollado un sistema en tres capas:
Una función que analiza el dataset y genera una "ficha técnica" detallada.
Otra que combina esta ficha con la pregunta del usuario.
Y una tercera que traduce todo esto en código Python ejecutable.
Se puede ver en la imagen inferior como se desarrolla este proceso y, posteriormente, se muestran los resultados del código generado ya ejecutado.
Figura 3. Visualización del procesamiento de respuesta de la aplicación
Por último, con Streamlit, se ha construido una interfaz web que muestra el proceso y sus resultados al usuario. La interfaz es tan simple como elegir un dataset y hacer una pregunta, pero también lo suficientemente potente como para mostrar visualizaciones complejas y permitir la exploración de datos.
El resultado final es una aplicación que permite a cualquier persona, independientemente de sus conocimientos técnicos, realizar análisis de datos y aprender sobre el código ejecutado por el modelo. Por ejemplo, un funcionario municipal puede preguntar "¿Cuál es la edad media de la flota de vehículos?" y obtener una visualización clara de la distribución de edades.
Figura 4. Caso de uso completo. Visualizar la distribución de los años de matriculación de la flota automovilística del ayuntamiento de Almendralejo en 2018
¿Qué puedes aprender?
Este ejercicio práctico te permite aprender:
Integración de IA en Aplicaciones Web:
Cómo comunicarse efectivamente con modelos de lenguaje como Gemini.
Técnicas para estructurar prompts que generen código preciso.
Estrategias para manejar y ejecutar código generado por IA de forma segura.
Desarrollo Web con Streamlit:
Creación de interfaces interactivas en Python.
Manejo de estado y sesiones en aplicaciones web.
Implementación de componentes visuales para datos.
Trabajo con Datos Abiertos:
Conexión y consumo de APIs de datos públicos.
Procesamiento de archivos Excel y DataFrames.
Técnicas de visualización de datos.
Buenas Prácticas de Desarrollo:
Estructuración modular de código Python.
Manejo de errores y reintentos.
Implementación de sistemas de feedback visual.
Despliegue de aplicaciones web usando ngrok.
Conclusiones y futuro
Este ejercicio demuestra el extraordinario potencial de la inteligencia artificial como puente entre los datos públicos y los usuarios finales. A través del caso práctico desarrollado, hemos podido observar cómo la combinación de modelos de lenguaje avanzados con interfaces intuitivas permite democratizar el acceso al análisis de datos, transformando consultas en lenguaje natural en análisis significativos y visualizaciones informativas.
Para aquellas personas interesadas en expandir las capacidades del sistema, existen múltiples direcciones prometedoras para su evolución:
Incorporación de modelos de lenguaje más avanzados que permitan análisis más sofisticados.
Implementación de sistemas de aprendizaje que mejoren las respuestas basándose en el feedback del usuario.
Integración con más fuentes de datos abiertos y formatos diversos.
Desarrollo de capacidades de análisis predictivo y prescriptivo.
En resumen, este ejercicio no solo demuestra la viabilidad de democratizar el análisis de datos mediante la inteligencia artificial, sino que también señala un camino prometedor hacia un futuro donde el acceso y análisis de datos públicos sea verdaderamente universal. La combinación de tecnologías modernas como Streamlit, modelos de lenguaje y técnicas de visualización abre un abanico de posibilidades para que organizaciones y ciudadanos aprovechen al máximo el valor de los datos abiertos.

Ciencia e tecnoloxía
Los portales de datos abiertos juegan un papel fundamental en el acceso y reutilización de la información pública. Un aspecto clave en estos entornos es el etiquetado de los conjuntos de datos, que facilita su organización y recuperación.
Los word embeddings representan una tecnología transformadora en el campo del procesamiento del lenguaje natural, permitiendo representar palabras como vectores en un espacio multidimensional donde las relaciones semánticas se preservan matemáticamente. En este ejercicio se explora su aplicación práctica en un sistema de recomendación de etiquetas, utilizando como caso de estudio el portal de datos abiertos datos.gob.es.
El ejercicio se desarrolla en un notebook que integra la configuración del entorno, la adquisición de datos y el procesamiento del sistema de recomendación, todo ello implementado en Python. El proyecto completo se encuentra disponible en el repositorio de GitHub.
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
Entendiendo los word embeddings
Los word embeddings son representaciones numéricas de palabras que revolucionan el procesamiento del lenguaje natural al transformar el texto en un formato matemáticamente procesable. Esta técnica codifica cada palabra como un vector numérico en un espacio multidimensional, donde la posición relativa entre vectores refleja relaciones semánticas y sintácticas entre palabras. La verdadera potencia de los embeddings radica en tres aspectos fundamentales:
Captura de contexto: a diferencia de técnicas tradicionales como one-hot encoding, los embeddings aprenden del contexto en el que aparecen las palabras, permitiendo capturar matices de significado.
Algebra semántica: los vectores resultantes permiten operaciones matemáticas que preservan relaciones semánticas. Por ejemplo, vector('Madrid') - vector('España') + vector('Francia') ≈ vector('París'), demostrando la captura de relaciones capital-país.
Similitud cuantificable: la similitud entre palabras se puede medir mediante métricas, permitiendo identificar no solo sinónimos exactos sino también términos relacionados en diferentes grados y generalizar estas relaciones a nuevas combinaciones de palabras.
En este ejercicio se han utilizado embeddings pre-entrenados GloVe (Global Vectors for Word Representation), un modelo desarrollado por Stanford que destaca por su capacidad de capturar relaciones semánticas globales en el texto. En nuestro caso, empleamos vectores de 50 dimensiones, un equilibrio entre complejidad computacional y riqueza semántica. Para evaluar exhaustivamente su capacidad de representar el lenguaje castellano, se han realizado múltiples pruebas:
Se ha analizado la similitud entre palabras mediante la similitud coseno, una métrica que evalúa el ángulo entre los vectores de dos palabras. Esta medida resulta en valores entre -1 y 1, donde valores cercanos a 1 indican alta similitud semántica, mientras que valores cercanos a 0 indican poca o ninguna relación. Se evaluaron términos como "amor", "trabajo" y "familia" para verificar que el modelo identificara correctamente palabras semánticamente relacionadas.
Se ha probado la capacidad del modelo para resolver analogías lingüísticas, por ejemplo, "hombre es a mujer lo que rey es a reina", confirmando su habilidad para capturar relaciones semánticas complejas.
Se han realizado operaciones vectoriales (como "rey - hombre + mujer") para comprobar si los resultados mantenían coherencia semántica.
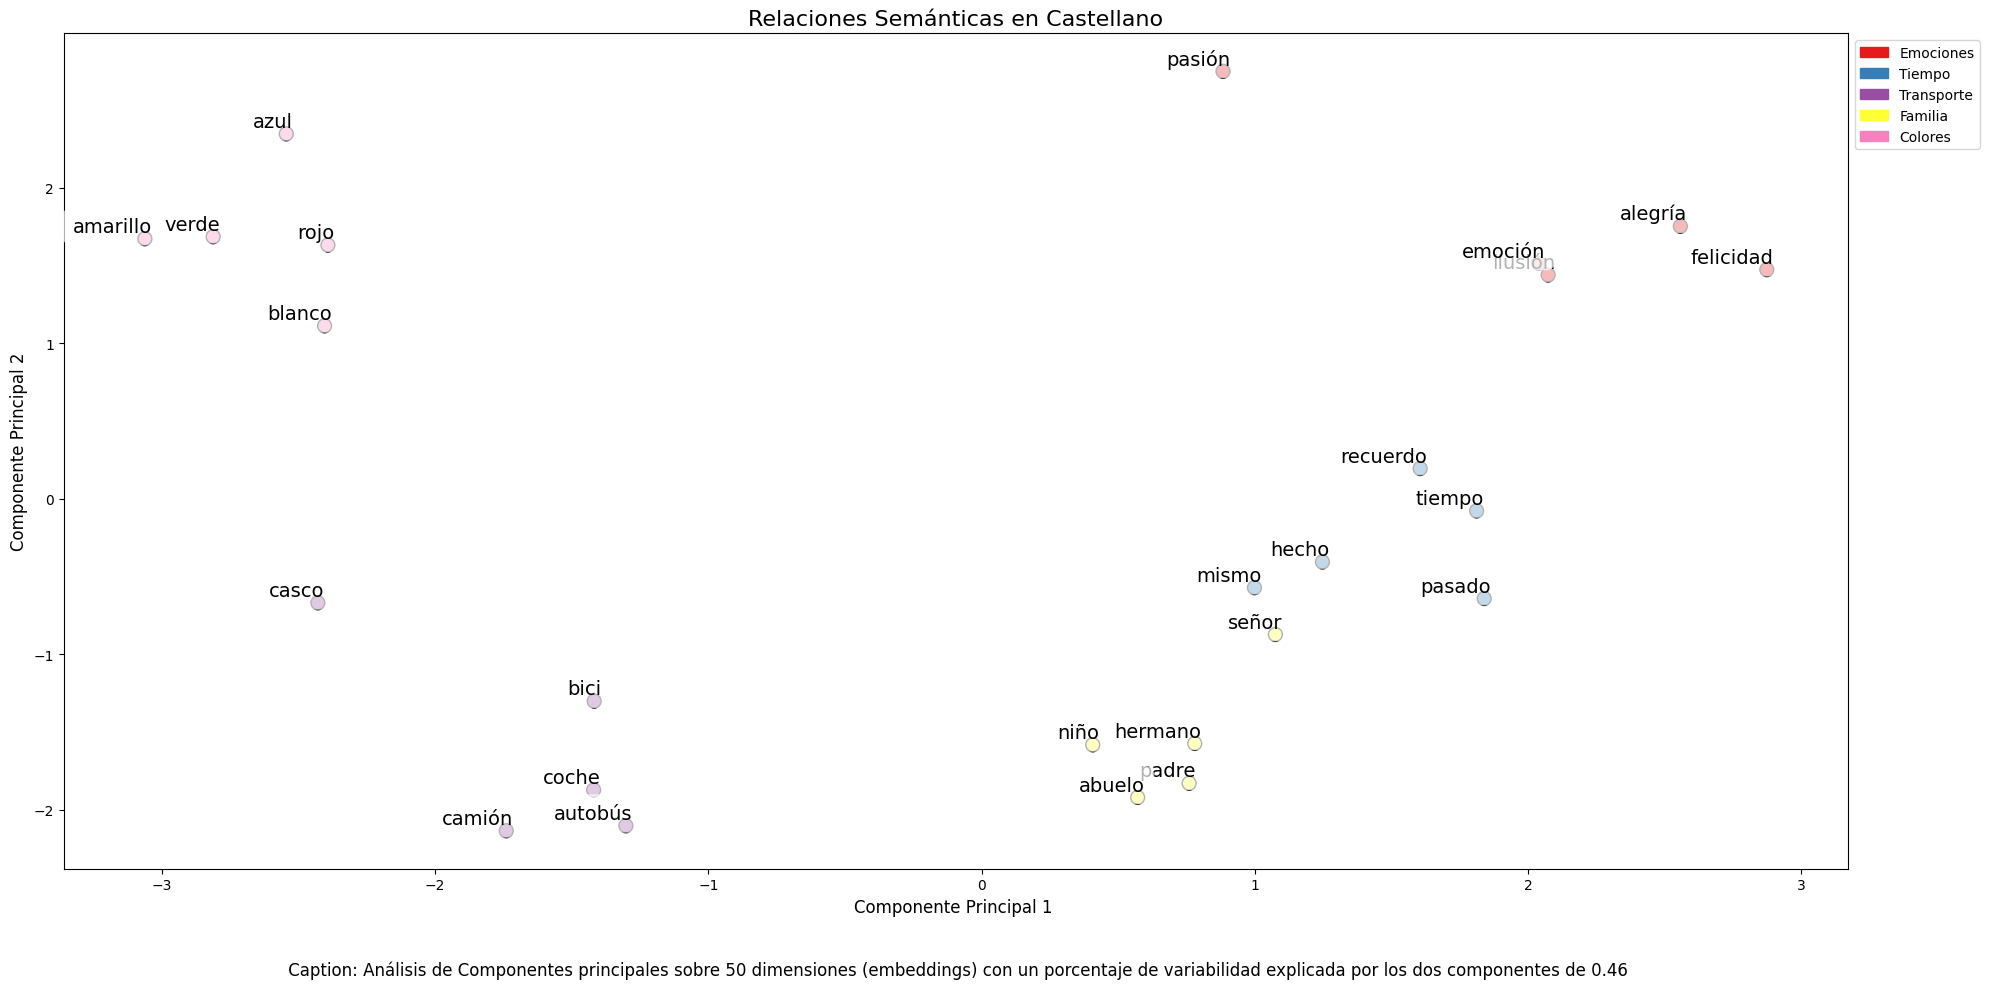
Finalmente, se han aplicado técnicas de reducción de dimensionalidad sobre una muestra representativa de 40 palabras en español, permitiendo visualizar las relaciones semánticas en un espacio bidimensional. Los resultados revelaron patrones de agrupación natural entre términos semánticamente relacionados, como se observa en la figura:
Figura 1. Análisis de Componentes principales sobre 50 dimensiones (embeddings) con un porcentaje de variabilidad explicada por los dos componentes de 0.46
- Los términos relacionados con familia (padre, hermano, abuelo) se concentran en la parte inferior.
- Los medios de transporte (coche, autobús, camión) forman un grupo distintivo.
- Los colores (azul, verde, rojo) aparecen próximos entre sí.
Para sistematizar este proceso de evaluación, se ha desarrollado una función unificada que encapsula todas las pruebas descritas anteriormente. Esta arquitectura modular permite evaluar de manera automática y reproducible diferentes modelos de embeddings pre-entrenados, facilitando así la comparación objetiva de su rendimiento en el procesamiento del lenguaje castellano. La estandarización de estas pruebas no solo optimiza el proceso de evaluación, sino que también establece un marco consistente para futuras comparaciones y validaciones de nuevos modelos por parte del público.
La buena capacidad para capturar relaciones semánticas en el lenguaje castellano es la que aprovechamos en nuestro sistema de recomendación de etiquetas.
Sistema de recomendación basado en embeddings
Aprovechando las propiedades de los embeddings, desarrollamos un sistema de recomendación de etiquetas que sigue un proceso de tres fases:
Generación de embeddings: para cada conjunto de datos del portal, generamos una representación vectorial combinando el título y la descripción. Esto nos permite comparar datasets por su similitud semántica.
Identificación de datasets similares: utilizando la similitud coseno entre los vectores, identificamos los conjuntos de datos más similares semánticamente.
Extracción y estandarización de etiquetas: a partir de los conjuntos similares, extraemos sus etiquetas asociadas y las mapeamos con términos del tesauro Eurovoc. Este tesauro, desarrollado por la Unión Europea, es un vocabulario controlado multilingüe que proporciona una terminología estandarizada para la catalogación de documentos y datos en el ámbito de las políticas europeas. Aprovechando nuevamente la potencia de los embeddings, identificamos los términos de Eurovoc semánticamente más cercanos a nuestras etiquetas, garantizando así una estandarización coherente y una mejor interoperabilidad entre sistemas de información europeos.
Los resultados muestran que el sistema es capaz de generar recomendaciones de etiquetas coherentes y estandarizadas. Para ilustrar el funcionamiento del sistema, tomemos el caso del conjunto de datos “Agenda de Actividades Ciudad de Tarragona”:
Figura 2. Agenda de Actividades Ciudad de Tarragona
El sistema:
Encuentra conjuntos de datos similares como "Agenda de actividades de Terrassa" y "Agenda cultural de Barcelona".
Identifica etiquetas comunes de estos conjuntos de datos, como "EXPOSICIONES", "TEATRO" y "CULTURA".
Sugiere términos Eurovoc relacionados: "turismo cultural", "promoción cultural" e "industria cultural".
Ventajas del enfoque
Este enfoque ofrece ventajas significativas:
Recomendaciones Contextuales: el sistema sugiere etiquetas basándose en el significado real del contenido, no solo en coincidencias textuales.
Estandarización Automática: la integración con Eurovoc garantiza un vocabulario controlado y coherente.
Mejora Continua: el sistema aprende y mejora sus recomendaciones a medida que se añaden nuevos datasets.
Interoperabilidad: el uso de Eurovoc facilita la integración con otros sistemas europeos.
Conclusiones
Este ejercicio demuestra el gran potencial de los embeddings como herramienta para la asociación de textos en función de su naturaleza semántica. A través del caso práctico analizado, se ha podido observar cómo, mediante la identificación de títulos y descripciones similares entre datasets, es posible generar recomendaciones precisas de etiquetas o keywords. Estas etiquetas, a su vez, pueden vincularse con palabras clave de un tesauro estandarizado como Eurovoc, aplicando el mismo principio.
A pesar de los retos que pueden surgir, la implementación de este tipo de sistemas en entornos de producción presenta una valiosa oportunidad para mejorar la organización y recuperación de información. La precisión en la asignación de etiquetas puede verse influenciada por diversos factores interrelacionados del proceso:
La especificidad de los títulos y descripciones de los datasets es fundamental, ya que de ella depende una correcta identificación de contenidos similares y, por tanto, una adecuada recomendación de etiquetas.
La calidad y representatividad de las etiquetas existentes en los datasets similares determina directamente la relevancia de las recomendaciones generadas.
La cobertura temática del tesauro Eurovoc, que, si bien es extensa, puede no abarcar términos específicos necesarios para describir ciertos datasets de manera precisa.
La capacidad de los vectores para capturar fielmente las relaciones semánticas entre los contenidos, lo cual impacta directamente en la precisión de las etiquetas asignadas.
Para aquellos que deseen profundizar en el tema, existen otras aproximaciones interesantes al uso de embeddings que complementan lo visto en este ejercicio, tales como:
Utilización de modelos de embeddings más complejos y computacionalmente costosos (como BERT, GPT, etc.).
Entrenamiento de modelos en un corpus propio adaptado al dominio.
Aplicación de técnicas más profundas de limpieza de datos.
En resumen, este ejercicio no solo demuestra la eficacia de los embeddings para la recomendación de etiquetas, sino que abre la puerta a que el lector explore todas las posibilidades que esta poderosa herramienta ofrece.
Turismo
Ciencia e tecnoloxía
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar, de manera sencilla y efectiva, la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas como los gráficos de líneas, de barras o métricas relevantes, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos haciendo uso de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos, se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis pertinentes para, finalmente obtener unas conclusiones a modo de resumen de dicha información.
En cada ejercicio práctico se utilizan desarrollos de código documentados y herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio de GitHub de datos.gob.es.
En este ejercicio concreto, exploraremos los flujos de turistas a nivel nacional, creando visualizaciones de los turistas que se mueven entre las comunidades autónomas (CCAA) y provincias.
Accede al repositorio del laboratorio de datos en Github
Accede al notebook de Google Colab
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
2. Contexto
Analizar los flujos de turistas nacionales nos permite observar ciertos movimientos ya muy conocidos, como, por ejemplo, que la provincia de Alicante es un destino muy popular del turismo veraniego. Además, este análisis es interesante para observar tendencias en el impacto económico que el turismo pueda tener, año tras año, en ciertas CCAA o provincias. El artículo sobre experiencias para la gestión de los flujos de visitantes en destinos turísticos ilustra el impacto de los datos en el sector.
3. Objetivo
El objetivo principal del ejercicio es crear visualizaciones interactivas en Python que permitan visualizar información compleja de manera comprensible y atractiva. Se cumplirá este objetivo usando un conjunto de datos abiertos que contiene información sobre flujos de turistas nacionales, planteando varias preguntas sobre los datos y contestándolas gráficamente. Podremos responder a preguntas como las que se plantean a continuación:
¿En qué CCAA hay más turismo procedente de la misma CA?
¿Cuál es la CA que más sale de su propia CA?
¿Qué diferencias hay entre los flujos de turistas a lo largo del año?
¿Cuál es la provincia valenciana que más turistas recibe?
La comprensión de las herramientas propuestas aportará al lector la capacidad para poder modificar el código contenido en el notebook que acompaña a este ejercicio para seguir explorando los datos por su cuenta y detectar más comportamientos interesantes a partir del conjunto de datos utilizado.
Para poder crear visualizaciones interactivas y contestar a las preguntas sobre los flujos de turistas, será necesario un proceso de limpieza y reformateado de datos que está descrito en el notebook que acompaña este ejercicio.
4. Recursos
Conjunto de datos
El conjunto de datos abiertos utilizado contiene información sobre los flujos de turistas en España a nivel de CCAA y provincias, indicando también los valores totales a nivel nacional. El conjunto de datos ha sido publicado por el Instituto Nacional de Estadística, a través de varios tipos de ficheros. Para el presente ejercicio utilizamos únicamente el fichero .csv separado por “;”. Los datos datan de julio de 2019 a marzo de 2024 (a la hora de redactar este ejercicio) y se actualizan mensualmente.
Número de turistas por CCAA y provincia de destino desagregados por PROVINCIA de origen
El conjunto de datos también se encuentra disponible para su descarga en este repositorio de Github.
Herramientas analíticas
Para la limpieza de los datos y la creación de las visualizaciones se ha utilizado el lenguaje de programación Python. El código creado para este ejercicio se pone a disposición del lector a través de un notebook de Google Colab.
Las librerías de Python que utilizaremos para llevar a cabo el ejercicio son:
pandas: es una librería que se utiliza para el análisis y manipulación de datos.
holoviews: es una librería que permite crear visualizaciones interactivas, combinando las funcionalidades de otras librerías como Bokeh y Matplotlib.
5. Desarrollo del ejercicio
Para visualizar los datos sobre flujos de turistas interactivamente crearemos dos tipos de diagramas, los diagramas de cuerdas y los diagramas de Sankey.
Los diagramas de cuerdas son un tipo de diagrama que está compuesto por nodos y aristas, véase la figura 1. Los nodos se sitúan en un círculo y las aristas simbolizan las relaciones entre los nodos del círculo. Estos diagramas suelen utilizarse para mostrar tipos de flujos, por ejemplo, flujos migratorios o monetarios. El volumen diferente de las aristas se visualiza de manera comprensible y refleja la importancia de un flujo o de un nodo. Por su forma de círculo, el diagrama de cuerdas es una buena opción para visualizar las relaciones entre todos los nodos de nuestro análisis (relación del tipo “varios a varios”).
Figura 1. Diagrama de cuerdas (Migración global). Fuente.
Los diagramas de Sankey, igual que los diagramas de cuerdas, son un tipo de diagrama que está compuesto por nodos y aristas, véase la figura 2. Los nodos se representan en los márgenes de la visualización, estando las aristas entre los márgenes. Por esta agrupación lineal de los nodos, los diagramas de Sankey son mejores que los diagramas de cuerdas para análisis en los cuales queramos visualizar la relación entre:
varios nodos y otros nodos (tipo varios a varios, o varios a pocos, o viceversa)
varios nodos y un solo nodo (varios a uno, o viceversa)
Figura 2. Diagrama de Sankey (Migración interna Reino Unido). Fuente.
El ejercicio está dividido en 5 partes, siendo la parte 0 (“configuración inicial”) solo de montar el entorno de programación. A continuación, describimos las cinco partes y los pasos que se llevan a cabo.
5.1. Cargar datos
Este apartado podrás encontrarlo en el punto 1 del notebook.
En este parte cargamos el conjunto de datos para poder procesarlo en el notebook. Comprobamos el formato de los datos cargados y creamos un pandas.DataFrame que utilizaremos para el procesamiento de los datos en los siguientes pasos.
5.2. Exploración inicial de los datos
Este apartado podrás encontrarlo en el punto 2 del notebook.
En esta parte realizamos un análisis exploratorio de los datos para entender el formato del conjunto de datos que hemos cargado y para tener una idea más clara de la información que contiene. Mediante esta exploración inicial, podemos definir los pasos de limpieza que tenemos que llevar a cabo para poder crear las visualizaciones interactivas.
Si quieres aprender más sobre cómo abordar esta tarea, tienes a tu disposición esta guía introductoria sobre análisis exploratorio de datos.
5.3. Análisis del formato de los datos
Este apartado podrás encontrarlo en el punto 3 del notebook.
En esta parte resumimos las observaciones que hemos podido hacer durante la exploración inicial de los datos. Recapitulamos aquí las observaciones más importantes:
Provincia de origen
Provincia de origen
CCAA y provincia de destino
CCAA y provincia de destino
CCAA y provincia de destino
Concepto turístico
Periodo
Total
Total Nacional
Total Nacional
Turistas
2024M03
13.731.096
Total Nacional
Ourense
Total Nacional
Andalucía
Almería
Turistas
2024M03
373
Figura 3. Fragmento del conjunto de datos original.
Podemos observar en las columnas uno a cuatro que los orígenes de los flujos de turistas están desagregados por provincia mientras que, para los destinos, las provincias están agregadas por CCAA. Aprovecharemos el mapeado de las CCAA y de sus provincias que podemos extraer de la cuarta y quinta columna para agregar las provincias de origen por CCAA.
También podemos ver que la información contenida en la primera columna a veces es superflua, por lo cual, la combinaremos con la segunda columna. Además, hemos constatado que la quinta y sexta columna no aportan valor para nuestro análisis, por lo cual, las eliminaremos. Renombraremos algunas columnas para tener un pandas. DataFrame más comprensible.
5.4. Limpieza de los datos
Este apartado podrás encontrarlo en el punto 4 del notebook.
En esta parte llevamos a cabo los pasos necesarios para darle mejor formato a nuestros datos. Para ello aprovechamos varias funcionalidades que nos ofrece pandas, por ejemplo, para renombrar las columnas. También definimos una función reutilizable que necesitamos para concatenar los valores de la primera y segunda columna con el objetivo de no tener una columna que exclusivamente indique “Total Nacional” en todas las filas del pandas.DataFrame. Además, extraeremos de las columnas de destino un mapeado de CCAA a provincias que aplicaremos a las columnas de origen.
Queremos obtener una versión del conjunto de datos más comprimida con mayor transparencia de los nombres de las columnas y que no contenga información que no vamos a procesar. El resultado final del proceso de limpieza de datos es el siguiente:
Origen
Provincia de origen
Destino
Provincia de destino
Periodo
Total
Total Nacional
Total Nacional
2024M03
13731096.0
Galicia
Ourense
Andalucía
Almería
2024M03
373.0
Figura 4. Fragmento del conjunto de datos limpio.
5.5. Crear visualizaciones
Este apartado podrás encontrarlo en el punto 5 del notebook
En esta parte creamos nuestras visualizaciones interactivas utilizando la librería Holoviews. Para poder dibujar gráficos de cuerdas o de Sankey que visualicen el flujo de personas entre CCAA y CCAA y/o provincias, tenemos que estructurar la información de nuestros datos de tal forma que dispongamos de nodos y aristas. En nuestro caso, los nodos son los nombres de CCAA o provincia y las aristas, es decir, la relación entre los nodos, son el número de turistas. En el notebook definimos una función para obtener los nodos y aristas que podemos reutilizar para los diferentes diagramas que queramos realizar, cambiando el período de tiempo según la estación del año que nos interese analizar.
Vamos a crear primero un diagrama de cuerdas usando exclusivamente los datos sobre flujos de turistas de marzo de 2024. En el notebook, este diagrama de cuerdas es dinámico. Te animamos a probar su interactividad.
Figura 5. Diagrama de cuerdas que muestra el flujo de turistas en marzo 2024 agregado por comunidades autónomas.
En el diagrama de cuerdas se visualizan los flujos de turistas entre todas las CCAA. Cada CA tiene un color y los movimientos que hacen los turistas provenientes de esta CA se simbolizan con el mismo color. Podemos observar que los turistas de Andalucía y Cataluña viajan mucho dentro de sus propias CCAA. En cambio, los turistas de Madrid salen mucho de su propia CA.
Figura 6. Diagrama de cuerdas que muestra el flujo de turistas entrando y saliendo de Andalucía en marzo 2024 agregado por comunidades autónomas.
Creamos otro diagrama de cuerdas utilizando la función que hemos creado y visualizamos los flujos de turistas en agosto de 2023.
Figura 7. Diagrama de cuerdas que muestra el flujo de turistas en agosto 2023 agregado por comunidades autónomas.
Podremos observar que, a grandes rasgos, no cambian los movimientos de los turistas, solo que se intensifican los movimientos que ya hemos podido observar para marzo 2024.
Figura 8. Diagrama de cuerdas que muestra el flujo de turistas entrando y saliendo de la Comunitat Valenciana en agosto 2023 agregado por comunidades autónomas.
El lector puede crear el mismo diagrama para otros períodos de tiempo, por ejemplo, para el verano del año 2020, con el fin de visualizar el impacto de la pandemia en el turismo veraniego, reutilizando la función que hemos creado.
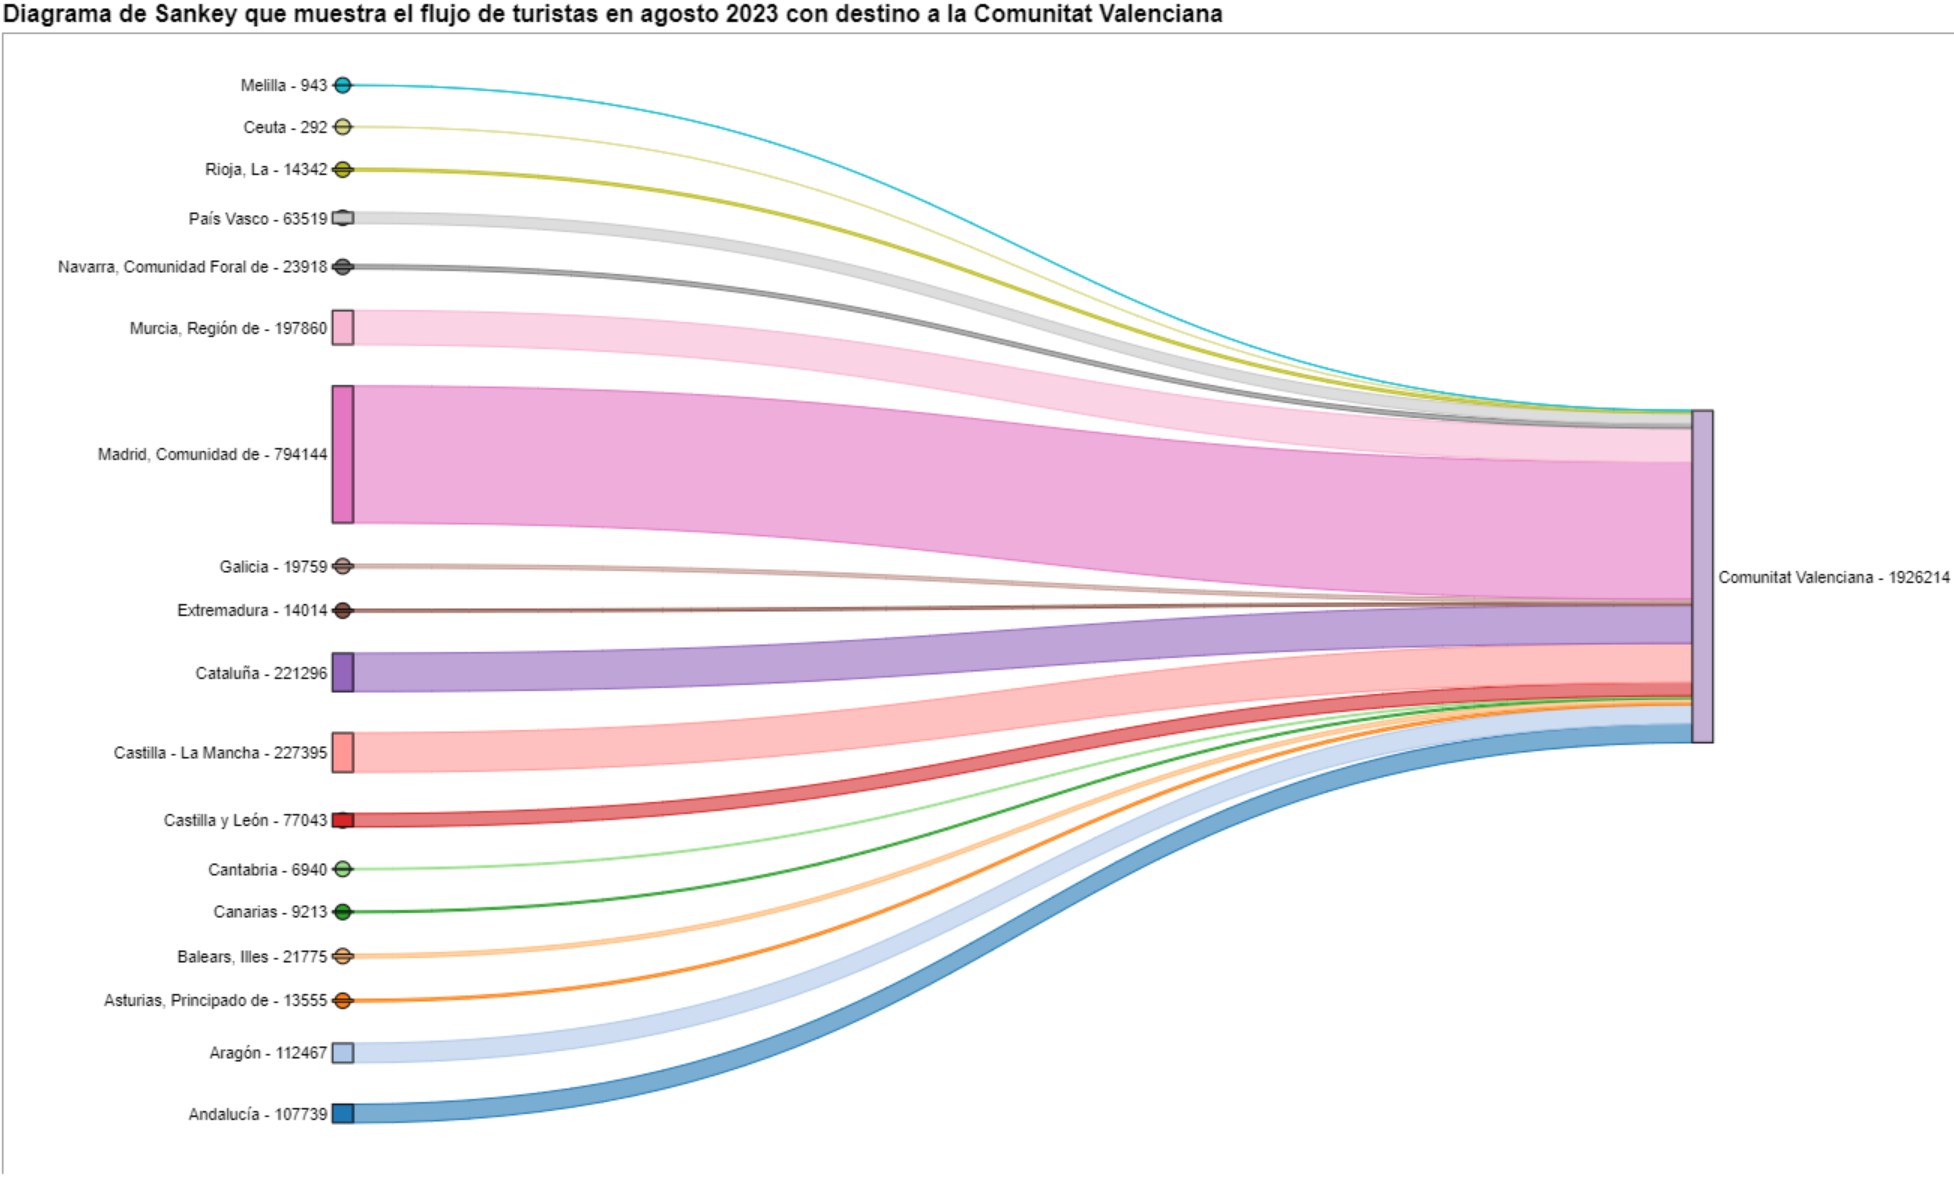
Para los diagramas de Sankey nos vamos a centrar en la Comunitat Valenciana, ya que es un destino vacacional popular. Filtramos las aristas que hemos creado para el diagrama de cuerdas anterior de manera que solo contengan flujos que terminen en la Comunitat Valenciana. El mismo procedimiento se podría aplicar para estudiar cualquier otra CA o se podría invertir para analizar dónde van a veranear los valencianos. Visualizamos el diagrama de Sankey que, igual que los diagramas de cuerdas, es interactivo dentro del notebook. El aspecto visual quedaría así:
Figura 9. Diagrama de Sankey que muestra el flujo de turistas en agosto 2023 con destino a la Comunitat Valenciana.
Como ya hemos podido intuir por el diagrama de cuerdas de arriba, véase la figura 8 el mayor grupo de turistas que llegan a la Comunitat Valenciana proviene de Madrid. Vemos que también hay un elevado número de turistas que visitan la Comunitat Valenciana desde las CCAA vecinas como Murcia, Andalucía y Cataluña.
Para comprobar que estas tendencias se dan en las tres provincias de la Comunitat Valenciana, vamos a crear un diagrama de Sankey que muestre en el margen izquierdo todas las CCAA y en el margen derecho las tres provincias de la Comunitat Valenciana.
Para crear este diagrama de Sankey a nivel de provincias tenemos que filtrar nuestro pandas. DataFrame inicial para extraer de él las filas que contienen la información relevante. Los pasos en el notebook se pueden adaptar para realizar este análisis a nivel de provincias para cualquier otra CA. Aunque no estamos reutilizando la función que hemos usado anteriormente, también podemos cambiar el período de análisis.
El diagrama de Sankey que visualiza los flujos de turistas que llegaron en agosto de 2023 a las tres provincias valencianas quedaría así:
Figura 10. Diagrama de Sankey agosto 2023 que muestra el flujo de turistas con destino a provincias de la Comunitat Valenciana.
Podemos observar que, como ya suponíamos, el mayor número de turistas que llega a la Comunitat Valenciana en agosto proviene de la Comunidad de Madrid. Sin embargo, podemos comprobar que esto no es cierto para la provincia de Castellón, donde en agosto de 2023 la mayoría de los turistas fueron valencianos que se desplazaron dentro de su propia CA.
6. Conclusiones del ejercicio
Gracias a las técnicas de visualización empleadas en este ejercicio, hemos podido observar los flujos de turistas que se desplazan dentro del territorio nacional, enfocándonos en hacer comparaciones entre diversas épocas del año y tratando de identificar patrones. Tanto en los diagramas de cuerdas como en los diagramas de Sankey que hemos creado, hemos podido observar la afluencia de los turistas madrileños en las costas valencianas en verano. También hemos podido identificar las comunidades autónomas donde los turistas salen menos de su propia comunidad autónoma, como Cataluña y Andalucía.
7. ¿Quieres realizar el ejercicio?
Invitamos al lector a ejecutar el código contenido en el notebook de Google Colab que acompaña a este ejercicio para seguir con el análisis de los flujos de turistas. Dejamos aquí algunas ideas de posibles preguntas y de cómo se podrían contestar:
El impacto de la pandemia: ya lo hemos mencionado brevemente arriba, pero una pregunta interesante sería medir el impacto que ha tenido la pandemia del coronavirus sobre el turismo. Podemos comparar los datos de los años anteriores con el 2020 y también analizar los años siguientes para detectar tendencias de estabilización. Visto que la función que hemos creado permite cambiar fácilmente el período de tiempo bajo análisis, te proponemos hacer este análisis por tu cuenta.
Intervalos de tiempo: también es posible modificar la función que hemos estado usando de tal manera que no solo permita seleccionar un periodo de tiempo concreto, sino que también permita intervalos de tiempos.
Análisis a nivel de provincias: igualmente, un lector avanzado con Pandas puede imponerse el reto de crear un diagrama de Sankey que visualice a qué provincias viajan los habitantes de una determinada región, por ejemplo, Ourense. Para no tener demasiadas provincias de destino que podrían hacer ilegible el diagrama de Sankey, se podrían visualizar solo las 10 más visitadas. Para obtener los datos para crear esta visualización, el lector tendría que jugar con los filtros que pone sobre el dataset y con el método de groupby de pandas, dejándose inspirar por el código ya ejecutado.
Esperamos que este ejercicio práctico te haya aportado conocimiento suficiente para desarrollar tus propias visualizaciones. Si tienes algún tema sobre ciencia de datos que quieras que tratemos próximamente, no dudes en proponer tu interés a través de nuestros canales de contacto.
Además, recuerda que tienes a tu disposición más ejercicios en el apartado sección de “Ejercicios de ciencia de datos”.
Medio ambiente
Enerxía
Industria
1. Introducción
En la era de la información, la inteligencia artificial ha demostrado ser una herramienta invaluable para una variedad de aplicaciones. Una de las manifestaciones más increíbles de esta tecnología es GPT (Generative Pre-trained Transformer), desarrollado por OpenAI. GPT es un modelo de lenguaje natural que puede entender y generar texto, ofreciendo respuestas coherentes y contextualmente relevantes. Con la reciente introducción de Chat GPT-4, las capacidades de este modelo se han ampliado aún más, permitiendo una mayor personalización y adaptabilidad a diferentes temáticas.
En este post, te mostraremos cómo configurar y personalizar un asistente especializado en minerales críticos utilizando GPT-4 y fuentes de datos abiertas. Como ya mostramos en previas publicaciones, los minerales críticos son fundamentales para numerosas industrias, incluyendo la tecnología, la energía y la defensa, debido a sus propiedades únicas y su importancia estratégica. Sin embargo, la información sobre estos materiales puede ser compleja y dispersa, lo que hace que un asistente especializado sea particularmente útil.
El objetivo de este post es guiarte paso a paso desde la configuración inicial hasta la implementación de un asistente GPT que pueda ayudarte a resolver dudas y proporcionar información valiosa sobre minerales críticos en tu día a día. Además, exploraremos cómo personalizar aspectos del asistente, como el tono y el estilo de las respuestas, para que se adapte perfectamente a tus necesidades. Al final de este recorrido, tendrás una herramienta potente y personalizada que transformará la manera en que accedes y utilizas la información en abierto sobre minerales críticos.
Accede al repositorio del laboratorio de datos en GitHub
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
2. Contexto
La transición hacia un futuro sostenible no solo implica cambios en las fuentes de energía, sino también en los recursos materiales que utilizamos. El éxito de sectores como baterías de almacenamiento de energía, aerogeneradores, paneles solares, electrolizadores, drones, robots, redes de transmisión de datos, dispositivos electrónicos o satélites espaciales, depende enormemente del acceso a las materias primas críticas para su desarrollo. Entendemos que un mineral es crítico cuando se cumplen los siguientes factores:
Sus reservas mundiales son escasas
No existen materiales alternativos que puedan ejercer su función (sus propiedades son únicas o muy singulares)
Son materiales indispensables para sectores económicos clave de futuro, y/o su cadena de suministro es de elevado riesgo
Puedes aprender más sobre los minerales críticos en el post mencionado anteriormente.
3. Objetivo
Este ejercicio se centra en mostrar al lector cómo personalizar un modelo GPT especializado para un caso de uso concreto. Adoptaremos para ello el enfoque “aprender haciendo”, de tal forma que el lector pueda comprender cómo configurar y ajustar el modelo para resolver un problema real y relevante, como el asesoramiento experto en minerales críticos. Este enfoque práctico no solo mejora la comprensión de las técnicas de personalización de modelos de lenguaje, sino que también prepara a los lectores para aplicar estos conocimientos en la resolución de problemas reales, ofreciendo una experiencia de aprendizaje rica y directamente aplicable a sus propios proyectos.
El asistente GPT especializado en minerales críticos estará diseñado para convertirse en una herramienta esencial para profesionales, investigadores y estudiantes. Su objetivo principal será facilitar el acceso a información precisa y actualizada sobre estos materiales, apoyar la toma de decisiones estratégicas y promover la educación en este campo. A continuación, se detallan los objetivos específicos que buscamos alcanzar con este asistente:
Proporcionar información precisa y actualizada:
El asistente debe ofrecer información detallada y precisa sobre diversos minerales críticos, incluyendo su composición, propiedades, usos industriales y disponibilidad.
Mantenerse actualizado con las últimas investigaciones y tendencias del mercado en el ámbito de los minerales críticos.
Asistir en la toma de decisiones:
Proporcionar datos y análisis que puedan ayudar en la toma de decisiones estratégicas en la industria y la investigación sobre minerales críticos.
Ofrecer comparativas y evaluaciones de diferentes minerales en función de su rendimiento, coste y disponibilidad.
Promover la educación y la concienciación en torno a esta temática:
Actuar como una herramienta educativa para estudiantes, investigadores y profesionales, ayudando a mejorar su conocimiento sobre los minerales críticos.
Aumentar la conciencia sobre la importancia de estos materiales y los desafíos relacionados con su suministro y sostenibilidad.
4. Recursos
Para configurar y personalizar nuestro asistente GPT especializado en minerales críticos, es esencial disponer de una serie de recursos que faciliten la implementación y aseguren la precisión y relevancia de las respuestas del modelo. En este apartado, detallaremos los recursos necesarios que incluyen tanto las herramientas tecnológicas como las fuentes de información que serán integradas en la base de conocimiento del asistente.
Herramientas y Tecnologías
Las herramientas y tecnologías clave para desarrollar este ejercicio son:
Cuenta de OpenAI: necesaria para acceder a la plataforma y utilizar el modelo GPT-4. En este post, utilizaremos la suscripción Plus de ChatGPT para mostrarte cómo crear y publicar un GPT personalizado. No obstante, puedes desarrollar este ejercicio de forma similar utilizando una cuenta gratuita de OpenAI y realizando el mismo conjunto de instrucciones a través de una conversación de ChatGPT estándar.
Microsoft Excel: hemos diseñado este ejercicio de forma que cualquier persona sin conocimientos técnicos pueda desarrollarlo de principio a fin. Únicamente nos apoyaremos en herramientas ofimáticas como Microsoft Excel para realizar algunas adecuaciones de los datos descargados.
De forma complementaria, utilizaremos otro conjunto de herramientas que nos permitirán automatizar algunas acciones sin ser estrictamente necesaria su utilización:
Google Colab: es un entorno de Python Notebooks que se ejecuta en la nube, permitiendo a los usuarios escribir y ejecutar código Python directamente en el navegador. Google Colab es especialmente útil para el aprendizaje automático, el análisis de datos y la experimentación con modelos de lenguaje, ofreciendo acceso gratuito a potentes recursos de computación y facilitando la colaboración y el intercambio de proyectos.
Markmap: es una herramienta que visualiza mapas mentales de Markdown en tiempo real. Los usuarios escriben ideas en Markdown y la herramienta las renderiza como un mapa mental interactivo en el navegador. Markmap es útil para la planificación de proyectos, la toma de notas y la organización de información compleja visualmente. Facilita la comprensión y el intercambio de ideas en equipos y presentaciones.
Fuentes de Información
Raw Materials Information System (RMIS): sistema de información sobre materias primas mantenido por el Joint Research Center de la Unión Europea. Proporciona datos detallados y actualizados sobre la disponibilidad, producción y consumo de materias primas en Europa.
Catálogo de informes y datos de la Agencia Internacional de la Energía (IEA en sus siglas en inglés): ofrece un amplio catálogo de informes y datos relacionados con la energía, incluyendo estadísticas sobre producción, consumo y reservas de minerales energéticos y críticos.
Base de datos de minerales del Instituto Geológico y Minero Español (BDMIN): contiene información detallada sobre los minerales y depósitos minerales en España, útil para obtener datos específicos sobre la producción y reservas de minerales críticos en el país.
Con estos recursos, estarás bien equipado para desarrollar un asistente GPT especializado que pueda proporcionar respuestas precisas y relevantes sobre minerales críticos, facilitando la toma de decisiones informadas en este campo.
5. Desarrollo del ejercicio
5.1. Construcción de la base de conocimiento
Para que nuestro asistente GPT especializado en minerales críticos sea verdaderamente útil y preciso, es esencial construir una base de conocimiento sólida y estructurada. Esta base de conocimiento será el conjunto de datos e información que el asistente utilizará para responder a las consultas. La calidad y relevancia de esta información determinarán la eficacia del asistente en proporcionar respuestas precisas y útiles.
Búsqueda de Fuentes de Datos
Comenzamos con la recopilación de fuentes de información que nutrirán nuestra base de conocimiento. No todas las fuentes de información son igualmente fiables. Es fundamental evaluar la calidad de las fuentes identificadas, asegurando que:
La información esté actualizada: la relevancia de los datos puede cambiar con rapidez, especialmente en campos dinámicos como el de los minerales críticos.
La fuente sea confiable y reconocida: es necesario utilizar fuentes de instituciones reconocidas y respetadas en el ámbito académico y profesional.
Los datos sean completos y accesibles: es crucial que los datos sean detallados y que estén accesibles para su integración en nuestro asistente.
En nuestro caso, desarrollamos una búsqueda online en diferentes plataformas y repositorios de información tratando de seleccionar información perteneciente a diversas entidades reconocidas:
Centros de investigación y universidades:
Publican estudios y reportes detallados sobre la investigación y desarrollo de minerales críticos.
Ejemplo: RMIS del Joint Research Center de la Unión Europea.
Instituciones gubernamentales y organismos internacionales:
Estas entidades suelen proporcionar datos exhaustivos y actualizados sobre la disponibilidad y el uso de minerales críticos.
Ejemplo: Agencia Internacional de la Energía (IEA).
Bases de datos especializadas:
Contienen datos técnicos y específicos sobre depósitos y producción de minerales críticos.
Ejemplo: Base de datos de Minerales del Instituto Geológico y Minero español (BDMIN).
Selección y preparación de la información
Nos centraremos ahora en la selección y preparación de la información existente en estas fuentes para asegurar que nuestro asistente GPT pueda acceder a datos precisos y útiles.
RMIS del Joint Research Center de la Unión Europea:
Información seleccionada:
Seleccionamos el informe “Supply chain analysis and material demand forecast in strategic technologies and sectors in the EU – A foresight study”. Se trata de un análisis de la cadena de suministro y la demanda de minerales en tecnologías y sectores estratégicos de la UE. Presenta un estudio detallado de las cadenas de suministro de materias primas críticas y pronostica la demanda de minerales hasta 2050.
Preparación necesaria:
El formato del documento, PDF, permite la ingesta directa de la información por parte de nuestro asistente. No obstante, como se observa en la Figura 1, existe una tabla especialmente relevante en sus páginas 238-240 donde se analiza, para cada mineral, su riesgo de suministro, tipología (estratégico, crítico o no crítico) y las tecnologías clave que lo emplean. Decidimos, por ello, extraer esta tabla a un formato estructurado (CSV), de tal forma que dispongamos de dos piezas de información que pasarán a formar parte de nuestra base de conocimiento.
Figura 1: Tabla de minerales contenida en el PDF de JRC
Para extraer de forma programática los datos contenidos en esta tabla y transformarlos en un formato más fácilmente procesable, como CSV (comma separated values o valores separados por comas), utilizaremos un script de Python que podemos utilizar a través de la plataforma Google Colab (Figura 2).
Figura 2: Script Python para la extracción de datos del PDF de JRC desarrollado en plataforma Google Colab.
A modo de resumen, este script:
Se apoya en la librería de código abierto PyPDF2, capaz de interpretar información contenida en ficheros PDF.
Primero, extrae en formato texto (cadena de caracteres) el contenido de las páginas del PDF donde se encuentra la tabla de minerales eliminando todo el contenido que no se corresponde con la propia tabla.
Posteriormente, recorre, línea a línea, la cadena de caracteres convirtiendo los valores en columnas de una tabla de datos. Sabremos que un mineral es utilizado en una tecnología clave si en la columna correspondiente de dicho mineral encontramos un número 1 (en caso contrario contendrá un 0).
Por último, exporta dicha tabla a un fichero CSV para su posterior utilización.
Agencia Internacional de la Energía (IEA):
Información seleccionada:
Seleccionamos el informe “Global Critical Minerals Outlook 2024”. Este proporciona una visión general de los desarrollos industriales en 2023 y principios de 2024, y ofrece perspectivas a medio y largo plazo para la demanda y oferta de minerales clave para la transición energética. También evalúa los riesgos para la fiabilidad, sostenibilidad y diversidad de las cadenas de suministro de minerales críticos.
Preparación necesaria:
El formato del documento, PDF, nos permite la ingesta directa de la información por parte de nuestro asistente virtual. No realizaremos en este caso ninguna adecuación de la información seleccionada.
Base de Datos de Minerales del Instituto Geológico y Minero Español (BDMIN)
Información seleccionada:
En este caso, utilizamos el formulario para seleccionar los datos existentes en esta base de datos en cuanto a indicios y yacimientos del ámbito de la metalogenia, en particular seleccionamos aquellos con contenido de Litio.
Figura 3: Selección de conjunto de datos en BDMIN.
Preparación necesaria:
Observamos cómo la herramienta web nos permite la visualización online y también la exportación de estos datos en varios formatos. Seleccionamos, por tanto, todos los datos a exportar y haciendo clic en esta opción, descargamos un fichero Excel con la información deseada.
Figura 4: Herramienta de visualización y descarga en BDMIN
Figura 5: Datos descargados BDMIN.
Todos los archivos que componen nuestra base de conocimiento se encuentran GitHub del proyecto, de tal forma que aquel lector que lo desee pueda saltarse la fase de descarga y preparación de la información.
5.2. Configuración y personalización del GPT para minerales críticos
Cuando hablamos de "crear un GPT," en realidad nos estamos refiriendo a la configuración y personalización de un modelo de lenguaje basado en GPT (Generative Pre-trained Transformer) para adaptarlo a un caso de uso específico. En este contexto, no estamos creando el modelo desde cero, sino ajustando cómo el modelo preexistente (como GPT-4 de OpenAI) interactúa y responde dentro de un dominio específico, en este caso, sobre minerales críticos.
En primer lugar, accedemos a la aplicación a través de nuestro navegador y, en caso de no tener una cuenta, seguimos el proceso de registro y login en la plataforma ChatGPT. Como indicamos con anterioridad, para realizar la creación de un GPT paso a paso será necesario disponer de una cuenta Plus. No obstante, aquellos lectores que no dispongan de dicha cuenta, podrán trabajar con una cuenta gratuita interactuando con ChatGPT a través de una conversación estándar.
Figura 6: Página de inicio de sesión y registro de ChatGPT.
Una vez iniciada la sesión, seleccionamos la opción "Explorar GPT", y posteriormente hacemos clic en "Crear" para comenzar el proceso de creación de nuestro GPT.
Figura 7: Creación de nuevo GPT.
En pantalla se nos mostrará la pantalla dividida de creación de un nuevo GPT: a la izquierda podremos conversar con el sistema para indicarle las características que debe tener nuestro GPT, mientras que a la izquierda podremos interactuar con nuestro GPT para validar que su comportamiento es el adecuado según vayamos avanzando en el proceso de configuración.
Figura 8: Pantalla de creación de nuevo GPT.
En el GitHub de este proyecto, podemos encontrar todos los prompts o instrucciones que utilizaremos para configurar y personalizar nuestro GPT y que deberemos introducir de forma secuencial en la pestaña "Crear", situada en la pestaña izquierda de nuestras pantallas, para completar los pasos que se detallan a continuación.
Los pasos que vamos a seguir para la creación del GPT son:
En primer lugar, le indicaremos el objetivo y las consideraciones básicas a nuestro GPT para que pueda entender su modo de empleo.
Figura 9: Instrucciones básicas de nuevo GPT.
2. Posteriormente crearemos un nombre y una imagen que representen a nuestro GPT y lo hagan fácilmente identificable. En nuestro caso, lo denominaremos MateriaGuru.
Figura 10: Selección de nombre para nuevo GPT.
Figura 11: Creación de imagen para GPT.
3. A continuación, construiremos la base de conocimiento a partir de la información anteriormente seleccionada y preparada para nutrir los conocimientos de nuestro GPT.
Figura 12: Carga de información a la base de conocimiento de nuevo GPT.
4. Ahora, podemos personalizar aspectos conversacionales como su tono, el nivel de complejidad técnica de sus repuesta o si esperamos respuestas escuetas o elaboradas.
5. Por último, desde la pestaña "Configurar", podemos indicar los iniciadores de conversación deseados para que los usuarios que interactúen con nuestro GPT tengan algunas ideas para empezar la conversación de forma predefinida.
Figura 13: Pestaña Configurar GPT.
En la Figura 13 podemos también observar el resultado definitivo de nuestro entrenamiento, donde aparecen elementos clave como su imagen, nombre, instrucciones, iniciadores de conversación o documentos que forma parte de su base de conocimiento.
5.3. Validación y publicación de GPT
Antes de dar por bueno a nuestro nuevo asistente basado en GPT, procederemos a realizar una breve validación de su correcta configuración y aprendizaje respecto a la temática en torno a la que le hemos entrenado. Para ello, preparamos una batería de preguntas que le realizaremos para comprobar que responde de forma adecuada ante un escenario real de utilización.
#
Pregunta
Respuesta
1
¿Qué minerales críticos han experimentado una caída significativa en los precios en 2023?
Los precios de los minerales para baterías vieron particularmente grandes caídas con los precios del litio cayendo un 75% y los precios del cobalto níquel y grafito cayendo entre un 30% y un 45%.
2
¿Qué porcentaje de la capacidad solar fotovoltaica (PV) mundial fue añadido por China en 2023?
China representó el 62% del aumento en la capacidad solar fotovoltaica global en 2023.
3
¿Cuál es el escenario que proyecta que las ventas de autos eléctricos (EV) alcanzarán el 65% en 2030?
El escenario de emisiones netas cero (NZE) para 2050 proyecta que las ventas de autos eléctricos alcanzarán el 65% en 2030.
4
¿Cuál fue el crecimiento de la demanda de litio en 2023?
La demanda de litio aumentó en un 30% en 2023.
5
¿Qué país fue el mayor mercado de autos eléctricos en 2023?
China fue el mayor mercado de autos eléctricos en 2023 con 8.1 millones de ventas de autos eléctricos representando el 60% del total global.
6
¿Cuál es el principal riesgo asociado con la concentración de mercado en la cadena de suministro de grafito para baterías?
Más del 90% del grafito de grado batería y el 77% de las tierras raras refinadas en 2030 se originan en China lo que representa un riesgo significativo para la concentración del mercado.
7
¿Qué proporción de la capacidad mundial de producción de celdas de batería estaba en China en 2023?
China poseía el 85% de la capacidad de producción de celdas de batería en 2023.
8
¿Cuánto aumentó la inversión en minería de minerales críticos en 2023?
La inversión en minería de minerales críticos creció un 10% en 2023.
9
¿Qué porcentaje de la capacidad de almacenamiento de baterías en 2023 estaba compuesto por baterías de fosfato de hierro y litio (LFP)?
En 2023, las baterías LFP constituían aproximadamente el 80% del mercado total de almacenamiento de baterías.
10
¿Cuál es el pronóstico para la demanda de cobre en un escenario de emisiones netas cero (NZE) para 2040?
En el escenario de emisiones netas cero (NZE) para 2040 se espera que la demanda de cobre tenga el mayor aumento en términos de volumen de producción.
Figura 14: Tabla con batería de preguntas para la validación de nuestro GPT.
Valiéndonos de la parte de previsualización, situada a la derecha de nuestras pantallas, lanzamos la batería de preguntas y validamos que las respuestas se corresponden con aquellas esperadas.
Figura 15: Validación de respuestas GPT.
Por último, hacemos clic en el botón "Crear" para finalizar el proceso. Podremos seleccionar entre diferentes alternativas para restringir su utilización por parte de otros usuarios.
Figura 16: Publicación de nuestro GPT.
6. Escenarios de uso
En este apartado mostramos varios escenarios en los que podremos sacar partido a MateriaGuru en nuestro día a día. En el GitHub del proyecto podremos encontrar los prompts utilizados para replicar cada uno de ellos.
6.1. Consulta de información de minerales críticos
El escenario más típico de utilización de este tipo de GPTs es la asistencia para resolución de dudas relacionadas con la temática en cuestión, en este caso, los minerales críticos. A modo de ejemplo, hemos preparado una batería de cuestiones que el lector podrá plantear al GPT creado para comprender en mayor detalle la relevancia y situación actual de un material crítico como es el grafito a partir de los informes provistos a nuestro GPT.
Figura 17: Resolución de dudas de minerales críticos.
También podemos plantearle preguntas concretas sobre la información tabulada provista respecto a los yacimientos e indicios existentes en el territorio español.
Figura 18: Reservas de litio en Extremadura.
6.2. Representación de visualizaciones de datos cuantitativos
Otro escenario común, es la necesidad de consultar información cuantitativa y realizar representaciones visuales para su mejor entendimiento. En este escenario, podemos observar cómo MateriaGuru es capaz de generar una visualización interactiva de la producción de grafito en toneladas de los principales países productores.
Figura 19: Generación de visualización interactiva con nuestro GPT.
6.3. Generación de mapas mentales para facilitar la comprensión
Por último, en línea con la búsqueda de alternativas para un mejor acceso y comprensión del conocimiento existente en nuestro GPT, plantearemos a MateriaGuru la construcción de un mapa mental que nos permita entender de una forma visual conceptos clave de los minerales críticos. Para ello, utilizamos la notación abierta Markmap (Markdown Mindmap), que nos permite definir mapas mentales utilizando notación markdown.
Figura 20: Generación de mapas mentales desde nuetro GPT.
Deberemos copiar el código generado e introducirlo en un visualizador de markmap para poder generar el mapa mental deseado. Facilitamos aquí una versión de este código generada por MateriaGuru.
Figura 21: Visualización de mapas mentales.
7. Resultados y conclusiones
En el ejercicio de construcción de un asistente experto utilizando GPT-4, hemos logrado crear un modelo especializado en minerales críticos. Este asistente proporciona información detallada y actualizada sobre minerales críticos, apoyando la toma de decisiones estratégicas y promoviendo la educación en este campo. Primero recopilamos información de fuentes confiables como el RMIS, la Agencia Internacional de la Energía (IEA), y el Instituto Geológico y Minero Español (BDMIN). Posteriormente, procesamos y estructuramos los datos adecuadamente para su integración en el modelo. Las validaciones demostraron que el asistente responde de manera precisa a preguntas relevantes del dominio, facilitando el acceso a su información.
De esta forma, el desarrollo del asistente especializado en minerales críticos ha demostrado ser una solución efectiva para centralizar y facilitar el acceso a información compleja y dispersa.
La utilización de herramientas como Google Colab y Markmap ha permitido una mejor organización y visualización de los datos, aumentando la eficiencia en la gestión del conocimiento. Este enfoque no solo mejora la comprensión y el uso de la información sobre minerales críticos, sino que también prepara a los usuarios para aplicar estos conocimientos en contextos reales.
La experiencia práctica adquirida en este ejercicio es directamente aplicable a otros proyectos que requieran la personalización de modelos de lenguaje para casos de uso específicos.
8. ¿Quieres realizar el ejercicio?
Si quieres replicar este ejercicio, accede a este repositorio donde encontrarás más información (las prompt utilizadas, el código generado por MateriaGuru, etc.)
Además, recuerda que tienes a tu disposición más ejercicios en el apartado sección de “Visualizaciones paso a paso”.
Contenido elaborado por Juan Benavente, ingeniero superior industrial y experto en Tecnologías ligadas a la economía del dato. Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor.
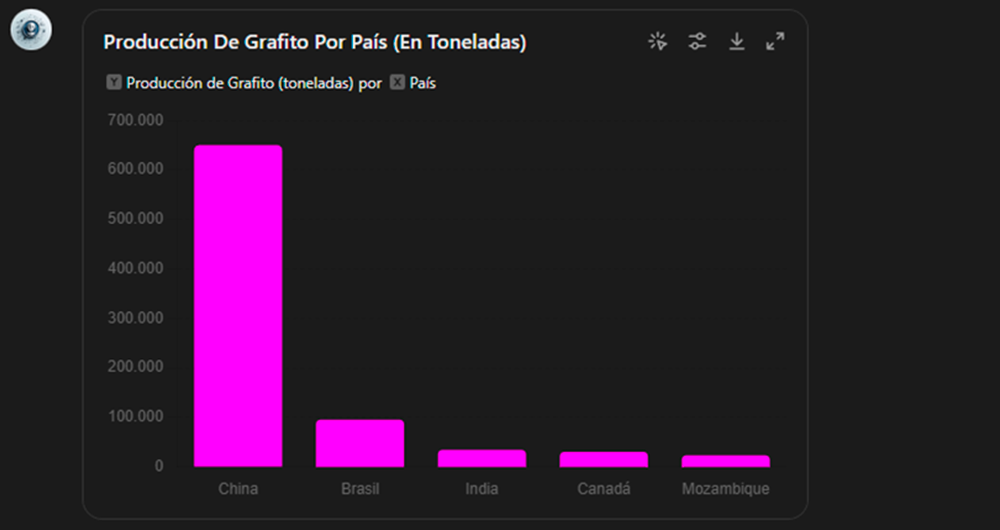
Medio ambiente
Transporte
Economía
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar, de manera sencilla y efectiva, la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas como los gráficos de líneas, de barras o métricas relevantes, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de "Visualizaciones paso a paso" estamos presentando periódicamente ejercicios prácticos haciendo uso de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis pertinentes para, finalmente obtener unas conclusiones a modo de resumen de dicha información.
En cada ejercicio práctico se utilizan desarrollos de código documentados y herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio de GitHub de datos.gob.es.
En este ejercicio concreto, exploraremos la actual situación de la penetración de los vehículos eléctricos en España y las perspectivas de futuro de esta tecnología disruptiva en el transporte.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
En este vídeo, el autor te explica que vas a encontrar tanto en el GitHub como en Google Colab.
2. Contexto: ¿Por qué es importante el vehículo eléctrico?
La transición hacia una movilidad más sostenible se ha convertido en una prioridad global, situando al vehículo eléctrico (VE) en el centro de numerosas discusiones sobre el futuro del transporte. En España, esta tendencia hacia la electrificación del parque automovilístico no solo responde a un creciente interés por parte de los consumidores en tecnologías más limpias y eficientes, sino también a un marco regulatorio y de incentivos diseñado para acelerar la adopción de estos vehículos. Con una creciente oferta de modelos eléctricos disponibles en el mercado, los vehículos eléctricos representan una pieza clave en la estrategia del país para reducir las emisiones de gases de efecto invernadero, mejorar la calidad del aire en las ciudades y fomentar la innovación tecnológica en el sector automotriz.
Sin embargo, la penetración de los vehículos eléctricos en el mercado español enfrenta una serie de desafíos, desde la infraestructura de carga hasta la percepción y el conocimiento del consumidor sobre estos vehículos. La expansión de la red de carga, junto con las políticas de apoyo y los incentivos fiscales, son fundamentales para superar las barreras existentes y estimular la demanda. A medida que España avanza hacia sus objetivos de sostenibilidad y transición energética, el análisis de la evolución del mercado de vehículos eléctricos se convierte en una herramienta esencial para entender el progreso realizado y los obstáculos que aún deben superarse.
3. Objetivo
Este ejercicio se centra en mostrar al lector técnicas para el tratamiento, visualización y análisis avanzado de datos abiertos mediante Python. Adoptaremos para ello el enfoque “aprender haciendo”, de tal forma que el lector pueda comprender la utilización de estas herramientas en el contexto de la resolución de un reto real y de actualidad como es el estudio de la penetración del VE en España. Este enfoque práctico no solo mejora la comprensión de las herramientas de ciencia de datos, sino que también prepara a los lectores para aplicar estos conocimientos en la resolución de problemas reales, ofreciendo una experiencia de aprendizaje rica y directamente aplicable a sus propios proyectos.
Las preguntas a las que trataremos de dar respuesta a través de nuestro análisis son:
¿Qué marcas de vehículos lideraron el mercado en 2023?
¿Qué modelos de vehículos fueron los más vendidos en el 2023?
¿Qué cuota de mercado absorbieron los vehículos eléctricos en el 2023?
¿Qué modelos de vehículos eléctricos fueron los más vendidos en el 2023?
¿Cómo han evolucionado las matriculaciones de vehículos a lo largo del tiempo?
¿Observamos algún tipo de tendencia respecto a la matriculación de vehículos eléctricos?
¿Cómo esperamos que evolucionen las matriculaciones de vehículos eléctricos el próximo año?
¿Cuál es la reducción de emisiones de CO2 que podemos esperar gracias a las matriculaciones obtenidas durante el próximo año?
4. Recursos
Para completar el desarrollo de este ejercicio requeriremos el uso de dos categorías de recursos: Herramientas Analíticas y Conjuntos de Datos.
4.1. Conjunto de datos
Para completar este ejercicio utilizaremos un conjunto de datos provisto por la Dirección General de Tráfico (DGT) a través de su portal estadístico, también disponible desde el catálogo Nacional de Datos Abiertos (datos.gob.es). El portal estadístico de la DGT es una plataforma en línea destinada a ofrecer acceso público a una amplia gama de datos y estadísticas relacionadas con el tráfico y la seguridad vial. Este portal incluye información sobre accidentes de tráfico, infracciones, matriculaciones de vehículos, permisos de conducción y otros datos relevantes que pueden ser útiles para investigadores, profesionales del sector y el público en general.
En nuestro caso, utilizaremos su conjunto de datos de matriculaciones de vehículos en España disponibles vía:
Catálogo de Datos Abiertos del Gobierno de España.
Portal estadístico de la DGT.
Aunque durante el desarrollo del ejercicio mostraremos al lector los mecanismos necesarios para su descarga y procesamiento, incluimos en el repositorio de GitHub asociado los datos preprocesados*, de tal forma que el lector pueda proceder directamente al análisis de los mismos en el caso de que lo desee.
*Los datos utilizados en este ejercicio fueron descargados el 04 de marzo de 2024. La licencia aplicable a este conjunto de datos puede encontrarse en https://datos.gob.es/avisolegal.
4.2. Herramientas analíticas
Lenguaje de programación: Python – es un lenguaje de programación ampliamente utilizado en análisis de datos debido a su versatilidad y a la amplia gama de bibliotecas disponibles. Estas herramientas permiten a los usuarios limpiar, analizar y visualizar grandes conjuntos de datos de manera eficiente, lo que hace de Python una elección popular entre los científicos de datos y analistas.
Plataforma: Jupyter Notebooks – es una aplicación web que permite crear y compartir documentos que contienen código vivo, ecuaciones, visualizaciones y texto narrativo. Se utiliza ampliamente para la ciencia de datos, análisis de datos, aprendizaje automático y educación interactiva en programación.
Principales librerías y módulos:
Manipulación de datos: Pandas – es una librería de código abierto que proporciona estructuras de datos de alto rendimiento y fáciles de usar, así como herramientas de análisis de datos.
Visualización de datos:
Matplotlib: es una librería para crear visualizaciones estáticas, animadas e interactivas en Python.
Seaborn: es una librería basada en Matplotlib. Proporciona una interfaz de alto nivel para dibujar gráficos estadísticos atractivos e informativos.
Estadística y algoritmia:
Statsmodels: es una librería que proporciona clases y funciones para la estimación de muchos modelos estadísticos diferentes, así como para realizar pruebas y exploración de datos estadísticos.
Pmdarima: es una librería especializada en la modelización automática de series temporales, facilitando la identificación, el ajuste y la validación de modelos para pronósticos complejos.
5. Desarrollo del ejercicio
Es aconsejable ir ejecutando el Notebook con el código a la vez que se realiza la lectura del post, ya que ambos recursos didácticos son complementarios en las futuras explicaciones
El ejercicio propuesto se divide en cuatro fases principales.
5.1 Configuración inicial
Este apartado podrás encontrarlo en el punto 1 del Notebook.
En este breve primer apartado, configuraremos nuestro Jupyter Notebook y nuestro entorno de trabajo para poder trabajar con el conjunto de datos seleccionado. Importaremos las librerías Python necesarias y crearemos algunos directorios donde almacenaremos los datos descargados.
5.2 Preparación de datos
Este apartado podrás encontrarlo en el punto 2 del Notebook.
Todo análisis de datos requiere una fase de acceso y tratamiento de los mismos hasta obtener los datos adecuados en el formato deseado. En esta fase, descargaremos los datos del portal estadístico y los transformaremos al formato Apache Parquet antes de proceder a su análisis.
Aquellos usuarios que quieran profundizar en esta tarea, tienen a su disposición la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
5.3 Análisis de datos
Este apartado podrás encontrarlo en el punto 3 del Notebook.
5.3.1 Análisis descriptivo
En esta tercera fase, comenzaremos nuestro análisis de datos. Para ello, responderemos las primeras preguntas apoyándonos en herramientas de visualización de datos que además nos permitirán familiarizarnos con los mismos. Mostramos a continuación algunos ejemplos del análisis:
Top 10 Vehículos matriculados en el 2023: En esta visualización representamos los diez modelos de vehículos con mayor número de matriculaciones durante el año 2023, indicando además el tipo de combustión de estos. Las principales conclusiones son:
Los únicos vehículos de fabricación europea que aparecen en el Top 10 son el Arona y el Ibiza de la marca española SEAT. El resto son asiáticos.
Nueve de los diez vehículos están propulsados por Gasolina.
El único vehículo del Top 10 con un tipo de propulsión diferente es el DACIA Sandero GLP (Gas Licuado de Petróleo).
Figura 1. Gráfica "Top 10 Vehículos matriculados en el 2023"
Cuota de mercado por tipo de propulsión: En esta visualización representamos el porcentaje de vehículos matriculado por cada tipo de propulsión (vehículos de gasolina, diésel, eléctricos u otros). Vemos cómo la inmensa mayoría del mercado (>70%) la absorbieron vehículos de gasolina, siendo los diésel la segunda opción, y como los vehículos eléctricos alcanzaron el 5.5%.
Figura 2. Gráfica "Cuota de mercado por tipo de propulsión".
Evolución histórica de las matriculaciones: Esta visualización representa la evolución de las matriculaciones de vehículos en el tiempo. En ella se muestra el número de matriculaciones mensual entre enero de 2015 y diciembre de 2023 distinguiendo entre los tipos de propulsión de los vehículos matriculados.Podemos observar varios aspectos interesantes en este gráfico:
Apreciamos un comportamiento estacional anual, es decir, observamos patrones o variaciones que se repiten a intervalos regulares de tiempo. Vemos cómo recurrentemente en junio/julio aparecen altos niveles de matriculación mientras que en agosto/septiembre decrecen drásticamente. Esto es muy relevante, pues el análisis de series temporales con factor estacional tiene ciertas particularidades.
Es muy notable también la enorme caída de matriculaciones producida durante los primeros meses del COVID.
Vemos también como los niveles de matriculación post-covid son inferiores a los previos.
Por último, podemos observar cómo entre los años 2015 y 2023 la matriculación de vehículos eléctricos va creciendo paulatinamente.
Figura 3. Gráfica "Matriculaciones de vehículos por tipo de propulsión".
Tendencia en la matriculación de vehículos eléctricos: Analizamos ahora por separado la evolución de vehículos eléctricos y no eléctricos utilizando mapas de calor como herramienta visual. Podemos observar comportamientos muy diferenciados entre ambos gráficos. Observamos cómo el vehículo eléctrico presenta una tendencia de incremento de matriculaciones año a año y, a pesar de suponer el COVID un parón en la matriculación de vehículos, los años posteriores han mantenido la tendencia creciente.
Figura 4. Gráfica "Tendencia en la matriculación de vehículos convencionales vs eléctricos".
5.3.2. Analítica predictiva
Para dar respuesta a la última de las preguntas de forma objetiva, utilizaremos modelos predictivos que nos permitan realizar estimaciones respecto a la evolución del vehículo eléctrico en España. Como podemos observar, el modelo construido nos propone una continuación del crecimiento en las matriculaciones esperadas a lo largo del año serán de 70.000, alcanzando valores cercanos a las 8.000 matriculaciones solo en el mes de diciembre del 2024.
Figura 5. Gráfica "Predicción de matriculaciones de vehículos electricos".
5. Conclusiones del ejercicio
Como conclusión del ejercicio, podremos observar gracias a las técnicas de análisis empleadas como el vehículo eléctrico está penetrando cada vez a mayor velocidad en el parque móvil español aunque aún se encuentre a una distancia grande de otras alternativas como el Diésel o la Gasolina, por ahora liderado por el fabricante Tesla. Veremos en los próximos años si el ritmo crece al nivel necesario para alcanzar los objetivos de sostenibilidad fijados y si Tesla sigue siendo líder a pesar de la fuerte entrada de competidores asiáticos.
6. ¿Quieres realizar el ejercicio?
Si quieres conocer más sobre el Vehículo Eléctrico y poner a prueba tus capacidades analíticas, accede a este repositorio de código donde podrás desarrollar este ejercicio paso a paso.
Además, recuerda que tienes a tu disposición más ejercicios en el apartado sección de “Visualizaciones paso a paso”.
Contenido elaborado por Juan Benavente, ingeniero superior industrial y experto en Tecnologías ligadas a la economía del dato.Los contenidos y los puntos de vista reflejados en esta publicación son responsabilidad exclusiva de su autor.
Enerxía
Ciencia e tecnoloxía
Urbanismo e infraestruturas
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar, de manera sencilla y efectiva, la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas como los gráficos de líneas, de barras o métricas relevantes, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos haciendo uso de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis que resulten pertinentes para, finalmente obtener unas conclusiones a modo de resumen de dicha información.
En cada uno de estos ejercicios prácticos, se utilizan desarrollos de código convenientemente documentados, así como herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio de GitHub de datos.gob.es.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
2. Objetivo
El principal objetivo de este ejercicio es mostrar cómo realizar, de una forma didáctica, un análisis predictivo de series temporales partiendo de datos abiertos sobre el consumo de electricidad en la ciudad de Barcelona. Para ello realizaremos un análisis exploratorio de los datos, definiremos y validaremos el modelo predictivo, para por último generar las predicciones junto a sus gráficas y visualizaciones correspondientes.
Los análisis predictivos de series temporales son técnicas estadísticas y de aprendizaje automático que se utilizan para prever valores futuros en conjuntos de datos que se recopilan a lo largo del tiempo. Estas predicciones se basan en patrones y tendencias históricas identificadas en la serie temporal, siendo su objetivo principal anticipar cambios y eventos en función de datos pasados.
El conjunto de datos abiertos inicial consta de registros desde el año 2019 hasta el año 2022 ambos inclusive, por otra parte, las predicciones las realizaremos para el año 2023, del cual no tenemos datos reales.
Una vez realizado el análisis, podremos contestar a preguntas como las que se plantean a continuación:
¿Cuál es la predicción futura de consumo eléctrico?
¿Cómo de preciso ha sido el modelo con la predicción de datos ya conocidos?
¿Qué días tendrán un consumo máximo y mínimo según las predicciones futuras?
¿Qué meses tendrán un consumo medio máximo y mínimo según las predicciones futuras?
Estas y otras muchas preguntas pueden ser resueltas mediante las visualizaciones obtenidas en el análisis que mostrarán la información de una forma ordenada y sencilla de interpretar.
3. Recursos
3.1. Conjuntos de datos
Los conjuntos de datos abiertos utilizados contienen información sobre el consumo eléctrico en la ciudad de Barcelona en los últimos años. La información que aportan es el consumo en (MWh) desglosados por día, sector económico, código postal y tramo horario.
Estos conjuntos de datos abiertos son publicados por el Ayuntamiento de Barcelona en el catálogo de datos.gob.es, mediante ficheros que recogen los registros de forma anual. Cabe destacar que el publicador actualiza estos conjuntos de datos con nuevos registros con frecuencia, por lo que hemos utilizado solamente los datos proporcionados desde el 2019 hasta el 2022 ambos inclusive.
Series anuales de consumo eléctrico (MWh) en la ciudad de Barcelona.
Estos conjuntos de datos también se encuentran disponibles para su descarga en el siguiente repositorio de GitHub.
3.2. Herramientas
Para la realización del análisis se ha utilizado el lenguaje de programación Python escrito sobre un Notebook de Jupyter alojado en el servicio en la nube de Google Colab.
"Google Colab" o, también llamado Google Colaboratory, es un servicio en la nube de Google Research que permite programar, ejecutar y compartir código escrito en Python o R sobre un Jupyter Notebook desde tu navegador, por lo que no requiere configuración. Este servicio es gratuito.
Para la creación de las visualizaciones interactivas se ha usado la herramienta Looker Studio.
"Looker Studio", antiguamente conocido como Google Data Studio, es una herramienta online que permite realizar visualizaciones interactivas que pueden insertarse en sitios web o exportarse como archivos.
Si quieres conocer más sobre herramientas que puedan ayudarte en el tratamiento y la visualización de datos, puedes recurrir al informe "Herramientas de procesado y visualización de datos".
4. Análisis predictivo de series temporales
El análisis predictivo de series temporales es una técnica que utiliza datos históricos para predecir valores futuros de una variable que cambia con el tiempo. Las series temporales son datos que se recopilan en intervalos regulares, como días, semanas, meses o años. No es el objetivo de este ejercicio explicar en detalle las características de las series temporales, ya que nos centramos en explicar brevemente el modelo de predicción. No obstante, si quieres saber más al respecto, puedes consultar el siguiente manual.
Este tipo de análisis se basa en el supuesto de que los valores futuros de una variable estarán correlacionados con los valores históricos. Utilizando técnicas estadísticas y de aprendizaje automático, se pueden identificar patrones en los datos históricos y utilizarlos para predecir valores futuros.
El análisis predictivo realizado en el ejercicio ha sido dividido en cinco fases; preparación de los datos, análisis exploratorio de los datos, entrenamiento del modelo, validación del modelo y predicción de valores futuros), las cuales se explicarán en los próximos apartados.
Los procesos que te describimos a continuación los encontrarás desarrollados y comentados en el siguiente Notebook ejecutable desde Google Colab junto al código fuente que está disponible en nuestra cuenta de GitHub.
Es aconsejable ir ejecutando el Notebook con el código a la vez que se realiza la lectura del post, ya que ambos recursos didácticos son complementarios en las futuras explicaciones
4.1 Preparación de los datos
Este apartado podrás encontrarlo en el punto 1 del Notebook.
En este apartado se importan los conjuntos de datos abiertos descritos en los puntos anteriores que utilizaremos en el ejercicio, prestando especial atención a su obtención y a la validación de su contenido, asegurándonos que se encuentran en el formato adecuado y consistente para su procesamiento y que no contienen errores que puedan condicionar los pasos futuros.
4.2 Análisis exploratorio de los datos (EDA)
Este apartado podrás encontrarlo en el punto 2 del Notebook.
En este apartado realizaremos un análisis exploratorio de los datos (EDA), con el fin de interpretar adecuadamente los datos de origen, detectar anomalías, datos ausentes, errores u outliers que pudieran afectar a la calidad de los procesos posteriores y resultados.
A continuación, en la siguiente visualización interactiva, podrás inspeccionar la tabla de datos con los valores de consumo históricos generada en el punto anterior pudiendo filtrar por periodo temporal concreto. De esta forma podemos comprender, de una forma visual, la principal información de la serie de datos.
Una vez inspeccionada la visualización interactiva de la serie temporal, habrás observado diversos valores que potencialmente podrían ser considerados como outliers, como se muestra en la siguiente figura. También podemos calcular de forma numérica estos outliers, como se muestra en el notebook.
Figura 1. Outliers de la serie temporal con datos históricos
Una vez evaluados los outliers, para este ejercicio se ha decidido modificar únicamente el registrado en la fecha "2022-12-05". Para ello se sustituirá el valor por la media del registrado el día anterior y el día siguiente.
La razón de no eliminar el resto de outliers es debido a que son valores registrados en días consecutivos, por lo que se presupone que son valores correctos afectados por variables externas que se escapan del alcance del ejercicio. Una vez solucionado el problema detectado con los outliers, esta será la serie temporal de datos que utilizaremos en los siguientes apartados.
Figura 2. Serie temporal de datos históricos una vez tratados los outliers
Si quieres conocer más sobre estos procesos puedes recurrir a la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
4.3 Entrenamiento del modelo
Este apartado podrás encontrarlo en el punto 3 del Notebook.
En primer lugar, creamos dentro de la tabla de datos los atributos temporales (año, mes, día de la semana y trimestre). Estos atributos son variables categóricas que ayudan a garantizar que el modelo sea capaz de capturar con precisión las características y patrones únicos de estas variables. Mediante las siguientes visualizaciones de diagramas de cajas, podemos ver su relevancia dentro de los valores de la serie temporal.
Figura 3. Diagramas de cajas de los atributos temporales generados
Podemos observar ciertos patrones en las gráficas anteriores como los siguientes:
Los días laborales (lunes a viernes) presentan un mayor consumo que los fines de semana.
El año que valores de consumo más bajos presenta es el 2020, esto entendemos que se debe a la reducción de actividad servicios e industrial durante la pandemia.
El mes que mayor consumo presenta es julio, lo cual es entendible debido al uso de aparatos de aire acondicionado.
El segundo trimestre es el que presenta valores más bajos de consumo, destacando abril como el mes con valores más bajos.
A continuación, dividimos la tabla de datos en set de entrenamiento y en set de validación. El set de entrenamiento se utiliza para entrenar el modelo, es decir, el modelo aprende a predecir el valor de la variable objetivo a partir de dicho set, mientras que el set de validación se utiliza para evaluar el rendimiento del modelo, es decir, el modelo se evalúa con los datos de dicho set para determinar su capacidad para predecir los nuevos valores.
Esta división de los datos es importante para evitar el sobreajuste siendo la proporción típica de los datos que se utilizan para el set de entrenamiento de un 70 % y el set de validación del 30% aproximadamente. Para este ejercicio hemos decidido generar el set de entrenamiento con los datos comprendidos entre el "01-01-2019" hasta el "01-10-2021", y el set de validación con los comprendidos entre el "01-10-2021" y el "31-12-2022" como podemos apreciar en la siguiente gráfica.
Figura 4. Serie temporal de datos históricos dividida en set de entrenamiento y set de validación
Para este tipo de ejercicio, tenemos que utilizar algún algoritmo de regresión. Existen diversos modelos y librerías que pueden utilizarse para predicción de series temporales. En este ejercicio utilizaremos el modelo “Gradient Boosting”, modelo de regresión supervisado que se trata de un algoritmo de aprendizaje automático utilizado para predecir un valor continúo basándose en el entrenamiento de un conjunto de datos que contienen valores conocidos para la variable objetivo (en nuestro ejemplo la variable “valor”) y los valores de las variables independientes (en nuestro ejercicio los atributos temporales).
Está basado en árboles de decisión y utiliza una técnica llamada "boosting" para mejorar la precisión del modelo siendo conocido por su eficiencia y capacidad para manejar una variedad de problemas de regresión y clasificación.
Sus principales ventajas son el alto grado de precisión, su robustez y flexibilidad, mientras que alguna de sus desventajas son la sensibilidad a valores atípicos y que requiere una optimización cuidadosa de los parámetros.
Utilizaremos el modelo de regresión supervisado ofrecido en la librería XGBBoost, el cuál puede ajustarse con los siguientes parámetros:
n_estimators: parámetro que afecta al rendimiento del modelo indicando el número de árboles utilizados. Un mayor número de árboles generalmente resulta un modelo más preciso, pero también puede llevar más tiempo de entrenamiento.
early_stopping_rounds: parámetro que controla el número de rondas de entrenamiento que se ejecutarán antes de que el modelo se detenga si el rendimiento en el conjunto de validación no mejora.
learning_rate: controla la velocidad de aprendizaje del modelo. Un valor más alto hará que el modelo aprenda más rápido, pero puede provocar un sobreajuste.
max_depth: controla la profundidad máxima de los árboles en el bosque. Un valor más alto puede proporcionar un modelo más preciso, pero también puede provocar un sobreajuste.
min_child_weight: controla el peso mínimo de una hoja. Un valor más alto puede ayudar a prevenir el sobreajuste.
gamma: controla la cantidad de reducción de la pérdida esperada que se necesita para dividir un nodo. Un valor más alto puede ayudar a prevenir el sobreajuste.
colsample_bytree: controla la proporción de las características que se utilizan para construir cada árbol. Un valor más alto puede ayudar a prevenir el sobreajuste.
subsample: controla la proporción de los datos que se utilizan para construir cada árbol. Un valor más alto puede ayudar a prevenir el sobreajuste.
Estos parámetros se pueden ajustar para mejorar el rendimiento del modelo en un conjunto de datos específico. Se recomienda experimentar con diferentes valores de estos parámetros para encontrar el valor que proporciona el mejor rendimiento en tu conjunto de datos.
Por último, mediante una gráfica de barras observaremos de forma visual la importancia de cada uno de los atributos durante el entrenamiento del modelo. Se puede utilizar para identificar los atributos más importantes en un conjunto de datos, lo que puede ser útil para la interpretación del modelo y la selección de características.
Figura 5. Gráfica de barras con importancia de los atributos temporales
4.4 Entrenamiento del modelo
Este apartado podrás encontrarlo en el punto 4 del Notebook.
Una vez entrenado el modelo, evaluaremos cómo de preciso es para los valores conocidos del set de validación.
Podemos evaluar de forma visual el modelo ploteando la serie temporal con los valores conocidos junto a las predicciones realizadas para el set de validación como se muestra en la siguiente figura.
Figura 6. Serie temporal con los datos del set de validación junto a los de la predicción
También podemos evaluar de forma numérica la precisión del modelo mediante distintas métricas. En este ejercicio hemos optado por utilizar la métrica del error porcentual absoluto medio (MAPE), el cuál ha sido de un 6,58%. La precisión del modelo se considera alta o baja dependiendo del contexto y de las expectativas en dicho modelo, generalmente un MAPE se considera bajo cuando es inferior al 5%, mientras que se considera alto cuando es superior al 10%. En este ejercicio, el resultado de la validación del modelo puede ser considerado un valor aceptable.
Si quieres consultar otro tipo de métricas para evaluar la precisión de modelos aplicados a series temporales, puedes consultar el siguiente enlace.
4.5 Predicciones valores futuros
Este apartado podrás encontrarlo en el punto 5 del Notebook.
Una vez generado el modelo y evaluado su rendimiento MAPE = 6,58 %, pasamos a aplicar dicho modelo al total de datos conocidos, con la finalidad de predecir los valores de consumo eléctrico no conocidos del 2023.
En primer lugar, volvemos a entrenar el modelo con los valores conocidos hasta finales del 2022, sin dividir en set de entrenamiento y validación. Por último, calculamos los valores futuros para el año 2023.
Figura 7. Serie temporal con los datos históricos y la predicción para el 2023
En la siguiente visualización interactiva puedes observar los valores predichos para el año 2023 junto a sus principales métricas, pudiendo filtrar por periodo temporal.
Mejorar los resultados de los modelos predictivos de series temporales es un objetivo importante en la ciencia de datos y el análisis de datos. Varias estrategias que pueden ayudar a mejorar la precisión del modelo del ejercicio son el uso de variables exógenas, la utilización de más datos históricos o generación de datos sintéticos, optimización de los parámetros, …
Debido al carácter divulgativo de este ejercicio y para favorecer el entendimiento de los lectores menos especializados, nos hemos propuesto explicar de una forma lo más sencilla y didáctica posible el ejercicio. Posiblemente se te ocurrirán muchas formas de optimizar el modelo predictivo para lograr mejores resultados, ¡Te animamos a que lo hagas!
5. Conclusiones ejercicio
Una vez realizado el ejercicio, podemos apreciar distintas conclusiones como las siguientes:
Los valores máximos para las predicciones de consumo en el 2023 se dan en la última quincena de julio superando valores de 22.500.000 MWh
El mes con un mayor consumo según las predicciones del 2023 será julio, mientras que el mes con un menor consumo medio será noviembre, existiendo una diferencia porcentual entre ambos del 25,24%
La predicción de consumo medio diario para el 2023 es de 17.259.844 MWh, un 1,46% inferior a la registrada entre los años 2019 y 2022.
Esperemos que este ejercicio te haya resultado útil para el aprendizaje de algunas técnicas habituales en el estudio y análisis de datos abiertos. Volveremos para mostraros nuevas reutilizaciones. ¡Hasta pronto!
Transporte
Deporte
Cultura e lecer
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar de manera sencilla y efectiva la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas, como los gráficos de líneas, de barras o de sectores, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos de visualizaciones de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis que resulten pertinentes para, finalmente, posibilitar la creación de visualizaciones interactivas que nos permitan obtener unas conclusiones finales a modo de resumen de dicha información. En cada uno de estos ejercicios prácticos, se utilizan sencillos desarrollos de código convenientemente documentados, así como herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio Laboratorio de datos de GitHub.
A continuación, y como complemento a la explicación que encontrarás seguidamente, puedes acceder al código que utilizaremos en el ejercicio y que iremos explicando y desarrollando en los siguientes apartados de este post.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
2. Objetivo
El objetivo principal de este ejercicio es mostrar cómo realizar un análisis de redes o de grafos partiendo de datos abiertos sobre viajes en bicicleta de alquiler en la ciudad de Madrid. Para ello, realizaremos un preprocesamiento de los datos con la finalidad de obtener las tablas que utilizaremos a continuación en la herramienta generadora de la visualización, con la que crearemos las visualizaciones del grafo.
Los análisis de redes son métodos y herramientas para el estudio y la interpretación de las relaciones y conexiones entre entidades o nodos interconectados de una red, pudiendo ser estas entidades personas, sitios, productos, u organizaciones, entre otros. Los análisis de redes buscan descubrir patrones, identificar comunidades, analizar la influencia y determinar la importancia de los nodos dentro de la red. Esto se logra mediante el uso de algoritmos y técnicas específicas para extraer información significativa de los datos de red.
Una vez analizados los datos mediante esta visualización, podremos contestar a preguntas como las que se plantean a continuación:
¿Cuál es la estación de la red con mayor tráfico de entrada y de salida?
¿Cuáles son las rutas entre estaciones más frecuentes?
¿Cuál es el número medio de conexiones entre estaciones para cada una de ellas?
¿Cuáles son las estaciones más interconectadas dentro de la red?
Volver al inicio
3. Recursos
3.1. Conjuntos de datos
Los conjuntos de datos abiertos utilizados contienen información sobre los viajes en bicicleta de préstamo realizados en la ciudad de Madrid. La información que aportan se trata de la estación de origen y de destino, el tiempo del trayecto, la hora del trayecto, el identificador de la bicicleta, …
Estos conjuntos de datos abiertos son publicados por el Ayuntamiento de Madrid, mediante ficheros que recogen los registros de forma mensual.
Series mensuales datos estáticos BICIMAD
Estos conjuntos de datos también se encuentran disponibles para su descarga en el siguiente repositorio de GitHub.
Volver al inicio
3.2. Herramientas
Para la realización de las tareas de preprocesado de los datos se ha utilizado el lenguaje de programación Python escrito sobre un Notebook de Jupyter alojado en el servicio en la nube de Google Colab.
"Google Colab" o, también llamado Google Colaboratory, es un servicio en la nube de Google Research que permite programar, ejecutar y compartir código escrito en Python o R sobre un Jupyter Notebook desde tu navegador, por lo que no requiere configuración. Este servicio es gratuito.
Para la creación de la visualización interactiva se ha usado la herramienta Gephi
"Gephi" es una herramienta de visualización y análisis de redes. Permite representar y explorar relaciones entre elementos, como nodos y enlaces, con el fin de entender la estructura y patrones de la red. El programa precisa descarga y es gratuito.
Si quieres conocer más sobre herramientas que puedan ayudarte en el tratamiento y la visualización de datos, puedes recurrir al informe "Herramientas de procesado y visualización de datos".
Volver al inicio
4. Tratamiento o preparación de datos
Los procesos que te describimos a continuación los encontrarás comentados en el Notebook que también podrás ejecutar desde Google Colab.
Debido al alto volumen de viajes registrados en los conjuntos de datos, definimos los siguientes puntos de partida a la hora de analizarlos:
Analizaremos la hora del día con mayor tráfico de viajes
Analizaremos las estaciones con un mayor volumen de viajes
Antes de lanzarnos a analizar y construir una visualización efectiva, debemos realizar un tratamiento previo de los datos, prestando especial atención a su obtención y a la validación de su contenido, asegurándonos que se encuentran en el formato adecuado y consistente para su procesamiento y que no contienen errores.
Como primer paso del proceso, es necesario realizar un análisis exploratorio de los datos (EDA), con el fin de interpretar adecuadamente los datos de partida, detectar anomalías, datos ausentes o errores que pudieran afectar a la calidad de los procesos posteriores y resultados. Si quieres conocer más sobre este proceso puedes recurrir a la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
El siguiente paso es generar la tabla de datos preprocesada que usaremos para alimentar la herramienta de análisis de redes (Gephi) que de forma visual nos ayudará a comprender la información. Para ello modificaremos, filtraremos y uniremos los datos según nuestras necesidades.
Los pasos que se siguen en este preprocesamiento de los datos, explicados en este Notebook de Google Colab, son los siguientes:
Instalación de librerías y carga de los conjuntos de datos
Análisis exploratorio de los datos (EDA)
Generación de tablas preprocesadas
Podrás reproducir este análisis con el código fuente que está disponible en nuestra cuenta de GitHub. La forma de proporcionar el código es a través de un documento realizado sobre un Jupyter Notebook que, una vez cargado en el entorno de desarrollo, podrás ejecutar o modificar de manera sencilla.
Debido al carácter divulgativo de este post y para favorecer el entendimiento de los lectores no especializados, el código no pretende ser el más eficiente sino facilitar su comprensión, por lo que posiblemente se te ocurrirán muchas formas de optimizar el código propuesto para lograr fines similares. ¡Te animamos a que lo hagas!
Volver al inicio
5. Análisis de la red
5.1. Definición de la red
La red analizada se encuentra formada por los viajes entre distintas estaciones de bicicletas en la ciudad de Madrid, teniendo como principal información de cada uno de los viajes registrados la estación de origen (denominada como “source”) y la estación de destino (denominada como “target”).
La red está formada por 253 nodos (estaciones) y 3012 aristas (interacciones entre las estaciones). Se trata de un grafo dirigido, debido a que las interacciones son bidireccionales y ponderado, debido a que cada arista entre los nodos tiene asociado un valor numérico denominado "peso" que en este caso corresponde al número de viajes realizados entre ambas estaciones.
5.2. Carga de la tabla preprocesada en Gephi
Mediante la opción “importar hoja de cálculo” de la pestaña archivo, importamos en formato CSV la tabla de datos previamente preprocesada. Gephi detectará que tipo de datos se están cargando, por lo que utilizaremos los parámetros predefinidos por defecto.
Figura 1. Carga de datos en Gephi
5.3. Opciones de visualización de la red
5.3.1 Ventana de distribución
En primer lugar, aplicamos en la ventana de distribución, el algoritmo Force Atlas 2. Este algoritmo utiliza la técnica de repulsión de nodos en función del grado de conexión de tal forma que los nodos escasamente conectados se separan respecto a los que tiene una mayor fuerza de atracción entre sí.
Para evitar que los componentes conexos queden fuera de la vista principal, fijamos el valor del parámetro "Gravedad en Puesta a punto" a un valor de 10 y para evitar que los nodos queden amontonados, marcamos la opción “Disuadir Hubs” y “Evitar el solapamiento”.
Figura 2. Ventana distribución - algoritmo Force Atlas 2
Dentro de la ventana de distribución, también aplicamos el algoritmo de Expansión con la finalidad de que los nodos no se encuentren tan juntos entre sí mismos.
Figura 3. Ventana distribución - algoritmo de Expansión
5.3.2 Ventana de apariencia
A continuación, en la ventana de apariencia, modificamos los nodos y sus etiquetas para que su tamaño no sea igualitario, sino que dependa del valor del grado de cada nodo (nodos con un mayor grado, mayor tamaño visual). También modificaremos el color de los nodos para que los de mayor tamaño sean de un color más llamativo que los de menor tamaño. En la misma ventana de apariencia modificamos las aristas, en este caso hemos optado por un color unitario para todas ellas, ya que por defecto el tamaño va acorde al peso de cada una de ellas.
Un mayor grado en uno de los nodos implica un mayor número de estaciones conectadas con dicho nodo, mientras que un mayor peso de las aristas implica un mayor número de viajes para cada conexión.
Figura 4. Ventana apariencia
5.3.3 Ventana de grafo
Por último, en la zona inferior de la interfaz de la ventana de grafo, tenemos diversas opciones como activar/desactivar el botón para mostrar las etiquetas de los distintos nodos, adecuar el tamaño de las aristas con la finalizad de hacer más limpia la visualización, modificar el tipo de letra de las etiquetas, …
Figura 5. Opciones ventana de grafo
A continuación, podemos ver la visualización del grafo que representa la red una vez aplicadas las opciones de visualización mencionadas en los puntos anteriores.
Figura 6. Visualización del grafo
Activando la opción de visualizar etiquetas y colocando el cursor sobre uno de los nodos, se mostrarán los enlaces que corresponden al nodo y el resto de los nodos que están vinculados al elegido mediante dichos enlaces.
A continuación, podemos visualizar los nodos y enlaces relativos a la estación de bicicletas “Fernando el Católico". En la visualización se distinguen con facilidad los nodos que poseen un mayor número de conexiones, ya que aparecen con un mayor tamaño y colores más llamativos, como por ejemplo "Plaza de la Cebada" o "Quevedo".
Figura 7. Visualización grafo para la estación "Fernando el Católico"
5.4 Principales medidas de red
Junto a la visualización del grafo, las siguientes medidas nos aportan la principal información de la red analizada. Estas medias, que son las métricas habituales cuando se realiza analítica de redes, podremos calcularlas en la ventana de estadísticas.
Figura 8. Ventana estadísticas
Nodos (N): son los distintos elementos individuales que componen una red, representando entidades diversas. En este caso las distintas estaciones de bicicletas. Su valor en la red es de 243
Enlaces (L): son las conexiones que existen entre los nodos de una red. Los enlaces representan las relaciones o interacciones entre los elementos individuales (nodos) que componen la red. Su valor en la red es de 3014
Número máximo de enlaces (Lmax): es el máximo posible de enlaces en la red. Se calcula mediante la siguiente fórmula Lmax= N(N-1)/2. Su valor en la red es de 31878
Grado medio (k): es una medida estadística para cuantificar la conectividad promedio de los nodos de la red. Se calcula promediando los grados de todos los nodos de la red. Su valor en la red es de 23,8
Densidad de la red (d): indica la proporción de conexiones existentes entre los nodos de la red con respecto al total de conexiones posibles. Su valor en la red es de 0,047
Diámetro (dmax ): es la distancia de grafo más larga entre dos nodos cualquiera de la res, es decir, cómo de lejos están los 2 nodos más alejados. Su valor en la red es de 7
Distancia media (d): es la distancia de grafo media promedio entre los nodos de la red. Su valor en la red es de 2,68
Coeficiente medio de clustering (C): Índica cómo los nodos están incrustados entre sus nodos vecinos. El valor medio da una indicación general de la agrupación en la red. Su valor en la red es de 0,208
Componente conexo: grupo de nodos que están directa o indirectamente conectados entre sí, pero no están conectados con los nodos fuera de ese grupo. Su valor en la red es de 24
5.5 Interpretación de los resultados
La probabilidad de grados sigue de forma aproximada una distribución de larga cola, donde podemos observar que existen unas pocas estaciones que interactúan con un gran número de ellas mientras que la mayoría interactúa con un número bajo de estaciones.
El grado medio es de 23,8 lo que indica que cada estación interacciona de media con cerca de otras 24 estaciones (entrada y salida).
En el siguiente gráfico podemos observar que, aunque tengamos nodos con grados considerados como altos (80, 90, 100, …), se observa que el 25% de los nodos tienen grados iguales o inferiores a 8, mientras que el 75% de los nodos tienen grados inferiores o iguales a 32.
Figura 9. Gráfico de dIstribución de grados
La gráfica anterior se puede desglosar en las dos siguientes correspondientes al grado medio de entrada y de salida (ya que la red es direccional). Vemos que ambas tienen distribuciones de larga cola similares, siendo su grado medio el mismo de 11,9.
Su principal diferencia es que la gráfica correspondiente al grado medio de entrada tiene una mediana de 7 mientras que la de salida es de 9, lo que significa que existe una mayoría de nodos con grados más bajos en los de entrada que los de salida.
Figura 10. Gráficos distribución de grados de entrada y salida
El valor del grado medio con pesos es de 346,07 lo cual nos indica la media de viajes totales de entrada y salida de cada estación.
Figura 11. Gráfico distribución de grados con pesos
La densidad de red de 0,047 es considerada una densidad baja indicando que la red es dispersa, es decir, contiene pocas interacciones entre distintas estaciones en relación con las posibles. Esto se considera lógico debido a que las conexiones entre estaciones estarán limitadas a ciertas zonas debido a la dificultad de llegar a estaciones que se encuentra a largas distancias.
El coeficiente medio de clustering es de 0,208 significando que la interacción de dos estaciones con una tercera no implica necesariamente la interacción entre sí, es decir, no implica necesariamente transitividad, por lo que la probabilidad de interconexión de esas dos estaciones mediante la intervención de una tercera es baja.
Por último, la red presenta 24 componentes conexos, siendo 2 de ellos componentes conexos débiles y 22 componentes conexos fuertes.
5.6 Análisis de centralidad
Un análisis de centralidad se refiere a la evaluación de la importancia de los nodos en una red utilizando diferentes medidas. La centralidad es un concepto fundamental en el análisis de redes y se utiliza para identificar nodos clave o influyentes dentro de una red. Para realizar esta tarea se parte de las métricas calculadas en la ventana de estadísticas.
La medida de centralidad de grado indica que cuanto más alto es el grado de un nodo, más importante es. Las cinco estaciones con valores más elevados son: 1º Plaza de la Cebada, 2º Plaza de Lavapiés, 3º Fernando el Católico, 4º Quevedo, 5º Segovia 45.
Figura 12. Visualización grafo centralidad de grado
La media de centralidad de cercanía indica que cuanto más alto sea el valor de cercanía de un nodo, más central es, ya que puede alcanzar cualquier otro nodo de la red con el menor esfuerzo posible. Las cinco estaciones que valores más elevados poseen son: 1º Fernando el Católico 2º General Pardiñas, 3º Plaza de la Cebada, 4º Plaza de Lavapiés, 5º Puerta de Madrid.
Figura 13. Distribución medida centralidad de cercanía
Figura 14. Visualización grafo centralidad de cercanía
La medida de centralidad de intermediación indica que cuanto mayor sea la medida de intermediación de un nodo, más importante es dado que está presente en más rutas de interacción entre nodos que el resto de los nodos de la red. Las cinco estaciones que valores más elevados poseen son: 1º Fernando el Católico, 2º Plaza de Lavapiés, 3º Plaza de la Cebada, 4º Puerta de Madrid, 5º Quevedo.
Figura 15. Gráfico distribución medida centralidad de intermediación
FIgura 16. Visualización grafo centralidad de intermediación
Con la herramienta Gephi se pueden calcular gran cantidad de métricas y parámetros que no se reflejan en este estudio ,como por ejemplo, la medida de vector propio o distribucción de centralidad "eigenvector".
5.7 Filtros
Mediante la ventana de filtrado, podemos seleccionar ciertos parámetros que simplifiquen las visualizaciones con la finalidad de mostrar información relevante del análisis de redes de una forma más clara visualmente.
Figura 17. Ventana de filtrado
A continuación, mostraremos varios filtrados realizados:
Filtrado de rango (grado), en el que se muestran los nodos con un rango superior a 50, suponiendo un 13,44% (34 nodos) y un 15,41% (464 aristas)
Figura 18. Visualización grafo filtrado de rango (grado)
Filtrado de aristas (peso de la arista), en el que se muestran las aristas con un peso superior a 100, suponiendo un 0,7% (20 aristas)
Figura 19. VIsualización grafo filtrado de arista (peso)
Dentro de la ventana de filtros, existen muchas otras opciones de filtrado sobre atributos, rangos, tamaños de particiones, las aristas, … con los que puedes probar a realizar nuevas visualizaciones para extraer información del grafo. Si quieres conocer más sobre el uso de Gephi, puedes consultar los siguientes cursos y formaciones sobre la herramienta.
6. Conclusiones del ejercicio
Una vez realizado el ejercicio, podemos apreciar las siguientes conclusiones:
Las tres estaciones más interconectadas con otras estaciones son Plaza de la Cebada (133), Plaza de Lavapiés (126) y Fernando el Católico (114).
La estación que tiene un mayor número de conexiones de entrada es la Plaza de la Cebada (78), mientras que la que tiene un mayor número de conexiones de salida es la Plaza de Lavapiés con el mismo número que Fernando el Católico (57)
Las tres estaciones con un mayor número de viajes totales son Plaza de la Cebada (4524), Plaza de Lavapiés (4237) y Fernando el Católico (3526).
Existen 20 rutas con más de 100 viajes. Siendo las 3 rutas con un mayor número de ellos: Puerta de Toledo – Plaza Conde Suchil (141), Quintana Fuente del Berro – Quintana (137), Camino Vinateros – Miguel Moya (134).
Teniendo en cuenta el número de conexiones entre estaciones y de viajes, las estaciones de mayor importancia dentro de la red son: Plaza la Cebada, Plaza de Lavapiés y Fernando el Católico.
Esperemos que esta visualización paso a paso te haya resultado útil para el aprendizaje de algunas técnicas muy habituales en el tratamiento y representación de datos abiertos. Volveremos para mostraros nuevas reutilizaciones. ¡Hasta pronto!
Comercio
Ciencia e tecnoloxía
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar de manera sencilla y efectiva la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas, como los gráficos de líneas, de barras o de sectores, hasta visualizaciones configuradas sobre cuadros de mando interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos de visualizaciones de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y los análisis que resulten pertinentes para, finalmente, posibilitar la creación de visualizaciones interactivas que nos permitan obtener unas conclusiones finales a modo de resumen de dicha información. En cada uno de estos ejercicios prácticos, se utilizan sencillos desarrollos de código convenientemente documentados, así como herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio Laboratorio de datos de GitHub.
A continuación, y como complemento a la explicación que encontrarás seguidamente, puedes acceder al código que utilizaremos en el ejercicio y que iremos explicando y desarrollando en los siguientes apartados de este post.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
2. Objetivo
El objetivo principal de este ejercicio es mostrar como generar un cuadro de mando interactivo que, partiendo de datos abiertos, nos muestre información relevante sobre el consumo en alimentación de los hogares españoles partiendo de datos abiertos. Para ello realizaremos un preprocesamiento de los datos abiertos con la finalidad de obtener las tablas que utilizaremos en la herramienta generadora de las visualizaciones para crear el cuadro de mando interactivo.
Los cuadros de mando son herramientas que permiten presentar información de manera visual y fácilmente comprensible. También conocidos por el témino en inglés "dashboards", son utilizados para monitorizar, analizar y comunicar datos e indicadores. Su contenido suele incluir gráficos, tablas, indicadores, mapas y otros elementos visuales que representan datos y métricas relevantes. Estas visualizaciones ayudan a los usuarios a comprender rápidamente una situación, identificar tendencias, detectar patrones y tomar decisiones informadas.
Una vez analizados los datos, mediante esta visualización podremos contestar a preguntas como las que se plantean a continuación:
¿Cuál es la tendencia de los últimos años en el gasto y del consumo per cápita en los distintos alimentos que componen la cesta básica?
¿Qué alimentos son los más y menos consumidos en los últimos años?
¿En qué Comunidades Autónomas se produce un mayor gasto y consumo en alimentación?
¿El aumento en el coste de ciertos alimentos en los últimos años ha significado una reducción de su consumo?
Éstas, y otras muchas preguntas pueden ser resueltas mediante el cuadro de mando que mostrará información de forma ordenada y sencilla de interpretar.
Volver al inicio
3. Recursos
3.1. Conjuntos de datos
Los conjuntos de datos abiertos utilizados en este ejercicio contienen distinta información sobre el consumo per cápita y el gasto per cápita de los principales grupos de alimentos desglosados por Comunidad Autónoma. Los conjuntos de datos abiertos utilizados, pertenecientes al Ministerio de Agricultura, Pesca y Alimentación (MAPA), se proporcionan en series anuales (utilizaremos las series anuales desde el 2010 hasta el 2021)
Series anuales datos de consumo alimentario en hogares
Estos conjuntos de datos también se encuentran disponibles para su descarga en el siguiente repositorio de GitHub.
Volver al inicio
3.2. Herramientas
Para la realización de las tareas de preprocesado de los datos se ha utilizado el lenguaje de programación Python escrito sobre un Notebook de Jupyter alojado en el servicio en la nube de Google Colab.
"Google Colab" o, también llamado Google Colaboratory, es un servicio en la nube de Google Research que permite programar, ejecutar y compartir código escrito en Python o R sobre un Jupyter Notebook desde tu navegador, por lo que no requiere configuración. Este servicio es gratuito.
Para la creación del cuadro de mando se ha utilizado la herramienta Looker Studio.
"Looker Studio" antiguamente conocido como Google Data Studio, es una herramienta online que permite realizar cuadros de mandos interactivos que pueden insertarse en sitios web o exportarse como archivos. Esta herramienta es sencilla de usar y permite múltiples opciones de personalización.
Si quieres conocer más sobre herramientas que puedan ayudarte en el tratamiento y la visualización de datos, puedes recurrir al informe "Herramientas de procesado y visualización de datos".
Volver al inicio
4. Tratamiento o preparación de los datos
Los procesos que te describimos a continuación los encontrarás comentados en el siguiente Notebook que podrás ejecutar desde Google Colab.
Antes de lanzarnos a construir una visualización efectiva, debemos realizar un tratamiento previo de los datos, prestando especial atención a su obtención y a la validación de su contenido, asegurándonos que se encuentran en el formato adecuado y consistente para su procesamiento y que no contienen errores.
Como primer paso del proceso, una vez cargados los conjuntos de datos iniciales, es necesario realizar un análisis exploratorio de los datos (EDA) con el fin de interpretar adecuadamente los datos de partida, detectar anomalías, datos ausentes o errores que pudieran afectar a la calidad de los procesos posteriores y resultados. Si quieres conocer más sobre este proceso puedes recurrir a la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
El siguiente paso es generar la tabla de datos preprocesada que usaremos para alimentar la herramienta de visualización (Looker Studio). Para ello modificaremos, filtraremos y uniremos los datos según nuestras necesidades.
Los pasos que se siguen en este preprocesamiento de los datos, explicados en el siguiente Notebook de Google Colab, son los siguientes:
Instalación de librerías y carga de los conjuntos de datos
Análisis exploratorio de los datos (EDA)
Generación de tablas preprocesadas
Podrás reproducir este análisis con el código fuente que está disponible en nuestra cuenta de GitHub. La forma de proporcionar el código es a través de un documento realizado sobre un Jupyter Notebook que una vez cargado en el entorno de desarrollo podrás ejecutar o modificar de manera sencilla. Debido al carácter divulgativo de este post y para favorecer el entendimiento de los lectores no especializados, el código no pretende ser el más eficiente, sino facilitar su comprensión por lo que posiblemente se te ocurrirán muchas formas de optimizar el código propuesto para lograr fines similares. ¡Te animamos a que lo hagas!
Volver al inicio
5. Visualización del cuadro de mandos interactivo
Una vez hemos realizado el preprocesamiento de los datos, vamos con la generación del cuadro de mandos. Un cuadro de mandos es una herramienta visual que proporciona una visión resumida de los datos y métricas clave. Es útil para el monitoreo, la toma de decisiones y la comunicación efectiva, al proporcionar una vista clara y concisa de la información relevante.
Para la realización de las visualizaciones interactivas que componen el cuadro de mando se ha usado la herramienta Looker Studio. Al ser una herramienta online, no es necesario tener instalado un software para interactuar o generar cualquier visualización, pero sí se necesita que la tabla de datos que le proporcionamos esté estructurada adecuadamente, razón por la que hemos realizado los pasos anteriores relativos al preprocesamiento de los datos. Si quieres saber más sobre cómo utilizar Looker Studio, en el siguiente enlace puedes acceder a formación sobre el uso de la herramienta.
El cuadro de mandos se puede abrir en una nueva pestalla en el siguiente link. En los próximos apartados desglosaremos cada uno de los componentes que lo integran.
5.1. Filtros
Los filtros en un cuadro de mando son opciones de selección que permiten visualizar y analizar datos específicos mediante la aplicación de varios criterios de filtrado a los conjuntos de datos presentados en el panel de control. Ayudan a enfocarse en información relevante y a obtener una visión más precisa de los datos.
Figura 1. Filtros del cuadro de mando
Los filtros incluidos en el cuadro de mando generado permiten elegir el tipo de análisis a mostrar, el territorio o Comunidad Autónoma, la categoría de alimentos y los años de la muestra.
También incorpora diversos botones para facilitar el borrado de los filtros elegidos, descargar el cuadro de mandos como un informe en formato PDF y acceder a los datos brutos con los que se ha elaborado este cuadro de mando.
5.2. Visualizaciones interactivas
El cuadro de mandos está compuesto por diversos tipos de visualizaciones interactivas, que son representaciones gráficas de datos que permiten a los usuarios explorar y manipular la información de forma activa.
A diferencia de las visualizaciones estáticas, las visualizaciones interactivas brindan la capacidad de interactuar con los datos, permitiendo a los usuarios realizar diferentes e interesantes acciones como hacer clic en elementos, arrastrarlos, ampliar o reducir el enfoque, filtrar datos, cambiar parámetros y ver los resultados en tiempo real.
Esta interacción es especialmente útil cuando se trabaja con conjuntos de datos grandes y complejos, pues facilitan a los usuarios el examen de diferentes aspectos de los datos así como descubrir patrones, tendencias y relaciones de una manera más intuitiva.
De cara a la definición de cada tipo de visualización, nos hemos basado en la guía de visualización de datos para entidades locales presentada por la RED de Entidades Locales por la Transparencia y Participación Ciudadana de la FEMP.
5.2.1 Tabla de datos
Las tablas de datos permiten la presentación de una gran cantidad de datos de forma organizada y clara, con un alto rendimiento de espacio/información.
Sin embargo, pueden dificultar la presentación de patrones o interpretaciones respecto a otros objetos visuales de carácter más gráfico.
Figura 2. Tabla de datos del cuadro de mando
5.2.2 Mapa de cloropetas
Se trata de un mapa en el que se muestran datos numéricos por territorios marcando con intensidad de colores diferentes las distintas áreas. Para su elaboración se requiere de una medida o dato numérico, un dato categórico para el territorio y un dato geográfico para delimitar el área de cada territorio.
Figura 3. Mapa de cloropetas del cuadro de mando
5.2.3 Gráfico de sectores
Se trata de un gráfico que muestra los datos a partir de unos ejes polares en los que el ángulo de cada sector marca la proporción de una categoría respecto al total. Su funcionalidad es mostrar las diferentes proporciones de cada categoría respecto a un total utilizando gráficos circulares.
Figura 4. Gráfico de sectores del cuadro de mando
5.2.4 Gráfico de líneas
Se trata de un gráfico que muestra la relación entre dos o más medidas de una serie de valores en dos ejes cartesianos, reflejando en el eje X una dimensión temporal, y una medida numérica en el eje Y. Estos gráficos son idóneos para representar series de datos temporales con un elevado número de puntos de datos u observaciones.
Figura 5. Gráfico de lineas del cuadro de mando
5.2.5 Gráfico de barras
Se trata de un gráfico de los más utilizados por la claridad y simplicidad de preparación. Facilita la lectura de valores a partir de la proporción de la longitud de las barras. El gráfico muestra los datos mediante un eje que representa los valores cuantitativos y otro que incluye los datos cualitativos de las categorías o de tiempo.
Figura 6. Gráfico de barras del cuadro de mando
5.2.6 Gráfico de jerarquías
Se trata de un gráfico formado por distintos rectángulos que representan categorías, y que permite agrupaciones jerárquicas de los sectores de cada categoría. La dimensión de cada rectángulo y su colocación varía en función del valor de la medida de cada una de las categorías que se muestran respecto del valor total de la muestra.
Figura 7. Gráfico de jerarquías del cuadro de mando
6. Conclusiones del ejercicio
Los cuadros de mando son uno de los mecanismos más potentes para explotar y analizar el significado de los datos. Cabe destacar la importancia que nos ofrecen a la hora de monitorear, analizar y comunicar datos e indicadores de una manera clara, sencilla y efectiva.
Como resultado, hemos podido responder a las preguntas originalmente planteadas:
La tendencia del consumo per cápita se encuentra en disminución desde el 2013, año en el que llegó a su máximo, con un pequeño repunte en los años 2020 y 2021.
La tendencia del gasto per cápita se ha mantenido estable desde el 2011 hasta que en 2020 ha sufrido una subida del 17,7% pasando de ser el gasto medio anual de 1052 euros a 1239 euros, produciéndose una leve disminución del 4,4% de los datos del 2020 a los del 2021.
Los tres alimentos más consumidos durante todos los años analizados son: frutas frescas, leche líquida y carne (valores en kgs)
Las Comunidades Autónomas donde el gasto per cápita es mayor son País Vasco, Cataluña y Asturias, mientras que Castilla la Mancha, Andalucía y Extremadura son las que menos gasto tienen.
Las Comunidad Autónomas donde un mayor consumo per cápita se produce son Castilla y León, Asturias y País Vasco, mientras que en las que menor son: Extremadura, Canarias y Andalucía.
También hemos podido observar ciertos patrones interesantes, como un aumento de un 17,33% en el consumo de alcohol (cervezas, vino y bebidas espirituosas) en los años 2019 y 2020 .
Puedes utilizar los distintos filtros para averiguar y buscar más tendencias o patrones en los datos según tus intereses e inquietudes.
Esperemos que esta visualización paso a paso te haya resultado útil para el aprendizaje de algunas técnicas muy habituales en el tratamiento y representación de datos abiertos. Volveremos para mostraros nuevas reutilizaciones. ¡Hasta pronto!
Medio ambiente
Ciencia e tecnoloxía
1. Introducción
Las visualizaciones son representaciones gráficas de datos que permiten comunicar de manera sencilla y efectiva la información ligada a los mismos. Las posibilidades de visualización son muy amplias, desde representaciones básicas, como puede ser un gráfico de líneas, barras o sectores, hasta visualizaciones configuradas sobre cuadros de mando o dashboards interactivos.
En esta sección de “Visualizaciones paso a paso” estamos presentando periódicamente ejercicios prácticos de visualizaciones de datos abiertos disponibles en datos.gob.es u otros catálogos similares. En ellos se abordan y describen de manera sencilla las etapas necesarias para obtener los datos, realizar las transformaciones y análisis que resulten pertinentes para, finalmente, la creación de visualizaciones interactivas, de las que podemos extraer información resumida en unas conclusiones finales. En cada uno de estos ejercicios prácticos, se utilizan sencillos desarrollos de código convenientemente documentados, así como herramientas de uso gratuito. Todo el material generado está disponible para su reutilización en el repositorio Laboratorio de datos de GitHub.
A continuación, puedes acceder al material que utilizaremos en el ejercicio y que iremos explicando y desarrollando en los siguientes apartados de este post.
Accede al repositorio del laboratorio de datos en GitHub
Accede al notebook de Google Colab
2. Objetivo
El objetivo principal de este ejercicio es hacer un análisis de los datos meteorológicos recogidos en varias estaciones durante los últimos años. Para realizar este análisis utilizaremos distintas visualizaciones generadas mediante la librería “ggplot2” del lenguaje de programación “R”
De todas las estaciones meteorológicas españolas, hemos decidido analizar dos de ellas, una en la provincia más fría del país (Burgos) y otra en la provincia más cálida del país (Córdoba), según los datos de la AEMET. Se buscarán patrones y tendencias en los distintos registros entre los años 1990 y 2020 con el objetivo de entender la evolución meteorológica sufrida en este periodo de tiempo.
Una vez analizados los datos, podremos contestar a preguntas como las que se muestran a continuación:
¿Cuál es la tendencia en la evolución de las temperaturas en los últimos años?
¿Cuál es la tendencia en la evolución de las precipitaciones en los últimos años?
¿Qué estación meteorológica (Burgos o Córdoba) presenta una mayor variación de los datos climatológicos en estos últimos años?
¿Qué grado de correlación hay entre las distintas variables climatológicas registradas?
Estas, y muchas otras preguntas pueden ser resueltas mediante el uso de herramientas como ggplot2 que facilitan la interpretación de los datos mediante visualizaciones interactivas.
Volver al inicio
3. Recursos
3.1. Conjuntos de datos
Los conjuntos de datos contienen distinta información meteorológica de interés para las dos estaciones en cuestión desglosada por año. Dentro del centro de descargas de la AEMET, podremos descárgalos, previa solicitud de la clave API, en el apartado “climatologías mensuales/anuales”. De las estaciones meteorológicas existentes, hemos seleccionado dos de las que obtendremos los datos: Burgos aeropuerto (2331) y Córdoba aeropuerto (5402)
Cabe destacar, que, junto a los conjuntos de datos, también podremos descargar sus metadatos, los cuales son de especial importancia a la hora de identificar las distintas variables registradas en los conjuntos de datos.
Estos conjuntos de datos también se encuentran disponibles en el repositorio de GitHub
Volver al inicio
3.2. Herramientas
Para la realización de las tareas de preprocesado de los datos se ha utilizado el lenguaje de programación R escrito sobre un Notebook de Jupyter alojado en el servicio en la nube de Google Colab.
"Google Colab" o, también llamado Google Colaboratory, es un servicio en la nube de Google Research que permite programar, ejecutar y compartir código escrito en Python o R sobre un Jupyter Notebook desde tu navegador, por lo que no requiere configuración. Este servicio es gratuito.
Para la creación de las visualizaciones se ha usado la librería ggplot2.
"ggplot2" es un paquete de visualización de datos para el lenguaje de programación R. Se centra en la construcción de gráficos a partir de capas de elementos estéticos, geométricos y estadísticos. ggplot2 ofrece una amplia gama de gráficos estadísticos de alta calidad, incluyendo gráficos de barras, gráficos de líneas, diagramas de dispersión, gráficos de caja y bigotes, y muchos otros
Si quieres conocer más sobre herramientas que puedan ayudarte en el tratamiento y la visualización de datos, puedes recurrir al informe "Herramientas de procesado y visualización de datos".
Volver al inicio
4. Tratamiento o preparación de los datos
Los procesos que te describimos a continuación los encontrarás comentados en el Notebook que también podrás ejecutar desde Google Colab.
Antes de lanzarnos a construir una visualización efectiva, debemos realizar un tratamiento previo de los datos, prestando especial atención a la obtención de los mismos y validando su contenido, asegurando que se encuentran en el formato adecuado y consistente para su procesamiento y que no contienen errores.
Como primer paso del proceso, una vez importadas las librerías necesarias y cargados los conjuntos de datos, es necesario realizar un análisis exploratorio de los datos (EDA) con el fin de interpretar adecuadamente los datos de partida, detectar anomalías, datos ausentes o errores que pudieran afectar a la calidad de los procesos posteriores y resultados. Si quieres conocer más sobre este proceso puedes recurrir a la Guía Práctica de Introducción al Análisis Exploratorio de Datos.
El siguiente paso a dar es generar las tablas de datos preprocesadas que usaremos en las visualizaciones. Para ello, filtraremos los conjuntos de datos iniciales y calcularemos los valores que sean necesarios y de interés para el análisis realizado en este ejercicio.
Una vez terminado el preprocesamiento, obtendremos las tablas de datos “datos_graficas_C” y “datos_graficas_B” las cuales utilizaremos en el siguiente apartado del Notebook para generar las visualizaciones.
La estructura del Notebook en la que se realizan los pasos previamente descritos junto a comentarios explicativos de cada uno de ellos, es la siguiente:
Instalación y carga de librerías
Carga de los conjuntos de datos
Análisis exploratorio de datos (EDA)
Preparación de las tablas de datos
Visualizaciones
Guardado de gráficos
Podrás reproducir este análisis, ya que el código fuente está disponible en nuestra cuenta de GitHub. La forma de proporcionar el código es a través de un documento realizado sobre un Jupyter Notebook que una vez cargado en el entorno de desarrollo podrás ejecutar o modificar de manera sencilla. Debido al carácter divulgativo de este post y de cara a favorecer el entendimiento de los lectores no especializados, el código no pretende ser el más eficiente, sino facilitar su comprensión por lo que posiblemente se te ocurrirán muchas formas de optimizar el código propuesto para lograr fines similares. ¡Te animamos a que lo hagas!
Volver al inicio
5. Visualizaciones
Diversos tipos de visualizaciones y gráficos se han realizado con la finalidad de extraer información sobre las tablas de datos preprocesadas y responder a las preguntas iniciales planteadas en este ejercicio. Como se ha mencionado previamente, se ha utilizado el paquete “ggplot2” de R para realizar las visualizaciones.
El paquete "ggplot2" es una biblioteca de visualización de datos en el lenguaje de programación R. Fue desarrollado por Hadley Wickham y es parte del conjunto de herramientas del paquete "tidyverse". El paquete "ggplot2" está construido en torno al concepto de "gramática de gráficos", que es un marco teórico para construir gráficos mediante la combinación de elementos básicos de la visualización de datos como capas, escalas, leyendas, anotaciones y temas. Esto permite crear visualizaciones de datos complejas y personalizadas, con un código más limpio y estructurado.
Si quieres tener una visión a modo resumen de las posibilidades de visualizaciones con ggplot2, consulta la siguiente “cheatsheet”. También puedes obtener información más en detalle en el siguiente "manual de uso".
5.1. Gráficos de líneas
Los gráficos de líneas son una representación gráfica de datos que utiliza puntos conectados por líneas para mostrar la evolución de una variable en una dimensión continua, como el tiempo. Los valores de la variable se representan en el eje vertical y la dimensión continua en el eje horizontal. Los gráficos de líneas son útiles para visualizar tendencias, comparar evoluciones y detectar patrones.
A continuación, podemos visualizar varios gráficos de líneas con la evolución temporal de los valores de temperaturas medias, mínimas y máximas de las dos estaciones meteorológicas analizadas (Córdoba y Burgos). Sobre estos gráficos, hemos introducido líneas de tendencia para poder observar de forma visual y sencilla su evolución.
Para poder comparar las evoluciones, no solamente de manera visual mediante las líneas de tendencia graficadas, sino también de manera numérica, obtenemos los coeficientes de pendiente de la recta de tendencia, es decir, el cambio en la variable respuesta (tm_ mes, tm_min, tm_max) por cada unidad de cambio en la variable predictora (año).
Coeficiente de pendiente temperatura media Córdoba: 0.036
Coeficiente de pendiente temperatura media Burgos: 0.025
Coeficiente de pendiente temperatura mínima Córdoba: 0.020
Coeficiente de pendiente temperatura mínima Burgos: 0.020
Coeficiente de pendiente temperatura máxima Córdoba: 0.051
Coeficiente de pendiente temperatura máxima Burgos: 0.030
Podemos interpretar que cuanto mayor es este valor, más abrupta es la subida de temperatura media en cada periodo observado.
Por últimos, hemos creado un gráfico de líneas para cada estación meteorológica, en el que visualizamos de forma conjunta la evolución de las temperaturas medias, mínimas y máximas a lo largo de los años.
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Las temperaturas medias, mínimas y máximas anuales registradas en Córdoba y Burgos tienen una tendencia en aumento.
El aumento más significativo se observa en la evolución de las temperaturas máximas de Córdoba (coeficiente de pendiente = 0.051)
El aumento más tenue se observa en la evolución de las temperaturas mínimas, tanto de Córdoba cómo de Burgos (coeficiente de pendiente = 0.020)
5.2. Gráficos de barras
Los gráficos de barras son una representación gráfica de datos que utiliza barras rectangulares para mostrar la magnitud de una variable en diferentes categorías o grupos. La altura o longitud de las barras representa la cantidad o frecuencia de la variable y las categorías se representan en el eje horizontal. Los gráficos de barras son útiles para comparar la magnitud de diferentes categorías y para visualizar diferencias entre ellas.
Hemos generado dos gráficos de barras con los datos correspondientes a la precipitación total acumulada por año para las distintas estaciones meteorológicas.
Al igual que en el apartado anterior, graficamos la línea de tendencia y calculamos el coeficiente de pendiente.
Coeficiente de pendiente precipitaciones acumuladas Córdoba: -2.97
Coeficiente de pendiente precipitaciones acumuladas Burgos: -0.36
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Las precipitaciones acumuladas anuales tienen una tendencia en descenso tanto para Córdoba como para Burgos.
La tendencia de descenso es mayor para Córdoba (coeficiente = -2.97), siendo más moderada para Burgos (coeficiente = -0.36)
5.3. Histogramas
Los histogramas son una representación gráfica de una distribución de frecuencia de datos numéricos en un intervalo de valores. El eje horizontal representa los valores de los datos divididos en intervalos, llamados "bin", y el eje vertical representa la frecuencia o la cantidad de datos que se encuentran en cada "bin". Los histogramas son útiles para identificar patrones en los datos, como su distribución, dispersión, simetría o sesgo.
Hemos generado dos histogramas con las distribuciones de los datos correspondientes a la precipitación total acumulada por año para las distintas estaciones meteorológicas, siendo los intervalos elegidos de 50 mm3.
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Los registros de precipitación acumulada anual en Burgos presentan una distribución cercana a una distribución normal y simétrica.
Los registros de precipitación acumulada anual en Córdoba no presentan una distribución simétrica.
5.4. Diagramas de cajas y bigotes
Los diagramas de cajas y bigotes, son una representación gráfica de la distribución de un conjunto de datos numéricos. Estos gráficos representan la mediana, el rango intercuartílico y los valores mínimo y máximo de los datos. La caja del gráfico representa el rango intercuartílico, es decir, el rango entre el primer y tercer cuartil de los datos. Los puntos fuera de la caja, llamados valores atípicos, pueden indicar valores extremos o datos anómalos. Los diagramas de cajas son útiles para comparar distribuciones y detectar valores extremos en los datos.
Hemos generado un gráfico con los diagramas de cajas correspondientes a los datos de precipitaciones acumuladas de las estaciones meteorológicas.
De cara a entender el gráfico, hay que destacar los siguientes puntos:
Los límites de la caja indican el primer y el tercer cuartil (Q1 y Q3), que dejan por debajo de cada uno, el 25% y el 75% de los datos respectivamente.
La línea horizontal dentro de la caja es la mediana (equivalente al segundo cuartil Q2), que deja por debajo la mitad de los datos.
Los límites de los bigotes son los valores extremos, es decir, el valor mínimo y el valor máximo de la serie de datos.
Los puntos fuera de los bigotes son los valores atípicos (outliers)
Las principales conclusiones obtenidas de la visualización de este apartado son:
Ambas distribuciones presentan 3 valores extremos, siendo significativos los de Córdoba con valores superiores a 1000 mm3.
Los registros de Córdoba tienen una mayor variabilidad que los de Burgos, los cuales se presentan más estables.
5.5. Gráficos de sectores
Un gráfico de sectores es un tipo de gráfico circular que representa proporciones o porcentajes de un todo. Se compone de varias secciones o sectores, donde cada sector representa una proporción de la totalidad del conjunto. El tamaño del sector se determina en función de la proporción que representa, y se expresa en forma de ángulo o porcentaje. Es una herramienta útil para visualizar la distribución relativa de las diferentes partes de un conjunto y facilita la comparación visual de las proporciones entre los distintos grupos.
Hemos generamos dos gráficos de sectores (polares). El primero de ellos con el número de días que los valores superan los 30º en Córdoba y el segundo de ellos con el número de días que los valores bajan de los 0º en Burgos.
Para la realización de estos gráficos, hemos agrupado la suma del número de días anteriormente descrito en seis grupos, correspondientes a periodos de 5 años desde 1990 hasta el 2020.
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Se da un aumento del 31,9% en el total de días anuales con temperaturas superiores a 30º en Córdoba para el periodo comprendido entre el 2015-2020 respecto al periodo 1990-1995.
Se da un aumento del 33,5% en el total de días anuales con temperaturas superiores a 30º en Burgos para el periodo comprendido entre el 2015-2020 respecto al periodo 1990-1995.
5.6. Gráficos de dispersión
Los gráficos de dispersión son una herramienta de visualización de datos que representan la relación entre dos variables numéricas mediante la ubicación de puntos en un plano cartesiano. Cada punto representa un par de valores de las dos variables y su posición en el gráfico indica cómo se relacionan entre sí. Los gráficos de dispersión se utilizan comúnmente para identificar patrones y tendencias en los datos, así como para detectar cualquier posible correlación entre las variables. Estos gráficos también pueden ayudar a identificar valores atípicos o datos que no encajan con la tendencia general.
Hemos generado dos gráficas de dispersión en las que se comparan los valores de temperaturas medias máximas y medias mínimas buscando tendencias de correlación entre ambas para los valores cada estación meteorológica.
Para poder analizar las correlaciones, no solamente de manera visual mediante las gráficas, sino también de manera numérica, obtenemos los coeficientes de correlación de Pearson. Este coeficiente es una medida estadística que indica el grado de asociación lineal entre dos variables cuantitativas. Se utiliza para evaluar si existe una relación lineal positiva (ambas variables aumentan o disminuyen simultáneamente a un ritmo constante), negativa (los valores de ambas variables varían de forma contraria) o nula (sin relación) entre dos variables y la fortaleza de dicha relación, cuanto más cerca de +1, más alta es su asociación.
Coeficiente de Pearson (Temperatura media max VS min) Córdoba: 0.15
Coeficiente de Pearson (Temperatura media max VS min) Burgos: 0.61
En la imagen observamos que mientras en Córdoba se aprecia una mayor dispersión, en Burgos se observa una mayor correlación.
A continuación, modificaremos las gráficas de dispersión anteriores para que nos aporten más información de forma visual. Para ello dividimos el espacio por sectores de colores (rojo con valores de temperatura más altos/ azul valores de temperatura más bajos) y mostramos en las distintas burbujas la etiqueta con el año correspondiente. Cabe destacar que los límites de cambio de color de los cuadrantes corresponden con los valores medios de cada una de las variables.
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Existe una relación lineal positiva entre la temperatura media máxima y mínima tanto en Córdoba como en Burgos, siendo mayor esta correlación en los datos de Burgos.
Los años que presentan valores más elevados de temperaturas máximas y mínimas en Burgos son (2003, 2006 y 2020)
Los años que presentan valores más elevados de temperaturas máximas y mínimas en Córdoba son (1995, 2006 y 2020)
5.7. Matriz de correlación
La matriz de correlación es una tabla que muestra las correlaciones entre todas las variables en un conjunto de datos. Es una matriz cuadrada que muestra la correlación entre cada par de variables en una escala que va de -1 a 1. Un valor de -1 indica una correlación negativa perfecta, un valor de 0 indica que no hay correlación y un valor de 1 indica una correlación positiva perfecta. La matriz de correlación se utiliza comúnmente para identificar patrones y relaciones entre variables en un conjunto de datos, lo que puede ayudar a comprender mejor los factores que influyen en un fenómeno o resultado.
Hemos generado dos mapas de calor con los datos de las matrices de correlación para ambas estaciones meteorológicas.
Las principales conclusiones obtenidas de las visualizaciones de este apartado son:
Existe una fuerte correlación negativa (- 0.42) para Córdoba y (-0.45) para Burgos entre el número de días anuales con temperaturas superiores a 30º y las precipitaciones acumuladas. Esto quiere decir que conforme aumenta el número de días con temperaturas superiores a 30º disminuyen notablemente las precipitaciones.
6. Conclusiones del ejercicio
La visualización de datos es uno de los mecanismos más potentes para explotar y analizar el significado implícito de los datos. Como hemos observado en este ejercicio, "ggplot2" se trata de una potente librería capaz de representar una grán variedad de gráficos con un alto grado de personalización que permite ajustar numerosas caracteristicas propias de cada gráfico.
Una vez analizadas las visualizaciones anteriores, podemos concluir que tanto para la estación meteorológica de Burgos, como la de Córdoba, las temperaturas (mínimas, medias, máximas) han sufrido un aumento considerable, los días con calor extremo ( Tº > 30º) también lo han sufrido y las precipitaciones han disminuido en el periodo de tiempo analizado, desde 1990 hasta el 2020.
Esperemos que esta visualización paso a paso te haya resultado útil para el aprendizaje de algunas técnicas muy habituales en el tratamiento, representación e interpretación de datos abiertos. Volveremos para mostraros nuevas reutilizaciones. ¡Hasta pronto!